研究科学性
使用看似科学的方法,不保证研究问题重要、检验严格或结论可推广。
Some of the Time:科学验证、早期设计与文化采用的三重方法论边界
Saul Greenberg · Bill Buxton
这篇文章并不主张停止 usability evaluation。它反对把某一种评价,当作所有研究、所有设计阶段和所有创新的必经认证仪式。真正的要求是:先说明要回答什么,再选择能为这个问题提供证据的方法。
Saul Greenberg 与 Bill Buxton 的 CHI 2008 批评论文发表于 111–120 页,DOI 为 10.1145/1357054.1357074。本文使用固定的 10 页会议版本,作者网站版本虽然 PDF 字节不同,但逐页抽取的全部正文一致;不混入 2007 技术报告。
「Some of the Time」不是可省略的副标题。作者明确承认可用性评估对于修复交互问题、验收需求、比较成熟方案经常很有价值;论文批判的是不考虑目的、成熟度与使用文化的机械应用。若把本文当成「没有用户研究也永远不必解释」的理由,就与结论直接冲突。
使用看似科学的方法,不保证研究问题重要、检验严格或结论可推广。
把探索性草图当成完成品测试,可能扼杀方向或把团队锁在局部改良中。
短期任务表现,不能自动预测新技术日后如何被社会采用与重塑。
文献类型:概念分析与规范性论证。没有新招募的实验被试、训练模型、基准排行榜或定量消融;经验素材来自既有文献、作者经历、设计图示与历史案例。下面区分 Paper Verified(原文确实写到)、Author Claim(作者主张)、Our Interpretation(本页解释)与 Research Extension(后续设想)。
原文限定的 usability evaluation 主要包括实验室用户观察、受控用户实验,以及 inspection techniques 等常见检查方法。通常考察用户执行一个或多个任务时的有效性、效率和满意度。它并未将所有可能的「评价」都否定,更不把设计批评、实地理解、反思或文化探查排除在知识生产之外。
| 场景 | 适当的问题 | 可能得到的证据 | 不能自动推出 |
|---|---|---|---|
| 产品迭代 | 用户在哪里失败或困惑? | 问题清单、严重程度、下一轮修复重点 | 当前产品方向一定值得做 |
| 验收 | 规定任务的表现是否达到标准? | 时间、错误、满意度与预设阈值的对照 | 用户将长期采用或喜欢全部功能 |
| 采购/方案比较 | 两种成熟工具哪种更适合明确工作? | 同任务、同条件下的比较 | 在所有未来任务上都优越 |
| 研究验证 | 新技术在指定条件下改善什么? | 明确条件与指标内的结果 | 已经形成普遍规律或完整科学解释 |
Author Claim:以上压力共同促进了方法偏好。Reviewer:作者的委员会经历与教学观察没有被系统抽样;论文没有测量三种制度因素分别造成多大影响,因此应读为有经验支撑的诊断,而非已识别因果效应。
方法工具箱的初衷,是让研究者按照具体问题、成本与所需证据选择方法。作者担心实际顺序倒置:先认定受控定量实验最容易被接受,再寻找适合该实验的问题,或只突出复杂问题中方便测量的小部分。
例如,一个协作工具真正的问题可能是组织是否愿意持续使用、角色责任怎样改变。但研究者若只会比较完成按钮点击所需时间,就可能将「工作是否变好」缩减成「某操作是否快一点」。不是时间指标无效,而是它可能回答了另一个较窄的问题。
本页形式化解释,非原文公式:设研究问题为 \(Q\),方法为 \(M\),证据为 \(E\),欲支持的主张为 \(C\)。合理链条是从 \(Q\) 选择 \(M\),获得 \(E\),再限制 \(C\) 的范围;不能因 \(M\) 被偏爱,就改造 \(Q\) 以迎合发表。
\[ Q\longrightarrow M\longrightarrow E\longrightarrow C. \]这一图式不是算法、评分函数或训练目标;它帮助检查论证顺序。选择方法时还需考虑可行性与伦理,论文也没有宣称每个问题都存在唯一正确的方法。
| 原文位置 | 数字 | 来源/作用 | 限制 |
|---|---|---|---|
| p.113 方法偏好段 | 约 70% 定量经验可用性评估;约 25% 定性可用性评估 | 引述 Barkhuus 与 Rode 对 CHI 的分析 | 本论文未给完整分类表、样本分母或重算数据,不能自行补剩余 5% |
| p.114 客观/主观段 | 再次说 70%,并把定性称作其余 30% | 同一议论中的概括 | 与此前约 25% 表述不完全一致;保留差异,不伪装为严格一致的统计 |
| p.119 CSCW 相关工作 | 近 1/3 未正式评价;约 1/4 包含真实场景评价 | 引述 Pinelle 与 Gutwin 对 1990–1998 CSCW 的回顾 | 不是本文新收集的数据,也不是所有 HCI 系统的比例 |
| p.112 会议经历 | 作者合计约五十年经验 | 说明批评来自长期参与 | 不是研究样本量,不能据此计算统计置信度 |
第 3–4 页:The Method Forms the Research Question · 第 9 页:相关工作比例
创新原型常被放在对自己最有利的任务、场景与指标下测试,只为证明「至少有一个场景比旧方案好」。作者称这种评价为 existence proof。它确实回答了一个可行性问题,却不足以支持「新技术普遍更好」的宽主张。
| 策略 | 主要问题 | 典型安排 | 证据范围 |
|---|---|---|---|
| Existence proof | 至少在某处是否有价值? | 选取有利、可实现的示范条件 | 支持可能性;不说明适用边界 |
| Risky hypothesis testing | 在容易推翻它的条件下还能成立吗? | 挑战性任务、较强替代解释、边界与失败条件 | 若仍成立,主张获得更有力支持 |
| Replication | 先前发现可靠吗,在哪些条件下改变? | 重做原条件,或改变情境以检验边界 | 纠错、稳健性与限制条件 |
重要细节:作者并未全面否认 existence proof。建议部分明确说,非常新颖的创新可以先用存在证明;对主流系统或已有想法的微小变体,则更应采用冒险检验。证据要求随主张与成熟度变化,不能一刀切。
论文描述一个悖论:首先要求有评估才能发表,但初次评估通常偏确认性;随后又以「已经做过」拒绝复现,恰恰把更严格挑战原主张的机会排除。对陌生技术,评审还可能把细微但重要的变化看成同一件事,要求巨大效果;对熟悉的菜单方案,却能接受很小差异。
Reviewer:这是一种出版激励机制的假说,本文没有审稿文本编码、录用率分析或实验来估计其强度。它的实践价值是提醒研究者预先写清哪项主张可以被什么结果推翻、哪些材料可供复现,并提醒评审评价新增证据而不仅追逐表面新颖性。
作者认为,定量数字给人一种摆脱主观性的安心感;定性观察也会以事实约束解释。但若因此拒绝设计者的经验、论据、反思与直觉,研究共同体就只允许一种形式的有效理由。
本文借用建筑设计中 assessor 的讨论:专业判断并不必然随意,它受到训练、实践、共享价值、隐含规范与共同体质询的约束。设计批评可以要求清楚说明选择理由、情境、替代方案与预期效果;不能因为结果不是一个数,就宣布它没有严谨性。
Author Claim:专家反思与主观论证应有合法地位。Reviewer:「合法」不意味着任何意见都与实验数据等强,也不意味着资历可以替代论证。专家共同体同样可能有偏见、权力不平等与排他性;本文没有提出怎样量化或校正这些问题的完整方案。
读者应避免把文中客观/主观、科学/设计的修辞二分当成严格的方法分类。例如,民族志和案例研究也可以系统收集经验材料;design critique 中也能引用可观察证据。更有用的区分是:当前主张需要什么推理,证据怎样被检查,谁的经验被纳入,结论允许走多远。
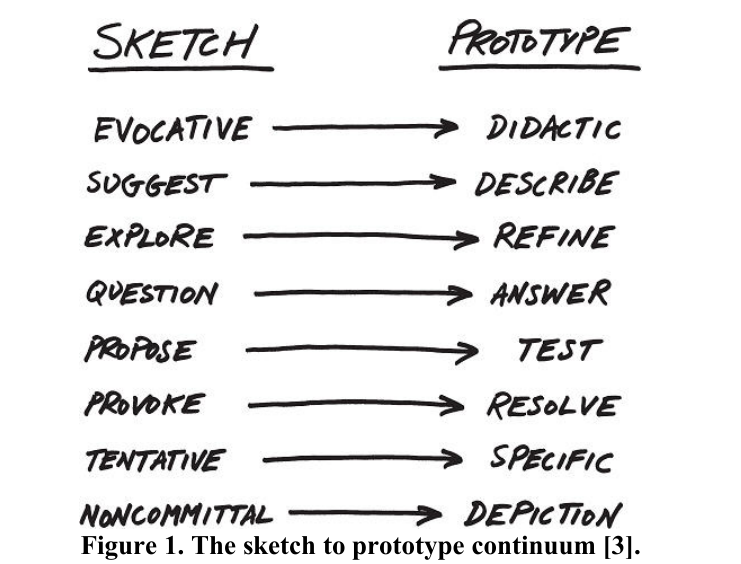
Sketch 不是简单地指纸张;视频、互动幻灯片甚至可运行系统也可以是草图。关键是它是否用来把尚未确定的想法外化、探索问题和发现替代方向。Prototype 则更接近对一个已选择方向的具体实现,用于检验与细化。
| 原 Figure 1 左端 | 右端 | 本页解释 |
|---|---|---|
| Evocative | Didactic | 唤起联想,走向明确传达 |
| Suggest | Describe | 提出可能性,走向描述具体方案 |
| Explore | Refine | 探索空间,走向细化选定方案 |
| Question | Answer | 生成问题,走向回答问题 |
| Propose | Test | 提出方向,走向检验方向 |
| Provoke | Resolve | 引出思考,走向解决未决问题 |
| Tentative | Specific | 暂定,走向具体 |
| Noncommittal | Depiction | 原手写图词项保留;强调开放设想与具体呈现之间的变化 |
这张图画的是连续关系,不是八项二分类评分表,也没有给出从 sketch 转为 prototype 的数值阈值。图源为作者引用的 Buxton 著作,本文将它用于解释评价对象容易被误识别的机制。
Our Interpretation:视觉精致度或系统能否运行,并不能替代成熟度声明。研究演示应明确「本次想检验哪种潜力」「哪些交互只是暂时占位」,同时诚实承认这些占位对评价的影响;不能事后把所有负面结果都归为原型不成熟。
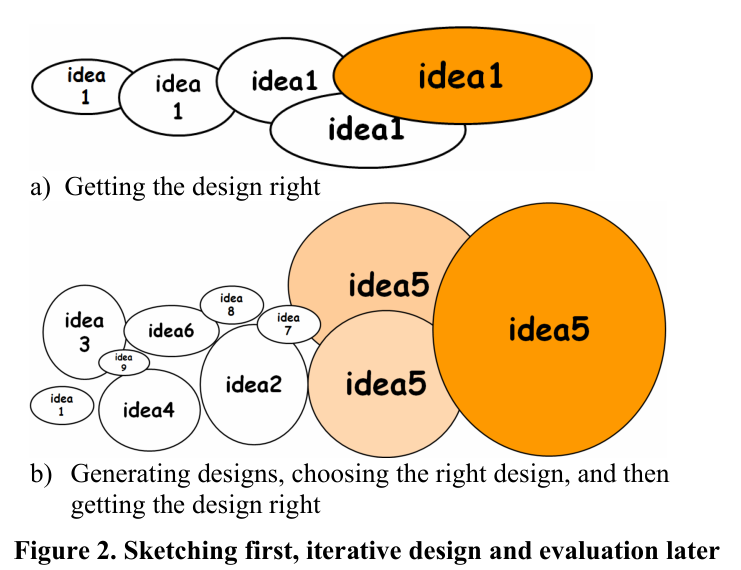
Figure 2a 描绘沿一个方向不断迭代,Figure 2b 先生成多个设计,再选择和细化。Getting the Design Right 关注选定方案内部的修复;Getting the Right Design 关注选择哪个方向。作者借用 local hill climbing 比喻前者可能陷入局部改进。
这里的局部/全局极值是解释性比喻,论文没有定义可计算的设计空间、目标函数或最优算法。多画草图也不保证找到全局最优;它的作用是延后承诺,让替代选项进入讨论。
作者进一步指出,think-aloud、task-centered walkthrough、heuristic evaluation 常以发现问题为主要产出。问题比潜在收益更容易被清点,若决策只数 bug,就可能低估粗糙但有用的新方向。评价应关注成本和收益,但本文没有提出二者的统一计量单位或权重。
Reviewer:这是对机械串行迭代的批评,不是规定所有项目都必须完成一次永久的「发散阶段」才允许接触用户。早期观察能帮助发现需求误解;关键是将结果用于学习与重新构思,还是作为立即淘汰想法的判决。设计过程也可能多次发散与收敛,而非一次直线流程。
作者借用 Landauer 区分「太难用」和「提供的有用东西太少」。系统可能非常流畅却解决了没人关心的问题;另一个系统可能很难用,却因提供此前无法获得的能力而被接受。效率、有效性与满意度在指定任务下的表现,并不自动证明任务本身有价值。
| 概念 | 核心问题 | 可能的方法 | 重要限制 |
|---|---|---|---|
| Usability | 既定任务能否被顺利执行? | 观察、受控比较、问题检查 | 任务代表性与成熟度必须交代 |
| Usefulness | 此能力是否值得拥有? | 需求理解、情境分析、案例与设计论证 | 用户也未必能预先想象新用途 |
| Cultural adoption | 群体如何在时间中采用、改造与赋予意义? | 实地、纵向、民族志与文化探查 | 单人短期试用不能替代群体关系与基础设施 |
表中「可能的方法」是本页依论文建议整理的选项,不是保证因果识别的处方。需求分析也可能受当前习惯限制;把已知任务放进 usability study,并不必然发现未来的用途。
论文转述 UIST 2007 讨论:discovery 旨在发现世界的事实、区分理论解释;invention 则将技术创造性地带到复杂真实世界。前者可以从已知现象的少数变量切入,后者常涉及大范围变化与新实践。小而可控的任务效果,对前者可能很重要,却未必足以评价后者的潜力。
Reviewer:二者并非互斥,同一系统可以包含发明贡献和可检验科学主张。较合理的做法是把主张拆开,分别提供证据,而不是因为自称「创新」便不受任何检验。
| 论文案例 | 作者描述的早期限制 | 在论证中的作用 | 证据边界 |
|---|---|---|---|
| Marconi 无线电,1901 | 搭建复杂、信号微弱、成功解释曾被质疑;初始设想偏海上通信 | 技术可行性与后来的广播文化并非一回事 | 历史叙述;不能当作本文做过的 usability experiment |
| 早期汽车 | 昂贵、噪声、可靠性、驾驶维护技能与道路基础设施问题 | 采用、基础设施和竞争共同改变产品 | 不是汽车采用率的统计模型,也不证明安全问题可忽略 |
| Bush 的 Memex,1945 | 微缩胶片链接设想,未建造和测试,主要面向知识工作者 | 未被验证的愿景也能影响后续技术 | 不能推断任何未实现愿景都同样有价值 |
| Sutherland 的 Sketchpad,1963 | 大量物理控制配合光笔,技术显示条件有限 | 以当时易用性判决可能错过图形交互潜力 | 「若测试会表现差」是反事实推测 |
| Engelbart 的 NLS,1968 | 强调训练有素的办公人员增强智力,而非上手容易 | 其价值与后来的广泛日常采用不能简化为原任务速度 | 作者对没有/假想测试的讨论不是新实验结果 |
| 家庭 Ubicomp | 当时硬件、网络配置、信息服务、管理成本与多人临界规模 | 文化和技术 readiness 一同影响用途 | 文中是 2008 视角,不是今天的设备价格或能力说明 |
| YouTube、Facebook、Myspace、IM、SMS | 一些界面和功能粗糙,但形成成功使用文化 | 短期界面问题不等于社会采用失败 | 文中 YouTube 缓冲与保存限制是历史描述,不作为当前功能事实 |
Reviewer:成功案例的回顾具有幸存者偏差。作者展示了「不经常规测试也可能有影响」的例子,却没有比较大量失败创新,也没有证明提前评价一定会阻止这些成功。反事实句子应当作为提醒,而非关于可用性测试因果危害的已验证结论。
家庭技术段的脚注还专门承认:小规模 toy deployment 可以有用,但应当用来支持设计批评和反思,而不一定作为最终验证。这个限定很重要;本文不是让研究者停止接触真实使用者。
设计者先呈现产物并解释选择;不同资历成员回应喜欢或不喜欢的部分,追问假设、提出挑战,并给出具体改进建议。双方通过互动建立对设计和使用情境的共同理解。它需要可被讨论的材料、清楚理由与建设性反馈,不等于专家投票或泛泛表达审美。
| 当前要作的决定 | 先记录什么 | 优先考虑的证据 | 结论停止在哪里 |
|---|---|---|---|
| 要不要继续探索想法 | 新能力、情境、关键假设与替代方案 | 多草图、Crit、设计理由、技术存在证明 | 值得继续;不等于已证明广泛有效 |
| 两个成熟交互哪个更好 | 代表任务、用户范围、公平实现与评价指标 | 适当实验、观察与挑战性条件 | 指定条件下表现;不扩大到所有任务 |
| 产品问题应如何修复 | 目标用户、严重程度和实际影响 | 形成性 usability evaluation | 发现与修复问题;不据此证明总体有用 |
| 新技术如何进入实践 | 参与群体、基础设施、时间尺度和预期变化 | 实地/纵向研究、案例、民族志与文化探查 | 观察到的文化情境;不预测无限未来 |
| 发表的科学结论是否稳健 | 可证伪主张、替代解释、失败条件 | 复现、边界检验、透明材料 | 支持程度和未覆盖范围 |
先写一句「本研究要判断……」,再写一句「结果若为……我们将改变……」。如果无论测到什么都不改变任何主张或设计决定,该评价可能只是装饰。这个操作化建议由本页提出,不是原文的正式 protocol。
Paper Verified:论文包含两张概念图、制度诊断、三条核心批评线、历史案例和五项建议;没有原编号实验表,没有受试者样本表、训练/推理设定、统计检验或性能消融。页面中的所有表格都是阅读重建/分析表,不能作为论文新测量结果引用。
Strengths:文章把「研究目的」「证据方法」「设计阶段」从一个含混的 validation 标签中拆开;也能区分成熟系统的可比性与激进创新的可行性。尤其有价值的是双向警告:测试会过早否定,也会促使团队过早投入某个方向。关于复现与风险检验的讨论表明作者要求更好的证据,而非更少的责任。
Weaknesses:主要材料是历史成功案例与作者经验,不能估计危害发生率或总体净影响;创新若失败,是愿景本身不值得还是测试方法不当,文中缺少可操作的判别准则。对科学和设计、客观和主观的区分有修辞上的过度简化;对专家 Crit 如何处理偏见、冲突与权力问题讨论不充分。
公平反驳:「过早测了会毁掉创新」也可能成为难以证伪的借口。团队必须预先声明哪些结果会促使停止、转向或继续;保护探索不能免除对明显风险、可访问性问题或用户代价的责任。这是本页的规范性补充,文章没有提供完整伦理评估框架。
潜在改进研究:可以在相似设计团队中比较多方案发散后评价与单方案不断修复,观察方向多样性、最终实用价值、问题发现、时间成本与放弃理由;也可以系统分析审稿意见中的方法偏好。这些研究需要前置定义与长期跟踪,本文未执行。
批评论文的贡献是提出更清晰的区分、暴露惯例的盲区并提出制度和实践建议。应检验其论证是否一致、案例是否支持所需范围、反例与替代解释是否被处理,而不是机械要求它也提交一张 A/B 实验表。与此同时,批评文章中的因果措辞仍要受到证据强度约束。
Research Extension:下面是将文章原则迁移到当代研究的设想,2008 原文未研究 LLM、生成式 Agent 或程序化材质生成。
一份好评估计划应该让读者知道「证据将改变哪项决定」,而不是只看到一串流行指标。多方法 triangulation 的意义是补充不同盲点,不是把任意多个弱证据相加就变成强因果证据。