任务
无条件视频生成、给定前帧的视频预测、文本条件视频生成;以短块模型实现更长序列及空间/时间超分。
时空分解 U-Net、图像视频联合训练,以及通过重建梯度约束长视频条件采样
Jonathan Ho* · Tim Salimans* · Alexey Gritsenko · William Chan · Mohammad Norouzi · David J. Fleet | *共同贡献
Video Diffusion Models 将图像扩散的去噪网络改成时空分解的 3D U-Net,一次联合生成一个短视频块;用独立图像辅助视频训练,再以重建误差对未知帧的梯度,约束分块续写、插帧和超分辨率。最关键的创新不只是“给 U-Net 加时间维”,而是指出简单替换已知帧的噪声状态并不足以得到一致的条件采样。
固定阅读 arXiv:2204.03458v2,2022-06-22,15 页:主文 1–9 页,参考文献与结尾延至 13 页,附录 A.1–A.4 在 14–15 页。作者依次为 Jonathan Ho、Tim Salimans、Alexey Gritsenko、William Chan、Mohammad Norouzi、David J. Fleet,前两位明确共同贡献。NeurIPS 官方论文集确认 NeurIPS 2022;本文图表仍以固定 v2 为准,不混用后续版本数字。
PDF SHA-256 为 564428dc63dfe59725377fbcf0b108e1fcc3378b82f32c5b042ce861679da96f,与交接清单一致。作者 项目页提供视频样例;论文明确因潜在滥用与偏见风险决定不发布模型,不将同名社区仓库当作作者已发布实现。未见明确通讯作者标记,David J. Fleet 仅为末位候选。
无条件视频生成、给定前帧的视频预测、文本条件视频生成;以短块模型实现更长序列及空间/时间超分。
时空分离的架构使图像与视频可以共享训练;重建引导补充已知条件对未知部分的 score 修正。
像素空间、低分辨率、昂贵迭代采样;长程一致性来自分块近似条件化,不是对任意时长联合建模的保证。
旧笔记还包含后续视频生成课程、WebVid、LoRA、Tune-A-Video 等资料。本次追加只讲这篇 2022 原论文,不将那些课程信息反写成作者使用的数据或方法;原有正文与 PDF++ 锚点完全保留。
训练样本 \(x\) 是固定帧数、固定分辨率的视频张量;例如 \(16\times64\times64\) 指帧数、高、宽,不包含 RGB 通道数。模型以整块视频作为一个高维随机变量,同时去噪全部帧。文本条件 c 或噪声层级嵌入进入残差块。
将图像模型逐帧独立调用不能保证人物、背景与运动连续。本文在每一层加入跨帧信息流,使短视频块的外观和动态联合建模;长视频再以块为单位自回归。它不是逐像素自回归,也不是在一次前向中生成任意长度,更不是后来基于预训练 latent diffusion 的轻量时序适配器。
现有视频生成使用 VAE、GAN、flow 和 autoregressive 方法;同期的逐帧 diffusion/RNN 路线按单帧递推。本文选择让扩散网络一次建模整个视频块,时间依赖在多层 temporal attention 中处理。这种结构支持未来帧和过去帧在去噪时相互作用,但序列长度首先受显存与训练配置限制。
t 越大噪声越多、log-SNR 越低;t=1 接近标准高斯,t=0 接近数据。这里 \(\alpha_t\) 是累计信号标准差,与 DDPM 某些写法中单步 \(\alpha_t=1-\beta_t\) 不同。\(z_t=\alpha_tx+\sigma_t\epsilon\) 可直接从干净视频构造任意噪声时刻。
训练还对数据样本取平均。实践主要使用噪声预测 \(\widehat x_\theta(z_t)=(z_t-\sigma_t\epsilon_\theta(z_t))/\alpha_t\),以 cosine schedule 和噪声 MSE 训练;BAIR 与 Kinetics 配置改用 v-prediction,详见附录。不能将“所有模型都是同一预测目标”写死。
已知 x 时,\(q(z_s\mid z_t,x)\) 有解析高斯形式;采样以模型预测替代未知的 x。时间点从 1 均匀递减到 0。方差通过 \(\gamma\) 在两个值的 log 空间插值,\(\gamma\) 控制采样随机性,和文本 guidance 的 w、重建 guidance 的 \(w_r\) 完全不同。
一轮 ancestral 预测之后,在同一噪声层做 Langevin 修正。利用 \(\epsilon_\theta\approx-\sigma_s\nabla_{z_s}\log p(z_s)\),漂移向更合理的边缘分布移动。修正噪声是 \(\sqrt{\delta}\sigma_s\),不是 \(\sqrt{\delta\sigma_s}\)。128/256 个“带修正步”并不能直接与同数量 ancestral 步按计算量相等比较;修正还需要额外网络评估。
w=0 是普通条件预测;w 增大强调条件,也可能减少多样性。条件/无条件共享训练模型,嵌入 c 可置零获得无条件分支。原式 6 后文字把噪声写成 \((z_t-\widehat x_\theta)/\sigma_t\),与先前干净数据预测定义不一致;依照前文定义应为 \((z_t-\alpha_t\widehat x_\theta)/\sigma_t\)。这是本解读指出的记号一致性问题,不是声称发现了官方实现 bug。PDF 第 2 页
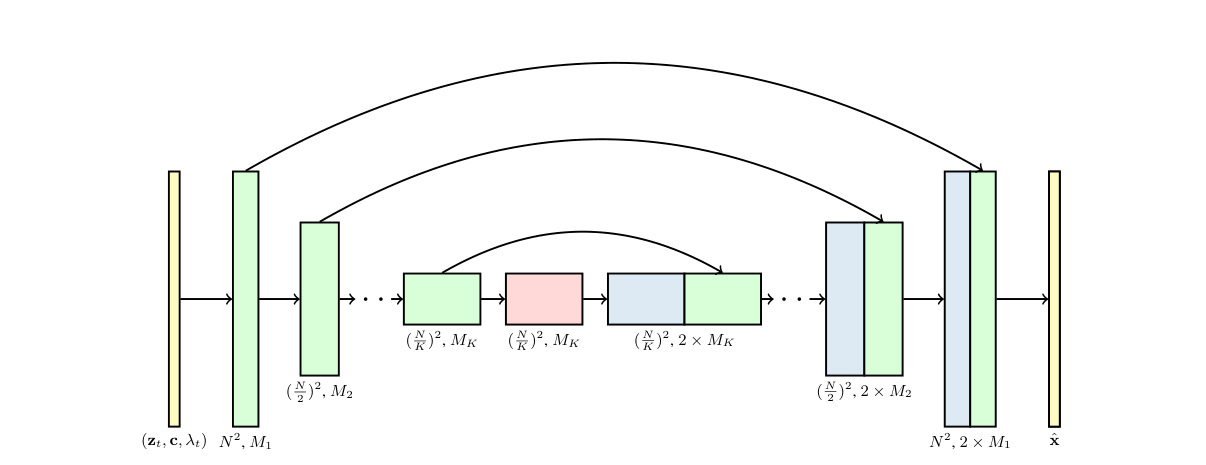
Fig. 1 是原论文的架构图,使用固定 PDF 裁切保留。残差 U-Net 在空间上逐级下采样/上采样,以 skip connection 拼接相同尺度特征;图中张量为帧 × 高 × 宽 × 通道。通道倍率控制容量,噪声和条件 embedding 经数层 MLP 后加进残差块。
这样避免对全部时空 token 做一个巨大的 dense attention。教学复杂度对比:若有 F 帧、每帧 S 个空间位置,全连接 attention 的配对规模为 \(O(F^2S^2)\),分解后约为 \(O(FS^2+SF^2)\);这是结构层面的估算,不是论文测量的速度提升倍数。
对于独立帧,将时间 attention 设为只匹配自身的 identity 连接,使不同独立图片不交流;对视频帧保留正常时间 attention。训练时把来自其他随机视频的独立图像追加到每个视频张量,屏蔽视频块与独立图片、以及独立图片彼此的信息交叉。
因此模型同时得到“一个连续视频”的时序监督和“若干独立图片”的外观监督。它们来自同一个视频数据集,不是额外使用一个已命名的大型图像数据集。作者将较低梯度方差和优化加速作为解释,并承认引入了相对于纯视频目标的偏差;表格主要呈现最终样本指标,不是逐层梯度方差的测量表。
把 x 划分为已知部分 \(x^a\) 与待生成部分 \(x^b\)。它们可以是过去/未来帧、稀疏时间点/中间帧,或低分辨率观测/高分辨率图像。理想目标为 \(p_\theta(x^b\mid x^a)\)。简单 replacement 在每次去噪后把已知部分 \(z_s^a\) 替换成来自 \(q(z_s^a\mid x^a)\) 的噪声样本;另一个版本使用正确条件 \(q(z_s^a\mid x^a,z_t^a)\)。
即使已知部分的边缘噪声分布正确,未知部分仍只沿 \(\mathbb E[x^b\mid z_t]\) 更新,而我们需要 \(\mathbb E[x^b\mid z_t,x^a]\)。前者看到了噪声状态,后者额外知道干净观测;高噪声时这份差异尤其重要。论文给出的缺失项关系为:
\[\mathbb E[x^b\mid z_t,x^a]=\mathbb E[x^b\mid z_t]+ \frac{\sigma_t^2}{\alpha_t}\nabla_{z_t^b}\log q(x^a\mid z_t).\]它说明要将已知干净信息对未知部分的影响补回去。若真实 conditional likelihood 已知且去噪模型完美,理论修正可以恢复准确条件化;现实里 \(q(x^a\mid z_t)\) 不可直接得到,作者改用高斯近似:
\[q(x^a\mid z_t)\approx \mathcal N\left(\widehat x_\theta^a(z_t),\frac{\sigma_t^2}{\alpha_t^2}I\right).\]该近似在小噪声、理想模型条件下有合理性,不能当成所有 t 都严格成立。用它的 log-density 求梯度,与前面的系数相乘,得到真正的新采样方法:
\[\widetilde x_\theta^b(z_t)=\widehat x_\theta^b(z_t)- \frac{w_r\alpha_t}{2}\nabla_{z_t^b} \|x^a-\widehat x_\theta^a(z_t)\|_2^2.\tag{7}\]式 7 的梯度对未知部分的 noisy latent求,而误差测量已知部分的重建。由于网络在时空上耦合,改变未知 latent 能影响已知区域重建;这项反向传播将两者绑定。并非只把已知帧再复制一次,也不是训练时的额外监督 loss,更不是更新网络参数。
\(w_r\) 决定重建约束强度;作者发现大于 1 往往效果更好。每次采样需要对 denoiser 的输入计算梯度,产生额外内存和计算开销;“无需额外训练的条件模型”不等于免费。
现在 \(\widehat x_\theta^a(z_t)\) 为高分辨率模型输出经可微下采样(如 bilinear)后的低分辨率视频。反向传播必须通过 downsampler;低分辨率观测与高分辨率生成保持约束。可以同时把已有高分辨率帧和稀疏低分辨率序列作为约束,进行时间延展与空间放大。

Fig. 2 的级联先用 \(16\times64\times64\)、frameskip 4 的模型生成,再用 \(9\times128\times128\)、frameskip 1 模型,将它作为低分辨率条件扩展成 \(64\times128\times128\)。两个模型都接收文本条件。这里 9 是高分模型每次处理的块长,不是最终视频只有 9 帧。
训练全部 13,320 段 UCF101 视频,不提供动作标签条件,按 TFDS loader 无额外处理,输出 \(16\times64\times64\)。用 10,000 个生成样本,C3D 计算 FID 与 IS;C3D 内部将帧 resize 到 112×112。这里的 FID 是 C3D 视频特征口径,与后面文本实验的 Inception 图像 FID 数值不能横比。
| Method | Resolution | FID\(\downarrow\) | IS\(\uparrow\) |
|---|---|---|---|
| MoCoGAN [52] | 16x64x64 | 26998 \(\pm\) 33 | 12.42 |
| TGAN-F [26] | 16x64x64 | 8942.63 \(\pm\) 3.72 | 13.62 |
| TGAN-ODE [18] | 16x64x64 | 26512 \(\pm\) 27 | 15.2 |
| TGAN-F [26] | 16x128x128 | 7817 \(\pm\) 10 | 22.91 \(\pm\) .19 |
| VideoGPT [62] | 16x128x128 | 24.69 \(\pm\) 0.30 | |
| TGAN-v2 [41] | 16x64x64 | 3431 \(\pm\) 19 | 26.60 \(\pm\) 0.47 |
| TGAN-v2 [41] | 16x128x128 | 3497 \(\pm\) 26 | 28.87 \(\pm\) 0.47 |
| DVD-GAN [14] | 16x128x128 | 32.97 \(\pm\) 1.7 | |
| Video Diffusion (ours) | 16x64x64 | 295 \(\pm\) 3 | 57 \(\pm\) 0.62 |
| real data | 16x64x64 | 60.2 |
Table 1 完整保留所有方法及分辨率。本文 FID \(295\pm3\)、IS \(57\pm0.62\);同 64 分辨率的 TGAN-v2 为 \(3431\pm19\)、\(26.60\pm0.47\),FID 约降 91.4%。Real data IS 60.2,不代表模型复制了 94.7% 的真实分布。空格表示原文未报告,不应填零。
作者承认不同文献的预处理不完全一致;真实 64 分辨率 IS 约 60,而引用工作的 128 分辨率真实 IS 约 90。升采样到同一 C3D 输入尺寸也不能消除源分辨率信息差。该表支持当时已报告设置下的显著提升,不是严格同预算同预处理的统一重跑。
约 44,000 段 64×64 机器人推物视频;模型原本无条件训练,测试用重建引导给定首帧。FVD 用 I3D,按先前工作对 256 条评估视频与 \(100\times256\) 个模型样本比较,不能误写成独立评估集有 25,600 条真实视频。
| Method | FVD\(\downarrow\) |
|---|---|
| DVD-GAN [14] | 109.8 |
| VideoGPT [62] | 103.3 |
| TrIVD-GAN-FP [33] | 103.3 |
| Transframer [35] | 100 |
| CCVS [31] | 99 |
| VideoTransformer [59] | 94 |
| FitVid [4] | 93.6 |
| NUWA [61] | 86.9 |
| Video Diffusion (ours) | |
| ancestral sampler, 512 steps | 68.19 |
| Langevin sampler, 256 steps | 66.92 |
最佳报告值为 256 步加 Langevin 修正的 66.92;512 步 ancestral 为 68.19,优于表内此前最佳 NUWA 86.9。相对改善约 23.0%。两种 sampler 步数/网络调用不一致,不能从指标直接断言 Langevin 同成本提升多少。
约 40 万训练视频、600 活动类别,64×64 无条件训练。测试抽 50,000 条视频,从随机连续片段取前 5 帧为条件、预测后 11 帧;采用 I3D 的 FVD 与 IS。
| Method | FVD\(\downarrow\) | IS\(\uparrow\) |
|---|---|---|
| Video Transformer [59] | 170 \(\pm\) 5 | |
| DVD-GAN-FP [14] | 69.1 \(\pm\) 0.78 | |
| Video VQ-VAE [57] | 64.3 \(\pm\) 2.04 | |
| CCVS [31] | 55 \(\pm\) 1 | |
| TrIVD-GAN-FP [33] | 25.74 \(\pm\) 0.66 | 12.54 |
| Transframer [35] | 25.4 | |
| Video Diffusion (ours) | ||
| ancestral, 256 steps | 18.6 | 15.39 |
| Langevin, 128 steps | 16.2 \(\pm\) 0.34 | 15.64 |
128 步 Langevin 的 FVD \(16.2\pm0.34\)、IS 15.64;256 步 ancestral 为 18.6、15.39。对比 Transframer FVD 25.4,最佳配置约低 36.2%。作者无放回抽样,并用相同片段确定生成条件和真实参照,降低估计偏差与方差;若模拟旧方法的有放回、不同随机种子协议,FVD 从 16.2 升到 16.9,IS 不变。这项对照应与主成绩一起引用。
FVD 是特征空间分布距离,兼顾时空统计却不能证明每条视频的物理因果、长程身份或每个动作都正确。不同基准、样本量和特征骨干下的 FID/FVD 不可混为统一数轴。PDF 第 5–6 页
文本实验用 1000 万条带 caption 的视频;固定 v2 没有在这里将其命名为 WebVid-10M,不能根据旧课程笔记或“同样是 10M”做替换。文本条件为 BERT-large embeddings,经 attention pooling。Small model 用于图像/视频联合训练消融,Large models 用于其余实验。
以下文本实验均报告 4096 个生成样本。FVD 与 FID 的 a/b 分别相对 training / validation 集;IS 的 a/b 是 1 split / 10 splits 的平均。不是“mean/std”,也不是两个随机种子。FID/IS-avg 对帧特征先平均,FID/IS-first 只看第一帧。
| Image frames | FVD\(\downarrow\) | FID-avg\(\downarrow\) | IS-avg\(\uparrow\) | FID-first\(\downarrow\) | IS-first\(\uparrow\) |
|---|---|---|---|---|---|
| 0 | 202.28/205.42 | 37.52/37.40 | 7.91/7.58 | 41.14/40.87 | 9.23/8.74 |
| 4 | 68.11/70.74 | 18.62/18.42 | 9.02/8.53 | 22.54/22.19 | 10.58/9.91 |
| 8 | 57.84/60.72 | 15.57/15.44 | 9.32/8.82 | 19.25/18.98 | 10.81/10.12 |
Small 模型每个视频额外附加 0、4、8 张独立图像。验证 FVD 从 205.42 降到 70.74,再到 60.72;0→8 相对下降约 70.4%。验证 FID-avg 从 37.40 到 15.44,FID-first 从 40.87 到 18.98。所有指标方向均改善,支持图像辅助训练对优化有效。
但每个样本增加了额外数据/计算,论文没有把所有配置强制匹配到同一总 FLOPs 后再比較。这里证明的是报告训练安排下的质量收益,不能单独推出“时序层学得更好”或“任何纯图像数据都能帮助任意视频域”。

| Frameskip | Guidance weight | FVD\(\downarrow\) | FID-avg\(\downarrow\) | IS-avg\(\uparrow\) | FID-first\(\downarrow\) | IS-first\(\uparrow\) |
|---|---|---|---|---|---|---|
| 1 | 1.0 | 41.65/43.70 | 12.49/12.39 | 10.80/10.07 | 16.42/16.19 | 12.17/11.22 |
| 2.0 | 50.19/48.79 | 10.53/10.47 | 13.22/12.10 | 13.91/13.75 | 14.81/13.46 | |
| 5.0 | 163.74/160.21 | 13.54/13.52 | 14.80/13.46 | 17.07/16.95 | 16.40/14.75 | |
| 4 | 1.0 | 56.71/60.30 | 11.03/10.93 | 9.40/8.90 | 16.21/15.96 | 11.39/10.61 |
| 2.0 | 54.28/51.95 | 9.39/9.36 | 11.53/10.75 | 14.21/14.04 | 13.81/12.63 | |
| 5.0 | 185.89/176.82 | 11.82/11.78 | 13.73/12.59 | 16.59/16.44 | 16.24/14.62 |
Table 5 同时保留 frameskip 1/4 与三个 guidance 权重,共六行、每行五组双数值。frameskip 1:w 从 1 到 2 时 FID-avg 验证值 12.39→10.47,但 FVD 43.70→48.79 已变差;到 w=5,IS-avg 达 14.80/13.46,FVD 却恶化到 163.74/160.21。frameskip 4 的验证 FVD 在 1、2、5 下为 60.30、51.95、176.82,最优在中间值。
因此“guidance 越大所有指标越好”是错误结论。图像清晰度、分类器置信度、覆盖度和视频动态分布存在不同权衡。Fig. 3 的左右样例展示条件更鲜明,但没有专门的人工文本匹配量表;FID/IS 也不能直接替代语义对齐测量。
| Guidance weight | Conditioning method | FVD\(\downarrow\) | FID-avg\(\downarrow\) | IS-avg\(\uparrow\) | FID-first\(\downarrow\) | IS-first\(\uparrow\) |
|---|---|---|---|---|---|---|
| 2.0 | reconstruction guidance | 136.22/134.55 | 13.77/13.62 | 10.30/9.66 | 16.34/16.46 | 14.67/13.37 |
| replacement | 451.45/436.16 | 25.95/25.52 | 7.00/6.75 | 16.33/16.46 | 14.67/13.34 | |
| 5.0 | reconstruction guidance | 133.92/133.04 | 13.59/13.58 | 10.31/9.65 | 16.28/16.53 | 15.09/13.72 |
| replacement | 456.24/441.93 | 26.05/25.69 | 7.04/6.78 | 16.30/16.54 | 15.11/13.69 |
Table 6 比较从 16 帧模型分块扩展到 \(64\times64\times64\) 的两种条件方法。表列 Guidance weight=2.0 时,验证 FVD 为 reconstruction 134.55、replacement 436.16,约降 69.2%;权重=5.0 时为 133.04 对 441.93,约降 69.9%。
FID-avg 同样明显改善(例如 13.62 对 25.52),而第一帧 FID/IS 基本一致(16.46 对 16.46,14.67/13.37 对 14.67/13.34)。这与干预只影响后续条件续写、而非第一块初始生成的机制一致,比只看整体画质更能支持 reconstruction guidance 的作用。
原表列名仅写 Guidance weight,未在该表清楚区分文本 w 与重建 \(w_r\),并且 replacement 行也列在 2/5 下。为避免过度推断,本文按原列名转录,不将 2/5 自动当作所有长视频实验的 \(w_r\)。BAIR 和 Kinetics 的 \(w_r=50,9\) 则在附录明确给出。


左侧 replacement 的不同块可能像在相同 caption 下重新抽了无关样本;右侧 reconstruction guidance 保持更连续的外观。这里的自回归是块间,块内仍是联合 diffusion,不要误读成所有帧都从左向右逐个采样。
条件近似可能累积误差;实验为 64 帧,不足以证明数分钟视频永不漂移。指标也没有分解为物体身份、镜头运动、动作物理或叙事连贯度,因此“任意长度”只能表示算法可以继续调用,并非质量保证。
以下是固定 PDF 附录所有超参数条目,按原数据完整转录。Small/large 文本模型和三个 benchmark 模型分开保留,不混写成一套万能参数。没有报告的模型参数总量、墙钟时长、显存峰值不补造。
| Base channels: 256 | Optimizer: Adam (\(\beta_{1}=0.9,\beta_{2}=0.99\)) |
| Channel multipliers: 1, 2, 4, 8 | Learning rate: 0.0003 |
| Blocks per resolution: 2 | Batch size: 128 |
| Attention resolutions: 8, 16, 32 | EMA: 0.9999 |
| Attention head dimension: 64 | Dropout: 0.1 |
| Conditioning embedding dimension: 1024 | Training hardware: 128 TPU-v4 chips |
| Conditioning embedding MLP layers: 4 | Training steps: 60000 |
| Diffusion noise schedule: cosine | Joint training independent images per video: 8 |
| Noise schedule log SNR range: \([-20,20]\) | Sampling timesteps: 256 |
| Video resolution: 16x64x64 frameskip 1 | Sampling log-variance interpolation: \(\gamma=0.1\) |
| Weight decay: 0.0 | Prediction target: \({\boldsymbol{\epsilon}}\) |
| Base channels: 128 | Optimizer: Adam (\(\beta_{1}=0.9,\beta_{2}=0.999\)) |
| Channel multipliers: 1, 2, 3, 4 | Learning rate: 0.0002 |
| Blocks per resolution: 3 | Batch size: 128 |
| Attention resolutions: 8, 16, 32 | EMA: 0.999 |
| Attention head dimension: 64 | Dropout: 0.1 |
| Conditioning embedding dimension: 1024 | Training hardware: 128 TPU-v4 chips |
| Conditioning embedding MLP layers: 2 | Training steps: 660000 |
| Diffusion noise schedule: cosine | Joint training independent images per video: 8 |
| Noise schedule log SNR range: \([-20,20]\) | Sampling timesteps: 256 (+256 Langevin cor.) |
| Video resolution: 16x64x64 frameskip 1 | Sampling log-variance interpolation: \(\gamma=0.0\) |
| Weight decay: 0.01 | Prediction target: \(\mathbf{v}\) |
| Reconstruction guidance weight: 50 | Data augmentation: left-right flips |
| Base channels: 256 | Optimizer: Adam (\(\beta_{1}=0.9,\beta_{2}=0.99\)) |
| Channel multipliers: 1, 2, 4, 8 | Learning rate: 0.0002 |
| Blocks per resolution: 2 | Batch size: 256 |
| Attention resolutions: 8, 16, 32 | EMA: 0.9999 |
| Attention head dimension: 64 | Dropout: 0.1 |
| Conditioning embedding dimension: 1024 | Training hardware: 256 TPU-v4 chips |
| Conditioning embedding MLP layers: 2 | Training steps: 220,000 |
| Diffusion noise schedule: cosine | Joint training independent images per video: 8 |
| Noise schedule log SNR range: \([-20,20]\) | Sampling timesteps: 128 (+128 Langevin cor.) |
| Video resolution: 16x64x64 frameskip 1 | Sampling log-variance interpolation: \(\gamma=0.0\) |
| Weight decay: 0.0 | Prediction target: \(\mathbf{v}\) |
| Reconstruction guidance weight: 9 |
| Base channels: 128 | Optimizer: Adam (\(\beta_{1}=0.9,\beta_{2}=0.99\)) |
| Channel multipliers: 1, 2, 4, 8 | Learning rate: 0.0003 |
| Blocks per resolution: 2 | Batch size: 128 |
| Attention resolutions: 8, 16, 32 | EMA: 0.9999 |
| Attention head dimension: 64 | Dropout: 0.0 |
| Conditioning embedding dimension: 1024 | Training hardware: 64 TPU-v4 chips |
| Conditioning embedding MLP layers: 4 | Training steps: 200000 |
| Diffusion noise schedule: cosine | Joint training independent images per video: 0, 4, 8 |
| Noise schedule log SNR range: \([-20,20]\) | Sampling timesteps: 256 |
| Video resolution: 16x64x64 frameskip 1 | Sampling log-variance interpolation: \(\gamma=0.3\) |
| Weight decay: 0.0 | Prediction target: \({\boldsymbol{\epsilon}}\) |
| Base channels: 256 | Optimizer: Adam (\(\beta_{1}=0.9,\beta_{2}=0.99\)) |
| Channel multipliers: 1, 2, 4, 8 | Learning rate: 0.0003 |
| Blocks per resolution: 2 | Batch size: 128 |
| Attention resolutions: 8, 16, 32 | EMA: 0.9999 |
| Attention head dimension: 64 | Dropout: 0.0 |
| Conditioning embedding dimension: 1024 | Training hardware: 128 TPU-v4 chips |
| Conditioning embedding MLP layers: 4 | Training steps: 700000 |
| Diffusion noise schedule: cosine | Joint training independent images per video: 8 |
| Noise schedule log SNR range: \([-20,20]\) | Sampling timesteps: 256 |
| Video resolution: 16x64x64 frameskip 1,4 | Sampling log-variance interpolation: \(\gamma=0.3\) |
| Weight decay: 0.0 | Prediction target: \({\boldsymbol{\epsilon}}\) |
| Base channels: 128 | Optimizer: Adam (\(\beta_{1}=0.9,\beta_{2}=0.99\)) |
| Channel multipliers: 1, 2, 4, 8, 16 | Learning rate: 0.0002 |
| Blocks per resolution: 2 | Batch size: 128 |
| Attention resolutions: 8, 16, 32 | EMA: 0.9999 |
| Attention head dimension: 128 | Dropout: 0.0 |
| Conditioning embedding dimension: 1024 | Training hardware: 128 TPU-v4 chips |
| Conditioning embedding MLP layers: 4 | Training steps: 800000 |
| Diffusion noise schedule: cosine | Joint training independent images per video: 7 |
| Noise schedule log SNR range: \([-20,20]\) | Sampling timesteps: 256 |
| Video resolution: 9x128x128 frameskip 1 | Sampling log-variance interpolation: \(\gamma=0.3\) |
| Weight decay: 0.0 | Prediction target: \({\boldsymbol{\epsilon}}\) |
共同结构包括 cosine schedule、log-SNR 范围 −20 到 20、1024 维条件 embedding;但通道数、残差块数、Adam 二阶动量、EMA、dropout、weight decay、预测目标、硬件和训练步数显著不同。例如 UCF101 60,000 步,BAIR 660,000 步,Kinetics 220,000 步;Small text 200,000,Large 16 帧 700,000,Large 9 帧高分模型 800,000 步。
高分模型 base channels 128,却使用 1/2/4/8/16 五级 channel multipliers 与 128 维 attention head;不能仅凭 base channels 较低就断言它比 256 通道低分模型小。其独立图像每视频 7 张,也不是前述普遍使用的 8 张。
BAIR 的“256 (+256 Langevin cor.)”和 Kinetics 的“128 (+128 Langevin cor.)”是扩散步及额外修正,不应省略后半;重建引导还需要输入梯度。论文硬件规模为 64–256 TPU-v4 chips,说明这不是单消费级 GPU 已验证的便宜复现流程。

Fig. 5 是 Fig. 2 的额外级联样例,仍遵循先稀疏低分辨率生成再时空增强;静态帧只能部分检查连续性,真正运动质量需回到官方视频样例。此交付未进行浏览器视频播放或视觉截图验收。
附录超参数详细,但没有公开模型可直接核查,1000 万文本视频的完整来源和清洗流程未在 v2 充分交代,文本条件 dropout 细节、精确 mask 实现、长视频块衔接细节与全部随机种子仍需实现说明。没有运行模型,因此本文不报告额外复现数值或代码性能。
方法把架构、训练与条件采样连成一套统一系统;尤其对 replacement 缺失条件 score 的分析,使 reconstruction guidance 有明确推导,而非凭经验追加 loss。UCF101、BAIR、Kinetics 三个任务与文本数据集上的实验共同支撑适用范围。
基准预处理和高分/低分比较存在差异;文本实验的训练数据难以独立重建;强 CFG 可能牺牲视频分布覆盖;像素空间多次去噪与反向输入梯度成本高。本文没有证明物理一致性、社会偏见已消除、长视频可无限保持身份,论文也明确承认误用和偏见风险并据此不发布模型。
归档建议复用 Jonathan Ho、Tim Salimans 和 David J. Fleet 的人物记录;前两位为共同第一/共同贡献,末位仅为通讯候选。填入官方项目页与 NeurIPS 2022 元数据时,保留该笔记所指 v2 PDF 和用户现有课程笔记,不替换原文。
本次只有候选 HTML、新增精读和保留原前缀的合并候选;没有修改实际笔记库、People 或共享索引,没有浏览器验收、模型运行或部署。原表全部空缺保留,a/b 与误差区间按作者原口径解释;不存在的数据不以推测补齐。