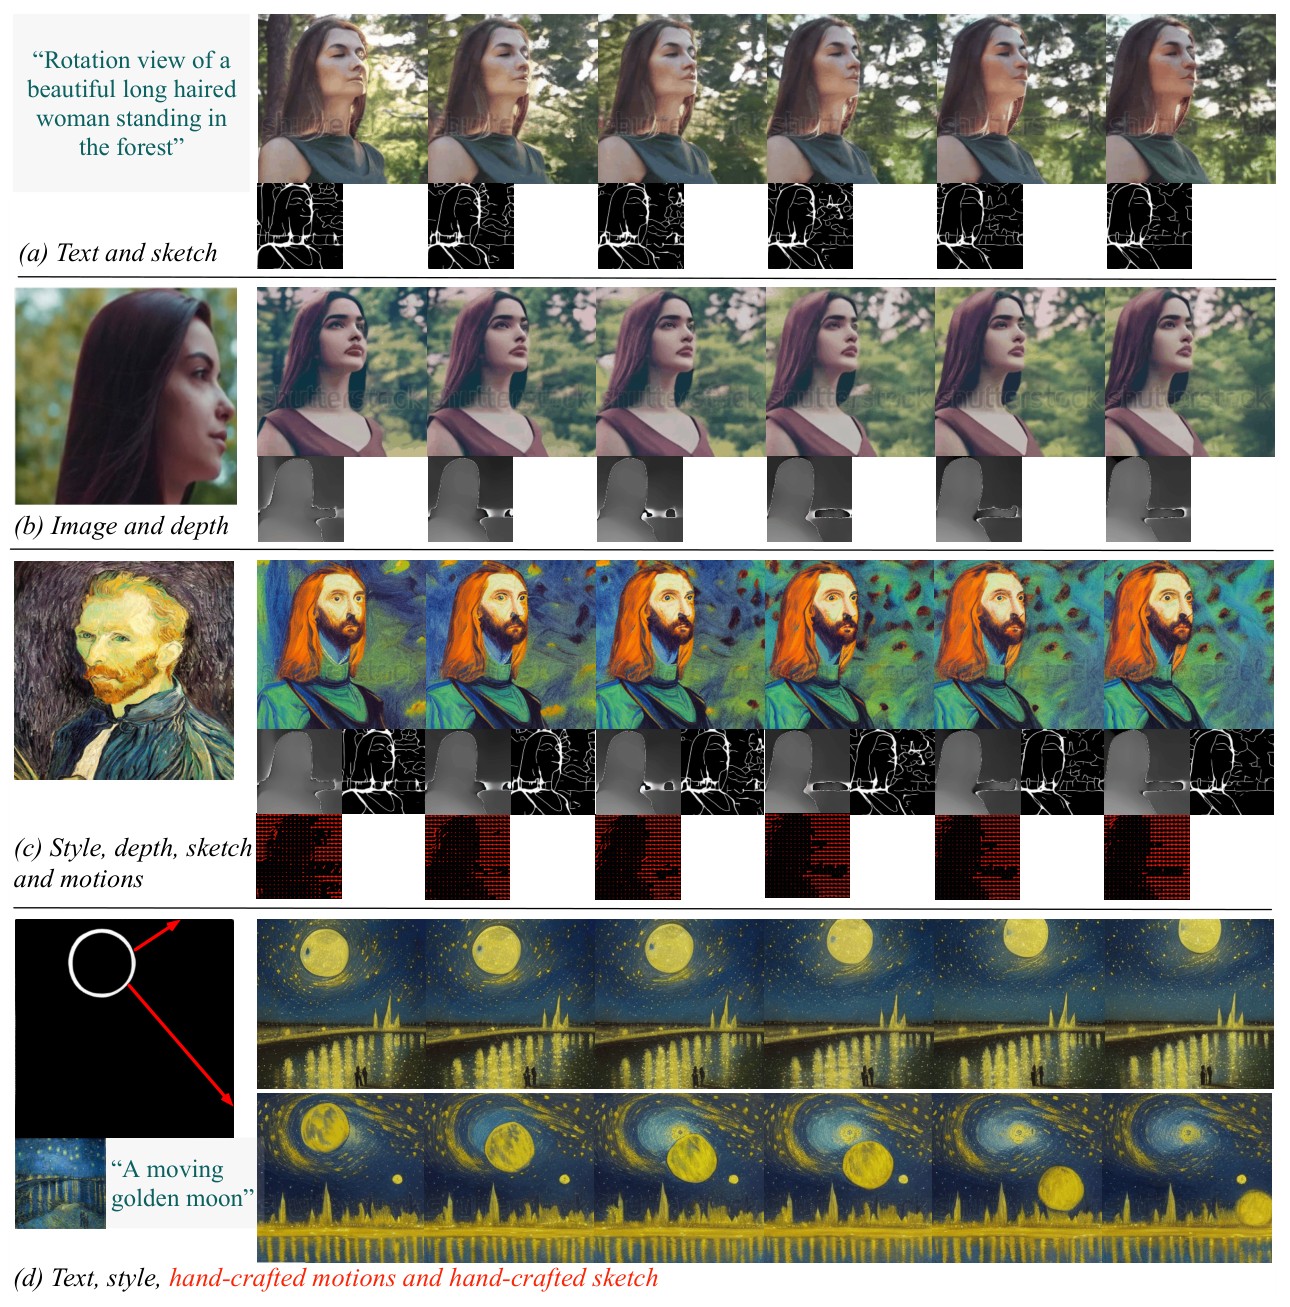
文本;图像、单帧草图、风格;运动向量、深度、mask、草图序列。
01 · 阅读定位与版本
VideoComposer: Compositional Video Synthesis with Motion Controllability,NeurIPS 2023。核心不是“更大的文生视频模型”,而是将文本、静态结构、逐帧结构和运动信号统一为可组合的生成条件。训练时从同一视频提取这些因素,再随机选择条件重建视频;推理时可以重组条件实现编辑、风格迁移和运动迁移。
作者依次为 Xiang Wang、Hangjie Yuan、Shiwei Zhang、Dayou Chen、Jiuniu Wang、Yingya Zhang、Yujun Shen、Deli Zhao、Jingren Zhou。前四位作者均标注等贡献,包括原笔记 first_authors 遗漏的 Dayou Chen。除 Yujun Shen 属 Ant Group 外,其余作者署名 Alibaba Group。论文未明确标注通讯作者,Jingren Zhou 只能作为末位作者候选,不能称为已核实通讯作者。
本解读固定于原始 NeurIPS PDF 的 18 页合订本:正文第 1–10 页,参考文献第 11–14 页,附录 A–C 第 15–18 页;18 页不是“正文外另有 18 页补充材料”。原始 PDF 与官方 proceedings PDF 的 SHA-256 一致。arXiv 标识为 2306.02018,但不能据此给固定 proceedings PDF 虚构 arXiv 版本号。额外 supplement ZIP 是一个 MP4 演示视频,没有另一份附录 PDF;本页依据合订本完整附录,不声称已做视频播放验收。
132k 文本视频预训练 + 268k 可组合训练。
运动条件与 STC 同时使用的结果;这是运动控制指标,不能替代整体质量。
来源:论文首页、NeurIPS proceedings 元数据。下文“论文验证”“作者解释”“我们的解读”“研究延伸”区分证据等级。
02 · 为什么需要时间条件
文本很适合描述语义,却难精确规定每帧的位置、姿态、相机运动和运动轨迹;单帧图像或草图可以固定外观,但无法唯一确定未来的运动。图像领域 Composer 的多条件组合思想因此不能原样解决视频问题:生成过程既需接收随时间变化的约束,也需避免每帧各自满足条件而造成闪烁。
本文的假设有两部分:一是压缩视频中的运动向量提供显式运动指导,与深度、草图提供的几何/轮廓信息互补;二是条件编码器也应建模时间关系,而不是只在生成主干中建模时间。运动向量只描述变化,可能保留运动前景而弱化静止背景,这为运动迁移提供入口。
我们的解读:贡献是条件表示、统一接口、训练方式的系统组合。运动向量并非作者发明,视频扩散和 CLIP 条件也来自既有技术。本文将这些要素连接到“同一模型处理多个条件子集”的问题上。相比逐任务训练控制器,这种设计更灵活,但输入冲突如何解决没有显式优先级机制。
来源:第 1–2 节。
03 · 问题、张量与扩散目标
输入是条件集合的任意已训练子集,输出是 RGB 视频,而不是场景图、程序、材质节点图或可执行动作。设视频为 \(x\in\mathbb{R}^{F\times H\times W\times 3}\),\(F\) 为帧数,\(H,W\) 为像素分辨率;预训练感知编码器 \(\mathcal E\) 将视频映射为潜变量,解码器 \(\mathcal D\) 返回像素空间:
\[z=\mathcal E(x)\in\mathbb{R}^{F\times h\times w\times c},\qquad \bar{x}=\mathcal D(z),\qquad H/h=W/w=8.\]
这里 \(c\) 是潜变量通道数,条件集合记作 \(\mathcal C\),避免与原文复用的 c 混淆。训练配置 \(F=16,H=W=256\) 对应 \(h=w=32\)。压缩保留局部视觉信息,同时降低扩散模型处理空间像素的成本;感知编码器并不等于完整的时空运动编码器。
| 符号 | 含义 | 出现位置 |
|---|---|---|
| \(z_t\) | 扩散第 t 步的带噪视频潜变量 | 3D UNet 输入 |
| \(T=1000\) | 训练的扩散时间步总数,不是视频帧数 | 前向加噪 / 时间嵌入 |
| \(\epsilon\sim\mathcal N(0,I)\) | 监督目标噪声 | 噪声预测损失 |
| \(\epsilon_\theta\) | 带条件的 3D UNet 去噪器 | 训练与采样共用 |
| \(\mathcal C_1,\mathcal C_2\) | CFG 两个条件分支 | 推理时决定强化哪些约束 |
| \(\omega\) | guidance 强度 | 两个噪声预测的外推系数 |
原公式 (1),符号统一后:
\[\mathcal L_{\mathrm{VLDM}}=\mathbb E_{\mathcal E(x),\,\epsilon\sim\mathcal N(0,I),\,\mathcal C,\,t}\left[\left\|\epsilon-\epsilon_\theta(z_t,\mathcal C,t)\right\|_2^2\right].\]
每次训练取干净视频潜变量、采样噪声和时间步、抽取条件子集,然后预测加入的噪声。目标不是直接最小化光流 EPE;后者只用于评估。随机条件选择迫使同一个去噪器在不同条件组合下工作。损失本身沿用 latent diffusion,创新主要在条件如何构建与注入。
背景补充,非论文新增公式:标准 DDPM 表达可写为 \(z_t=\sqrt{\bar\alpha_t}z+\sqrt{1-\bar\alpha_t}\epsilon\),其中 \(\bar\alpha_t=\prod_{s=1}^{t}(1-\beta_s)\)。它说明模型为何预测噪声、为何时间 t 必须作为输入;固定论文正文没有给出完整噪声调度数表,不应把通用写法当作完整复现配置。
来源:第 3.1 节与公式 (1)。
04 · 八类条件如何构建
| 条件 | 构建与信息 | 注入方式 / 注意点 |
|---|---|---|
| 文本 | OpenCLIP ViT-H/14 文本编码器;描述内容与粗粒度动作 | embedding 序列经 cross-attention;不是 LLM prompt agent |
| 单帧图像 | 训练视频首帧;限定内容与结构 | 沿时间重复后送入条件编码器,不等于所有输出帧必须复制首帧 |
| 单帧草图 | PiDiNet 提取首帧边缘 / 草图 | 重复至 F 帧,弱化颜色纹理,保留形状 |
| 风格 | OpenCLIP ViT-H/14 图像 embedding | cross-attention;全局表征可能同时含语义,不能保证纯风格解耦 |
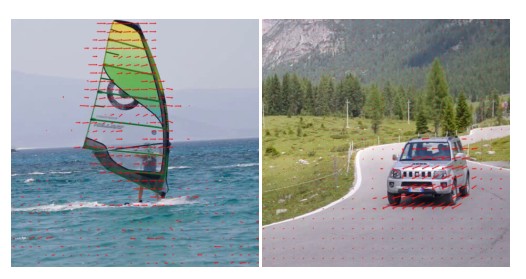
| 运动向量 MV | 从 MPEG-4 压缩视频提取水平、垂直运动分量;也可人工画轨迹构造 | 时序条件编码;压缩域 MV 不是精确物理位移或光流真值 |
| 深度序列 | 预训练单目深度模型提取逐帧深度 | STC 编码,约束空间布局与随时间演化的结构 |
| mask 序列 | 人为 tube mask,保留可观察区域并要求修补遮挡区 | 支持局部编辑 / inpainting;mask 和观察内容共同提供条件 |
| 草图序列 | 逐帧草图,比单帧草图给出更密集时序结构约束 | STC 编码;更接近视频到视频翻译 |
MV 的优点是压缩视频已有该信号,避免把昂贵稠密光流当作唯一输入。其缺点同样重要:压缩编码决策、块划分、遮挡和相机运动会影响信号。论文把运动表述为逐像素运动指导,但不能据此认定压缩 MV 与光流完全等价;输入 MV 与评估时光流 EPE 必须分开理解。
来源:第 3.2 节。
05 · STC 与 3D UNet 的完整路径
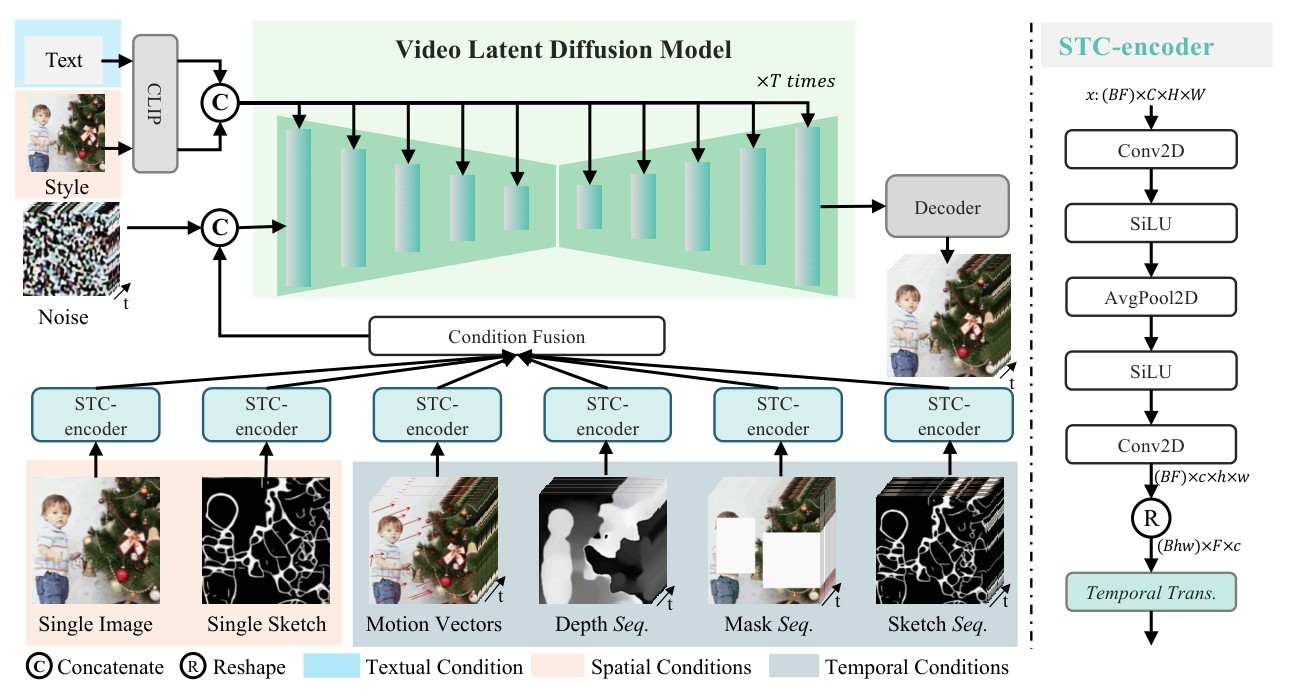
- 分解视频:从训练视频构造上述各类条件,同时编码得到目标 latent。
- 条件空间编码:每一种非 embedding 条件使用两层 2D 卷积与平均池化,配合 SiLU,把空间大小对齐至 latent。
- 条件时间编码:在同一空间位置沿时间做一层 Transformer,将逐帧的局部特征联系起来。
- 融合:不同 STC 输出逐元素相加,再与带噪 latent 沿通道拼接。文本和风格 embedding 则通过 cross-attention 注入。
- 视频去噪:3D UNet 预测噪声;重复 DDIM 采样后由感知解码器输出视频。
图 2 的张量变换是理解 STC 的关键。批大小为 B,输入先视为 \((BF)\times C\times H\times W\) 做空间编码;输出变为 \((BF)\times c\times h\times w\),再 reshape 为 \((Bhw)\times F\times c\),让 temporal Transformer 对每个空间位置的 F 帧建模。它不是在全部视频像素之间做一个巨型全局 attention。
我们的结构化表达,非原文编号公式:
\[u_k=\mathrm{STC}_k(\mathcal C_k),\qquad u=\sum_{k\in\mathcal K}u_k,\qquad \tilde z_t=\mathrm{Concat}_{\mathrm{channel}}(z_t,u).\]
不同条件有相同接口和输出形状,但不共享 STC 权重,这是附录 A 明确补充的细节。加法融合降低接口复杂度,却不能显式区分条件冲突来源;这也是后续改成可学习 gating 或条件权重的动机,而非本文已有组件。
3D UNet 从 Stable Diffusion 的 2D UNet 扩展:每个块包含空间卷积、时间卷积、空间 Transformer、时间 Transformer。空间模块继承图像 LDM;时间模块新增。时间卷积堆叠四个 \(1\times1\times3\) 卷积扩大时间感受野;时间 Transformer 为一层,使用 flash attention 加速。注意“条件编码器的时间 Transformer”和“生成主干的时间 Transformer”是两处不同组件。
06 · 训练设置与复现缺口
| 项目 | 固定论文已公开的信息 | 复现解释 |
|---|---|---|
| 图像初始化 | 预训练 LDM / Stable Diffusion;空间块继承,加入时间模块 | 论文未在此给出完整参数量或 base / large 两套模型;没有独立大模型实验配置 |
| 视频数据 | WebVid10M,10.3M 视频–文本对 | 原始数据含水印,影响模型输出 |
| 图像数据 | LAION-400M,CLIP 过滤的图像–文本对 | 按单帧视频联合训练,F=1 |
| 阶段一 | 132k steps,仅文本条件学习视频时间动力学 | 先学文生视频基础能力 |
| 阶段二 | 268k steps,加入全部三大类条件做 compositional training | 总计 400k;阶段二仍使用图像与视频 |
| 优化 | AdamW;学习率 \(5\times10^{-5}\) | 未完整报告 betas、weight decay、学习率调度与 warmup |
| 帧与分辨率 | 16 帧,256×256,center crop;按不同 stride 采样至 4 fps | 名义长度约 4 秒,首末帧间距约 3.75 秒 |
| 资源分配 | 1/4 GPU 用于图像预训练,3/4 用于视频预训练 | 未报告可据以计算总算力的 GPU 型号、总数量、墙钟训练时间 |
| 条件 dropout | 0.1 概率保留全部、0.1 丢弃全部;其余随机组合按每条件独立 0.5 保留 / 丢弃 | 覆盖无条件、全条件及条件子集;表述遵循附录的混合采样描述 |
| 未充分公开 | 全局 batch、精度、梯度累计、完整过滤规则与训练/验证划分、全部训练冻结设置 | 不能用公开 demo 的 batch=1 或 num_steps=1 填补训练协议 |
两阶段策略降低同时学习“时间连贯性”和“多条件控制”的难度。Table 1 表明阶段二之后文本生成指标也变好,但该实验没有把额外训练步数、更多监督信号与条件组合机制分离。因此“可组合训练使文生视频更好”有观察支持;“提升完全来自某个条件机制”的因果说法超出了实验。
这里不存在 system prompt、few-shot 推理提示或工具调用链。提示词就是用户自然语言视频描述;正文给出例图描述,但不公开完整测试 prompt 清单。也没有 beam search、top-p 或执行器反馈循环,不能把语言模型推理参数套到扩散视频采样。
07 · 推理、CFG 与实际代码差异
原公式 (2),条件符号统一后:
\[\hat\epsilon_\theta(z_t,\mathcal C,t)=\epsilon_\theta(z_t,\mathcal C_1,t)+\omega\left[\epsilon_\theta(z_t,\mathcal C_2,t)-\epsilon_\theta(z_t,\mathcal C_1,t)\right].\]
这是两个条件预测之间的外推。若两分支共享 mask 视频,但第二分支加入目标文本,则差异项强化文本效果,保留观察区域约束。不是所有使用方式都把第一分支设为完全无条件;\(\mathcal C_2\setminus\mathcal C_1\) 决定被强调的条件。较高 guidance 可能加强条件一致性,但本文没有系统报告其质量–多样性曲线。
推理流程:准备条件与缺失条件状态 → 统一预处理和 STC/CLIP 编码 → 初始化 Gaussian latent noise → 按 DDIM 时间步用两个条件分支预测噪声 → CFG 合成 → 更新潜变量 → 解码所有帧。停止条件是采样步耗尽,不存在额外 rerank、优化器修图或模型自我反思。
Paper vs. Implementation:只读核查,未运行模型
官方仓库固定核查 commit 490ed21b5c41ecbb12fd024de4308ce68b1e0f64。README 列出 Stable Diffusion 2.1 base、OpenCLIP、MiDaS、PiDiNet / sketch simplification 等权重依赖。这是发布实现的信息,比论文“基于 Stable Diffusion”的表述更具体,不能自动代表论文所有训练超参数。
- config.py 设置训练扩散时间步 1000、噪声预测 eps、MSE,DDIM 默认 50 步,旁注“official: 250”。只能报告这段发布配置存在差异,不能仅凭注释认定论文全部实验使用 250 步。
- config.py 写 guide_scale=6.0,但 inference_single.py 的采样调用直接传入 9.0;inference_multi.py 多处也传 9.0。复现实验应追踪实际调用,而非只查看默认配置。
- 推理调用 eta=0.0。配置的 seed=8888 会被实验 YAML 覆盖,例如部分任务使用 182。应保存最终合并配置和种子。
- exp01 YAML 指向 non_ema_228000.pth,并设置 demo batch=1、num_steps=1。这些是发布推理设置,不能把检查点文件名 228000 解释成论文总训练步数,或把 demo 参数误报成训练配置。
- README 后续宣布无水印、8 秒模型。本文固定的 NeurIPS 实验仍是 256×256、16 帧、WebVid 水印局限;后发布能力不回填到原论文结果。
08 · 三张数值表:结果与边界
原 Table 1 · MSR-VTT 文本生成
| Method | Zero-shot | FVD ↓ | CLIPSIM ↑ |
|---|---|---|---|
| GODIVA | No | — | 0.2402 |
| Nüwa | No | — | 0.2439 |
| CogVideo (Chinese) | Yes | — | 0.2614 |
| CogVideo (English) | Yes | 1294 | 0.2631 |
| MagicVideo | Yes | 1290 | — |
| Make-A-Video | Yes | — | 0.3049 |
| Video LDM | Yes | — | 0.2929 |
| Text-to-video pre-training (First stage) | Yes | 803 | 0.2876 |
| VideoComposer | Yes | 580 | 0.2932 |
论文验证:相对自己的第一阶段,FVD 从 803 降至 580,降低 223(约 27.8%);CLIPSIM 增加 0.0056。已报告 FVD 中本文最优,第二为自身阶段一;CLIPSIM 最优为 Make-A-Video,本文第二,比 Video LDM 只高 0.0003,不能称为 CLIPSIM 全面最佳。破折号表示未报告,不能当作零。表中混合 zero-shot 与非 zero-shot 方法,且没有统一重训所有基线,不应把这些差异解释为受控的架构比较。
FVD 衡量生成视频与参考视频的特征分布距离,CLIPSIM 衡量文本–视频语义相似性。二者与运动控制不是同一目标。论文称沿用 Video LDM 的 MSR-VTT 协议,但没有在本表完整公开采样种子、全部 prompt、置信区间和每个基线的计算预算。
原 Table 2 · 运动控制
| Method | Text | MV | Motion control ↓ |
|---|---|---|---|
| w/o STC-encoder | ✓ | — | 4.03 |
| w/o STC-encoder | ✓ | ✓ | 2.67 |
| VideoComposer | ✓ | ✓ | 2.18 |
随机选取 1000 个 caption-video 对生成视频,用光流的 end-point error 测量运动差异,越低越好。增加 MV 后从 4.03 到 2.67,下降约 33.7%;再增加 STC 的时间建模从 2.67 到 2.18,下降约 18.4%;组合相对首行下降约 45.9%。这些百分比为本解读据原表计算,原文没有给出方差。
消融的准确含义:“w/o STC-encoder”并不是把整个条件处理模块删除;附录明确只移除 temporal Transformer,保留空间卷积以对齐维度。表中没有“有 STC、无 MV”一行,因此不能完整估计两个组件的所有交互项。
原 Table 3 · 跨帧一致性
| Method | Conditions | Frame consistency ↑ |
|---|---|---|
| w/o STC-encoder | Text and sketch sequence | 0.910 |
| VideoComposer | Text and sketch sequence | 0.923 |
| w/o STC-encoder | Text and depth sequence | 0.922 |
| VideoComposer | Text and depth sequence | 0.928 |
| w/o STC-encoder | Text and motion vectors | 0.915 |
| VideoComposer | Text and motion vectors | 0.927 |
1000 个测试视频的相邻帧 CLIP cosine similarity:草图增加 0.013、深度增加 0.006、MV 增加 0.012。作者将提升归因于 STC 的时间建模能力,三种输入下方向一致。但 CLIP 相似度侧重语义和外观,一段不动的视频也可能获得很高一致性;必须同时考虑 EPE 与运动幅度,不能把 0.928 解释为“92.8% 物理正确”。
09 · 任务与全部正文定性证据
图生视频与局部修补
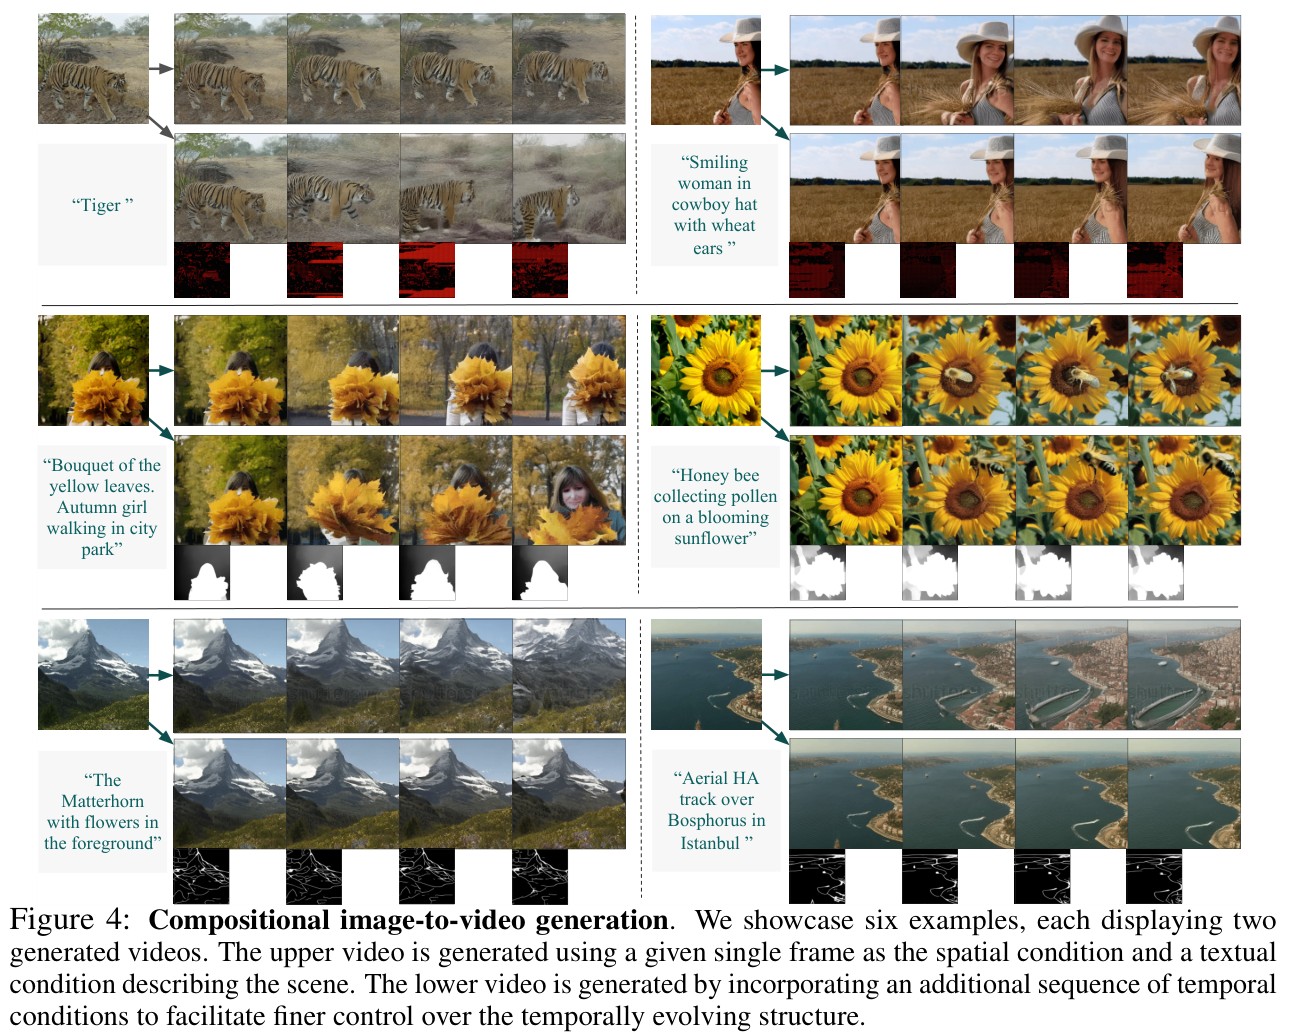
Figure 4 的每个例子上行为首帧 + 文本,下行再加入时间条件。关键比较是同一初始外观下,额外时序结构是否改变后续运动,而非仅看画面是否漂亮。它证明可组合接口能处理这类输入,不能从六个精选案例估计泛化成功率。
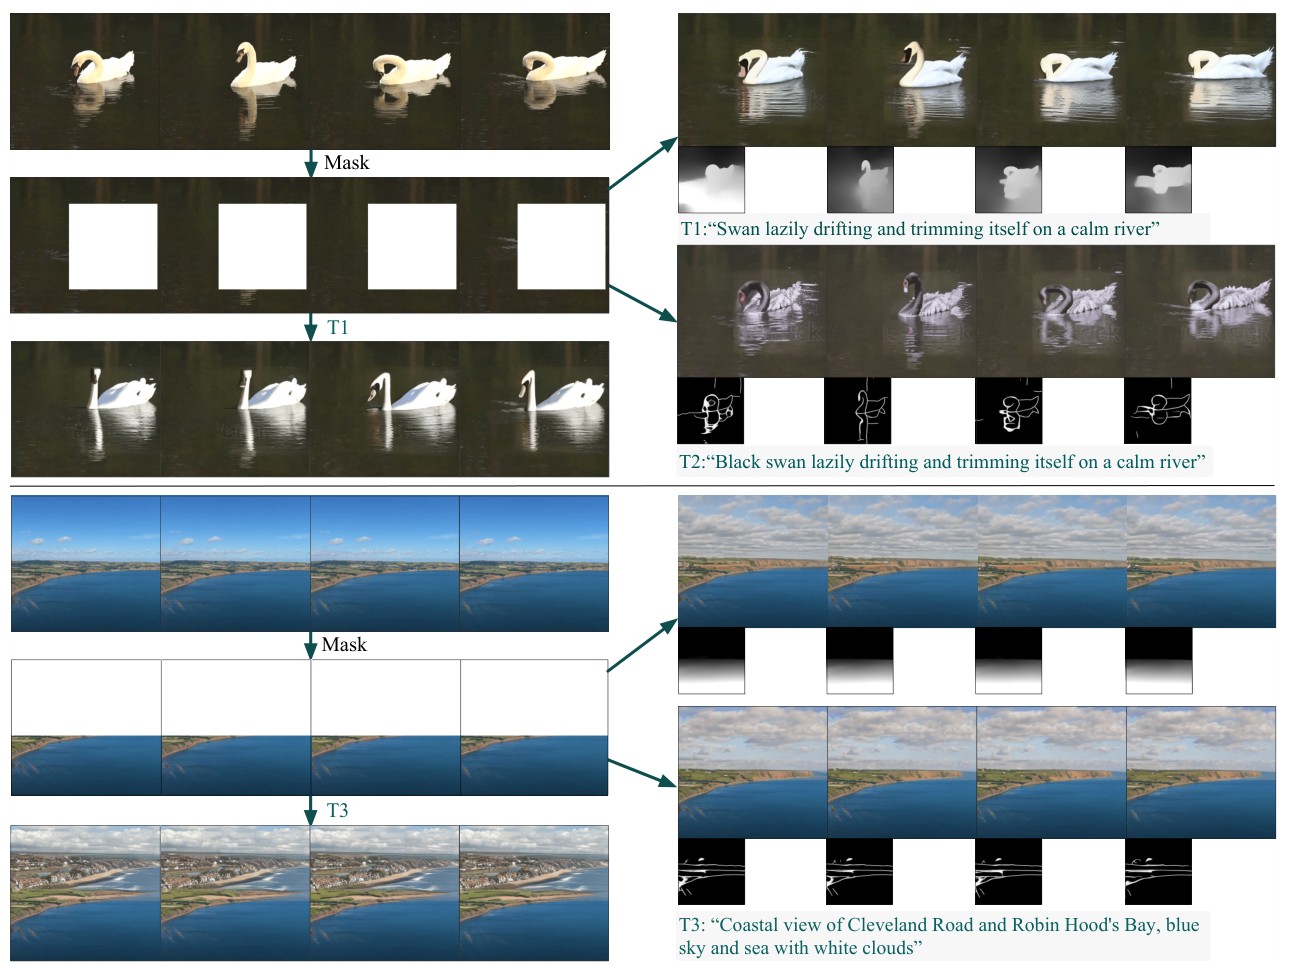
Figure 5 用 mask 和文字补全损坏区域,并展示加入深度/草图后对结构的进一步约束。文字可以把白天鹅改成黑天鹅等指定内容;mask 提供编辑位置和可见上下文。论文没有给出系统的未编辑区域保真度分数,不能认定所有区域都严格不变。
单草图动画与风格
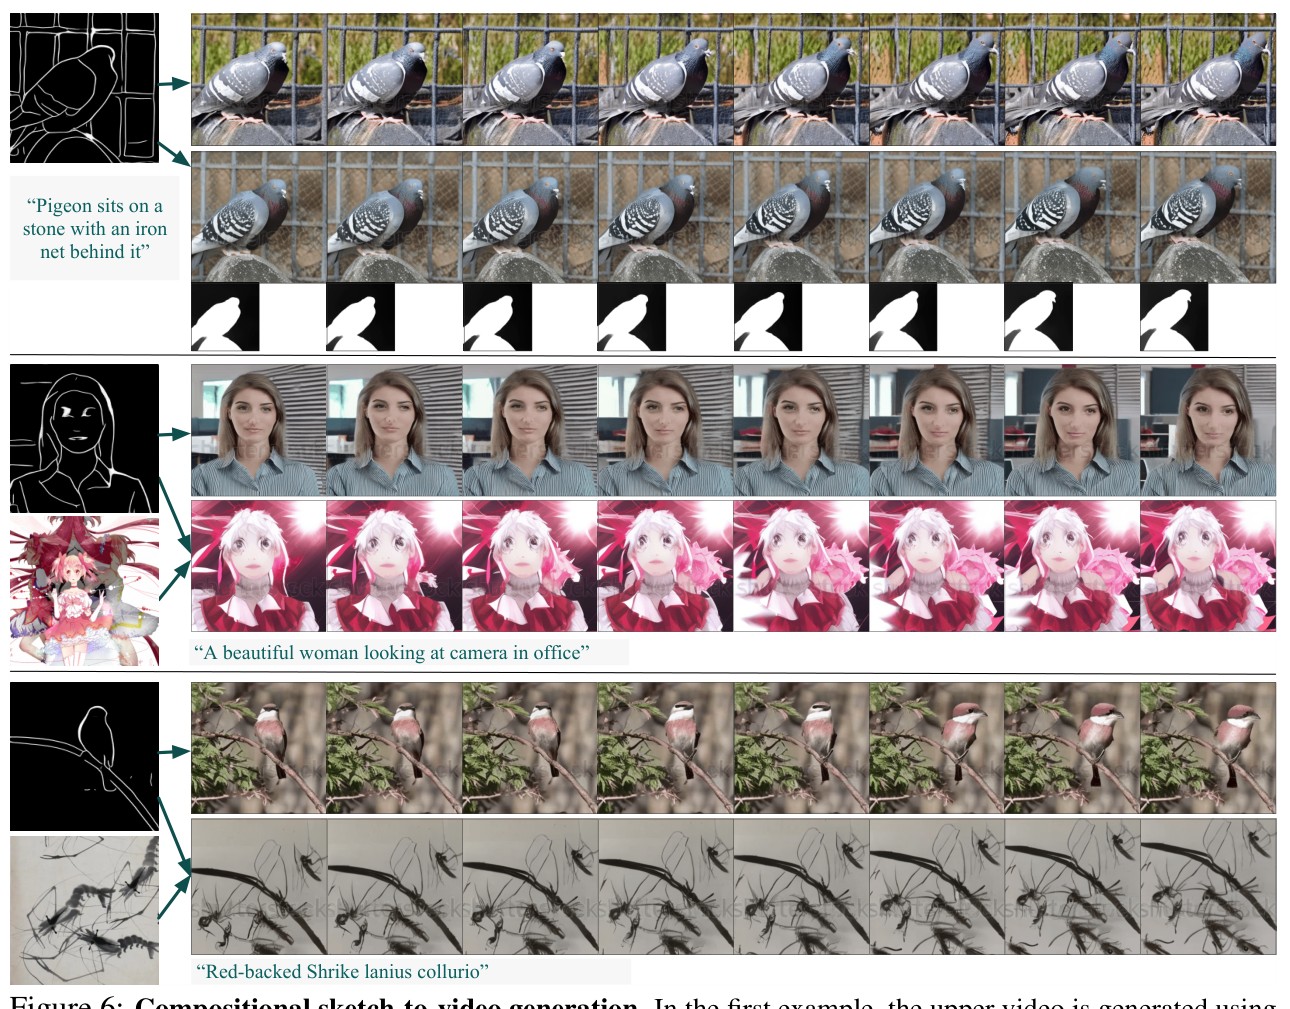
Figure 6 的单帧草图只固定初始形状;额外 mask 或风格 embedding 改变时序与外观。它与附录 A11 的逐帧草图输入不同:后者预先给定整条结构轨迹,控制信息更强。
与其他方法的定性比较
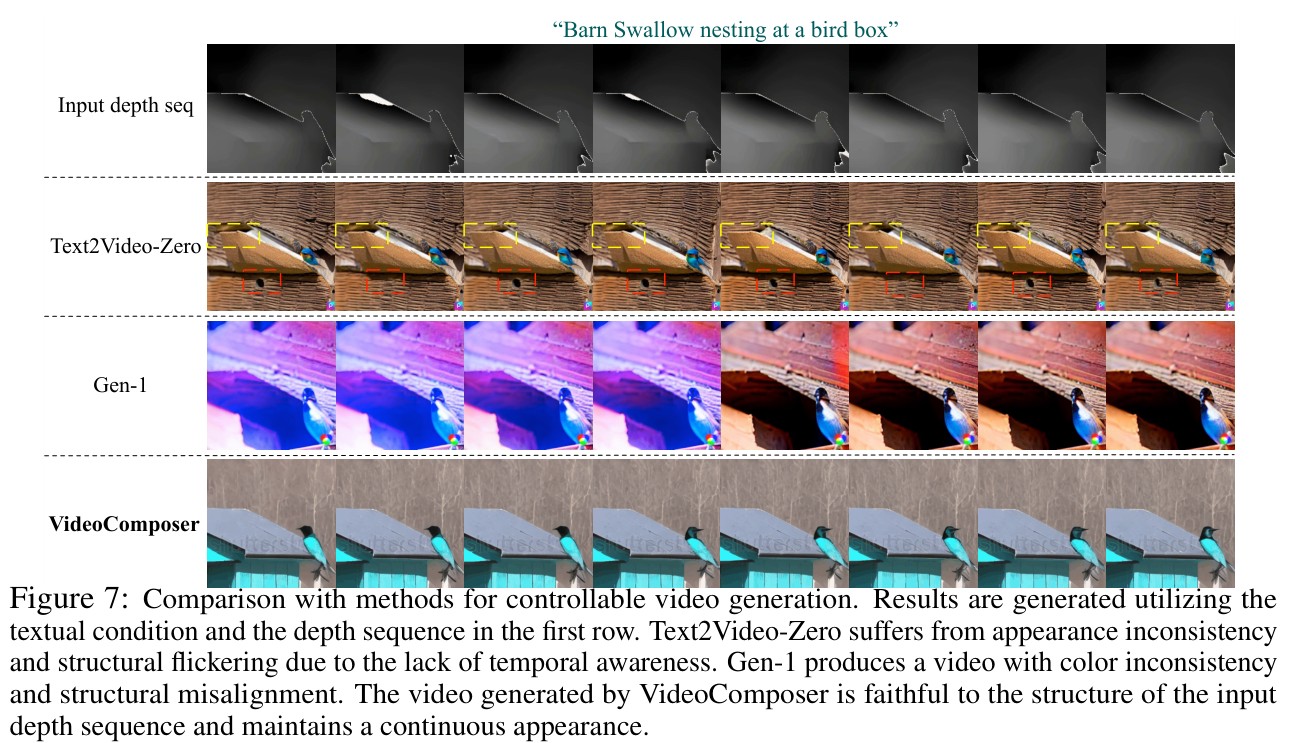
Figure 7 使用文本和深度序列,对照 Text2Video-Zero、Gen-1 与本文。作者指出前者外观不一致 / 结构闪烁,Gen-1 鸟头方向与颜色存在偏差。这里只有精选案例,缺少对这些基线的同一大规模深度跟随指标,故支持“示例中更一致”,而非所有输入上的统计优势。
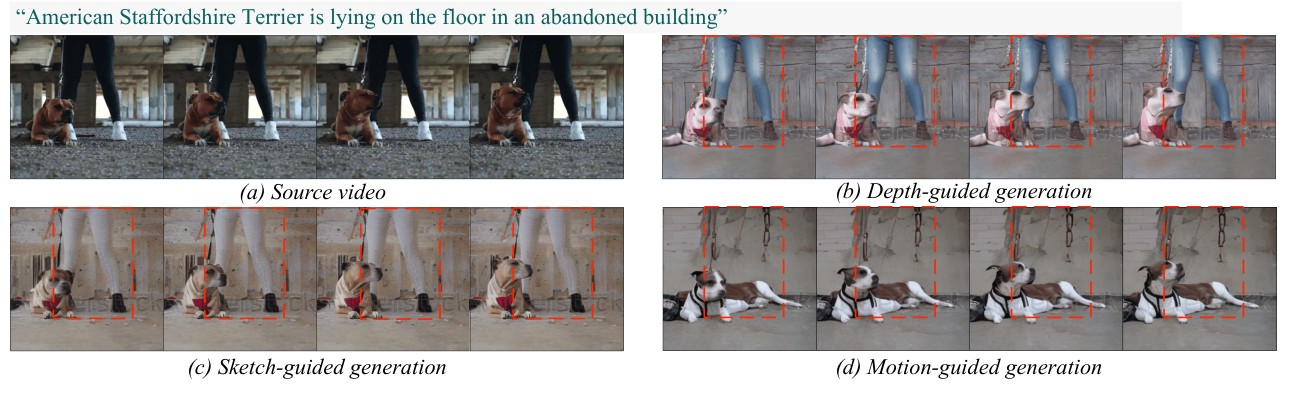
Figure 8 中深度与草图条件仍携带静止背景,而运动向量弱化静止区域,因而能去除原视频中的静止人腿等背景。此为作者展示的效果,不保证任意场景自动分割前景:当相机运动时背景也有运动向量。
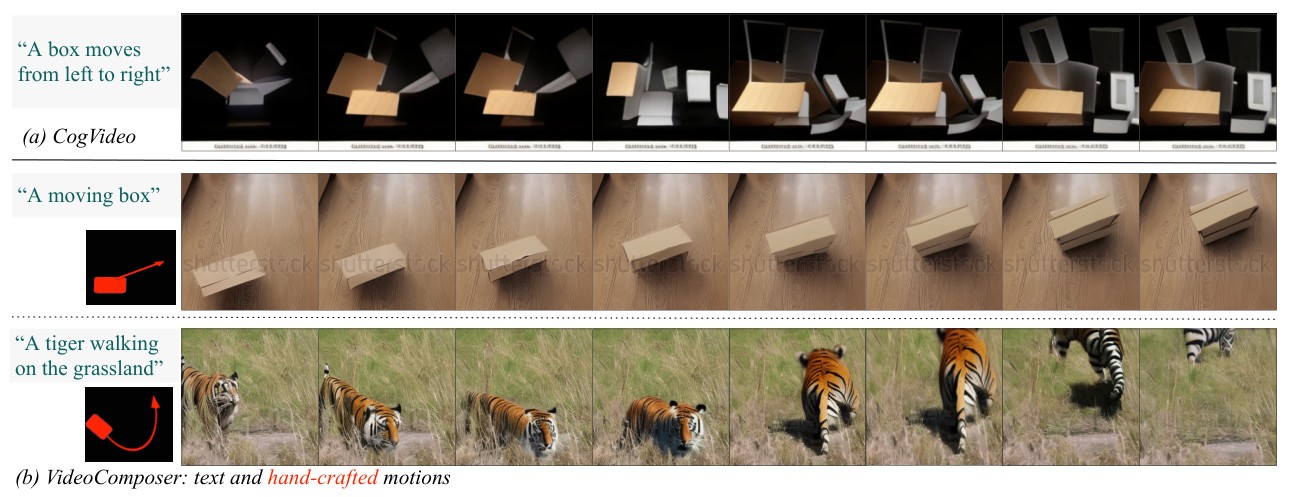
Figure 9 对照 CogVideo 仅文本指导与本文文本 + 人工运动。本文有更直接的轨迹输入,因此展示的是控制接口的价值,不能作为两者在完全相同信息量下的公平性能比较。
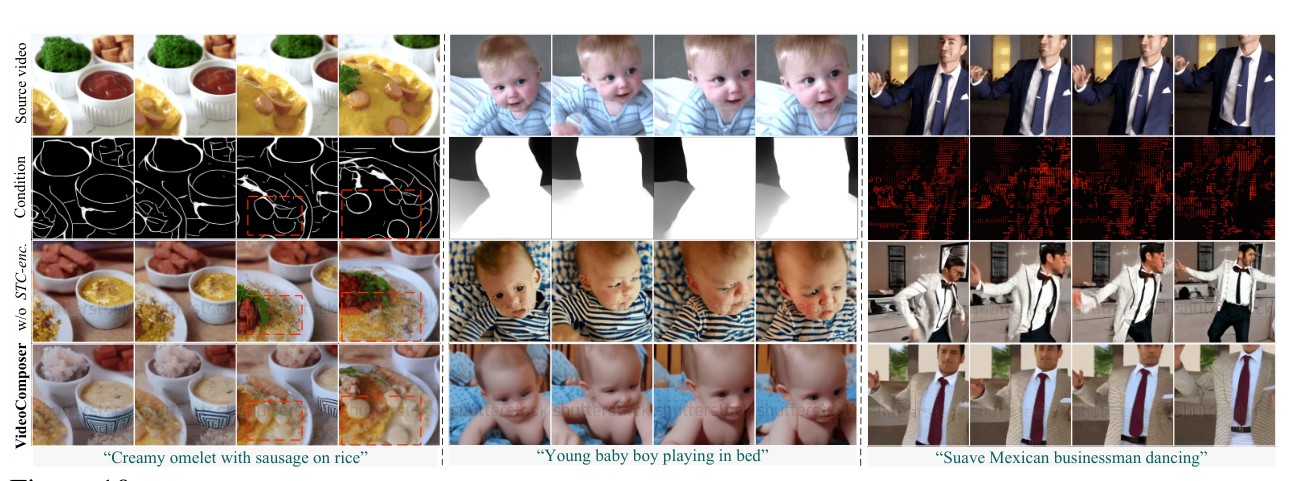
Figure 10 对应 STC 消融:草图例子中漏掉圆形食材,深度或运动例子中人物面部、姿态结构出现偏差。结合 Table 3 可支持“时间条件编码有益”,但静态拼图无法完整呈现闪烁频率,本页没有替代原视频观测。
10 · 附录 A–C 的补充内容
附录 A · 训练和网络补足
关键新增信息已整合至训练与架构章节:400k 总步数及两阶段比例、AdamW 学习率、图像 / 视频 GPU 分配、16 帧 256 分辨率 4 fps、随机条件丢弃、每类条件独立 STC 权重,以及“去 STC”实际只去时间 Transformer。附录没有补齐全部训练资源、参数量或逐实验随机种子,不能把阅读附录等同于可逐比特复现。
附录 B · 从单帧结构扩展到序列控制
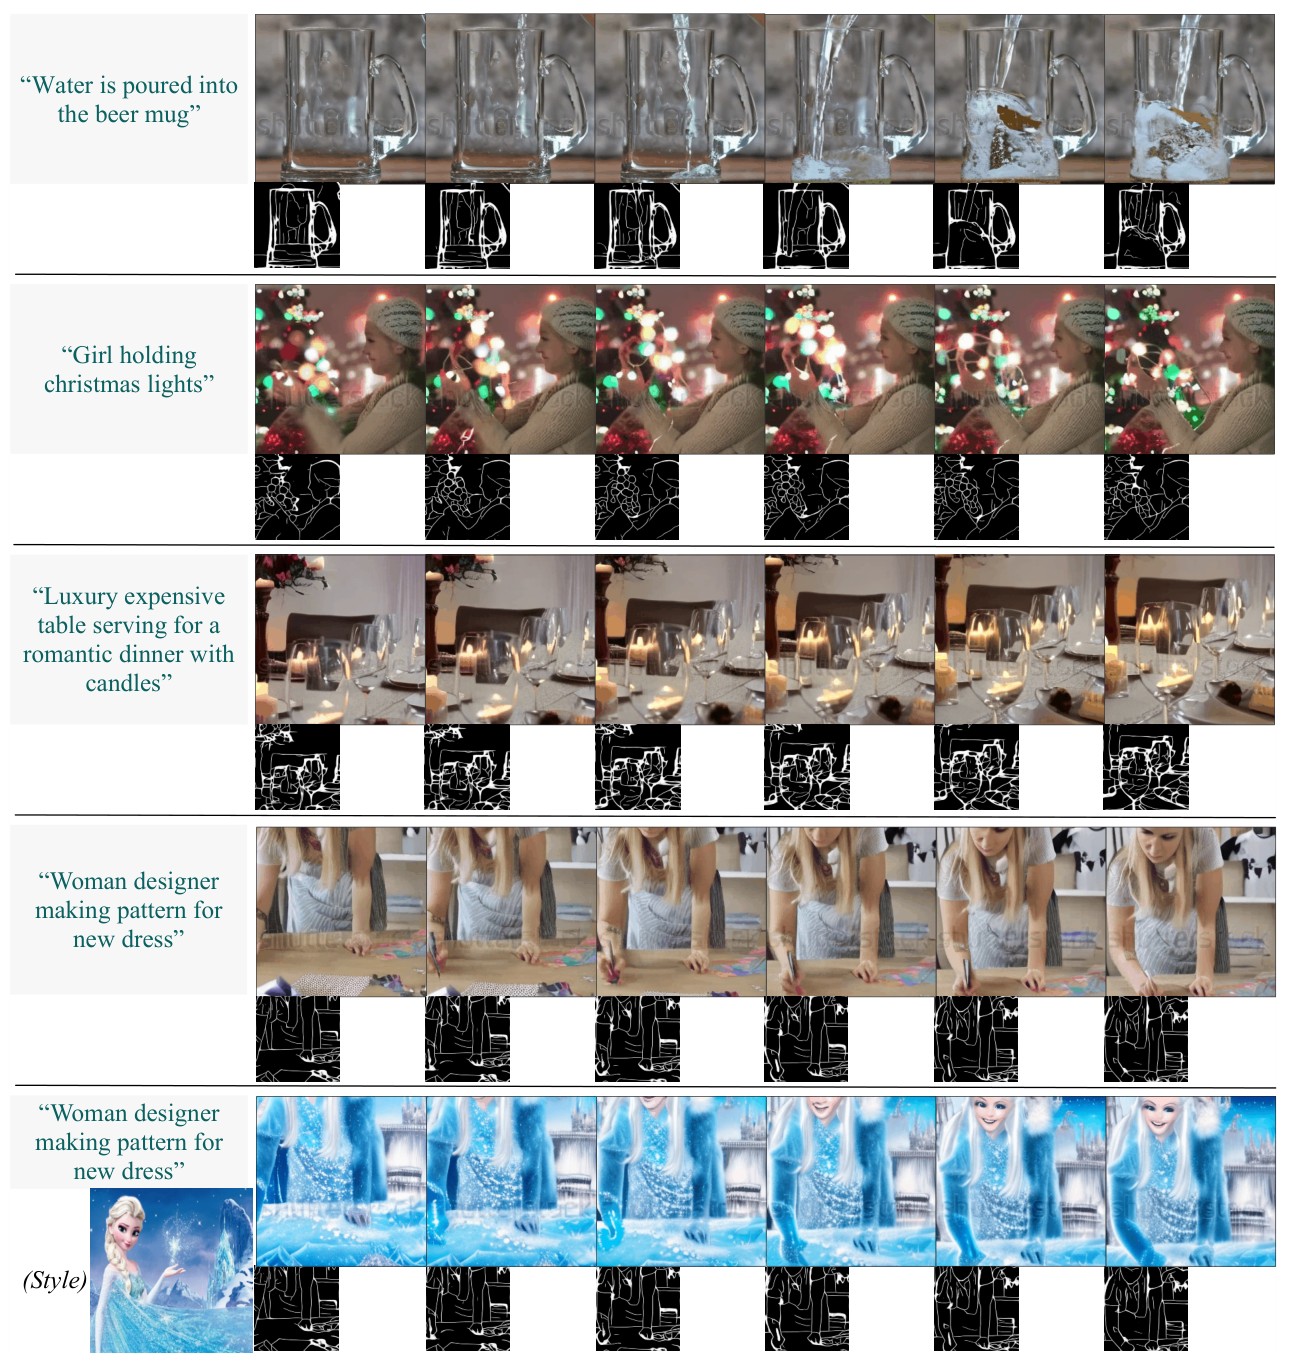
Figure A11 展示五组文本 + 草图序列结果,最后一组额外加入风格图。序列草图规定每帧结构,适用于视频到视频翻译;加入风格仍需避免损失原始几何。
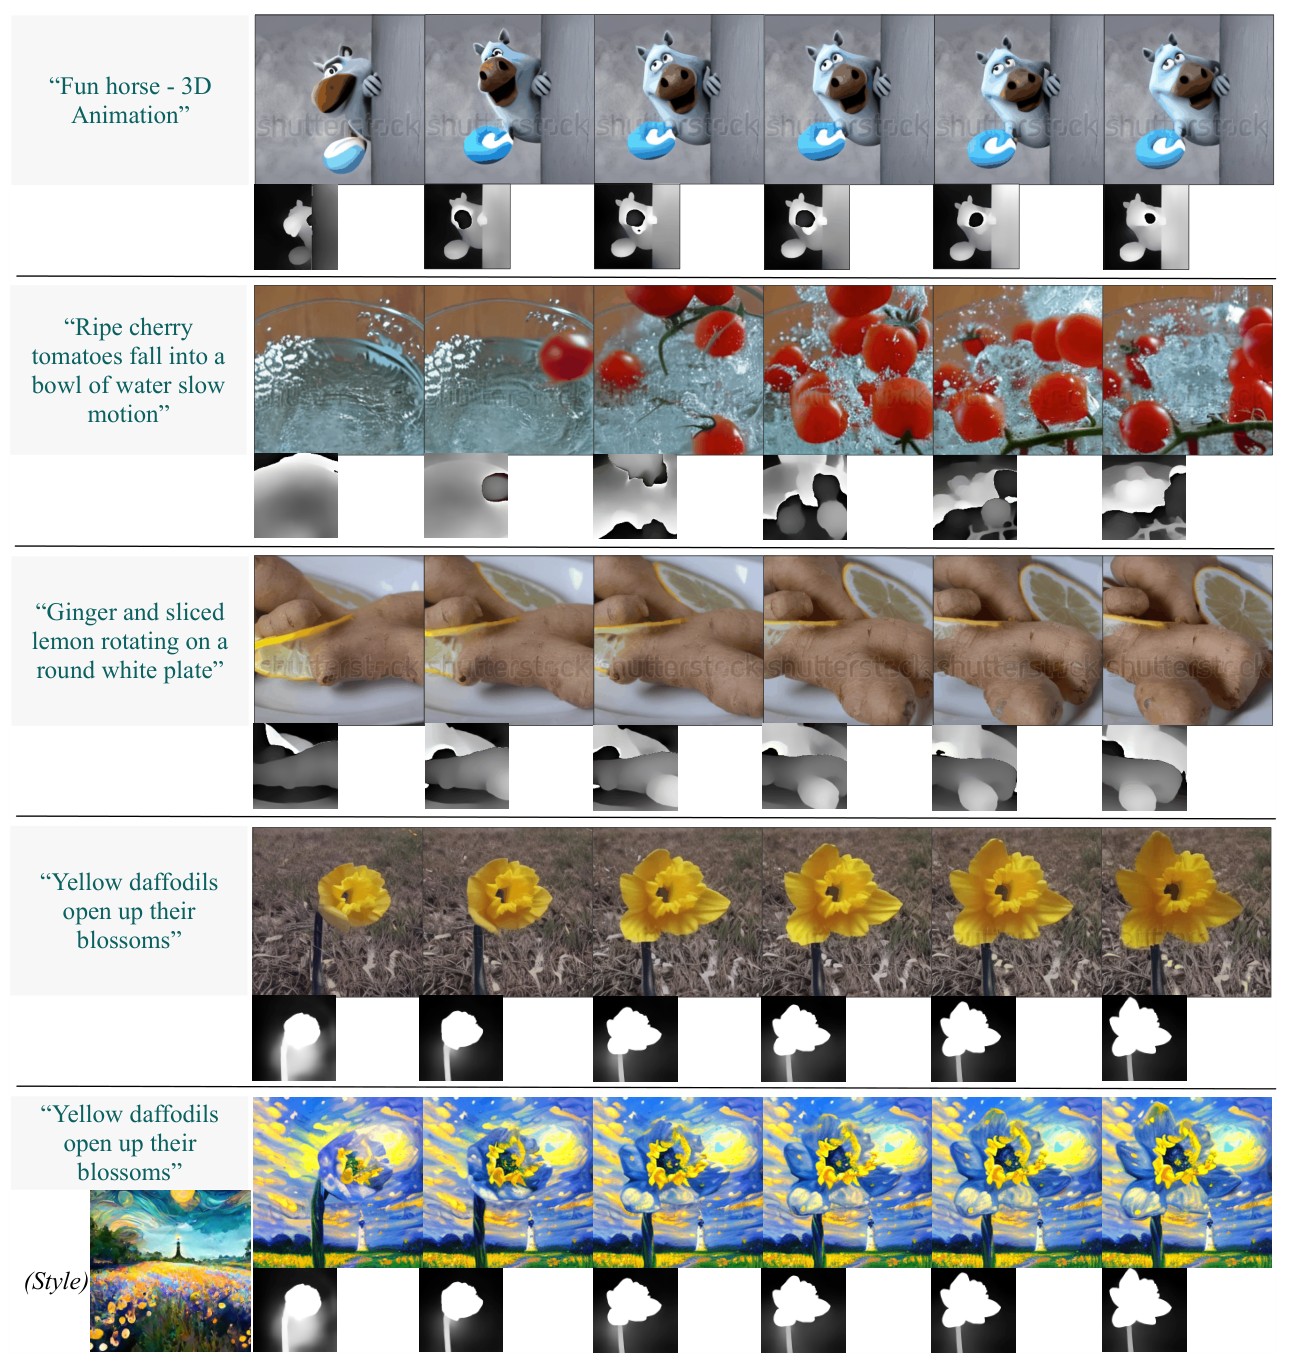
Figure A12 用深度序列 + 文本,最后一组加入风格。与草图序列相比,深度更多提供遮挡、远近关系;其单目深度误差与时间不稳定也会成为条件噪声。
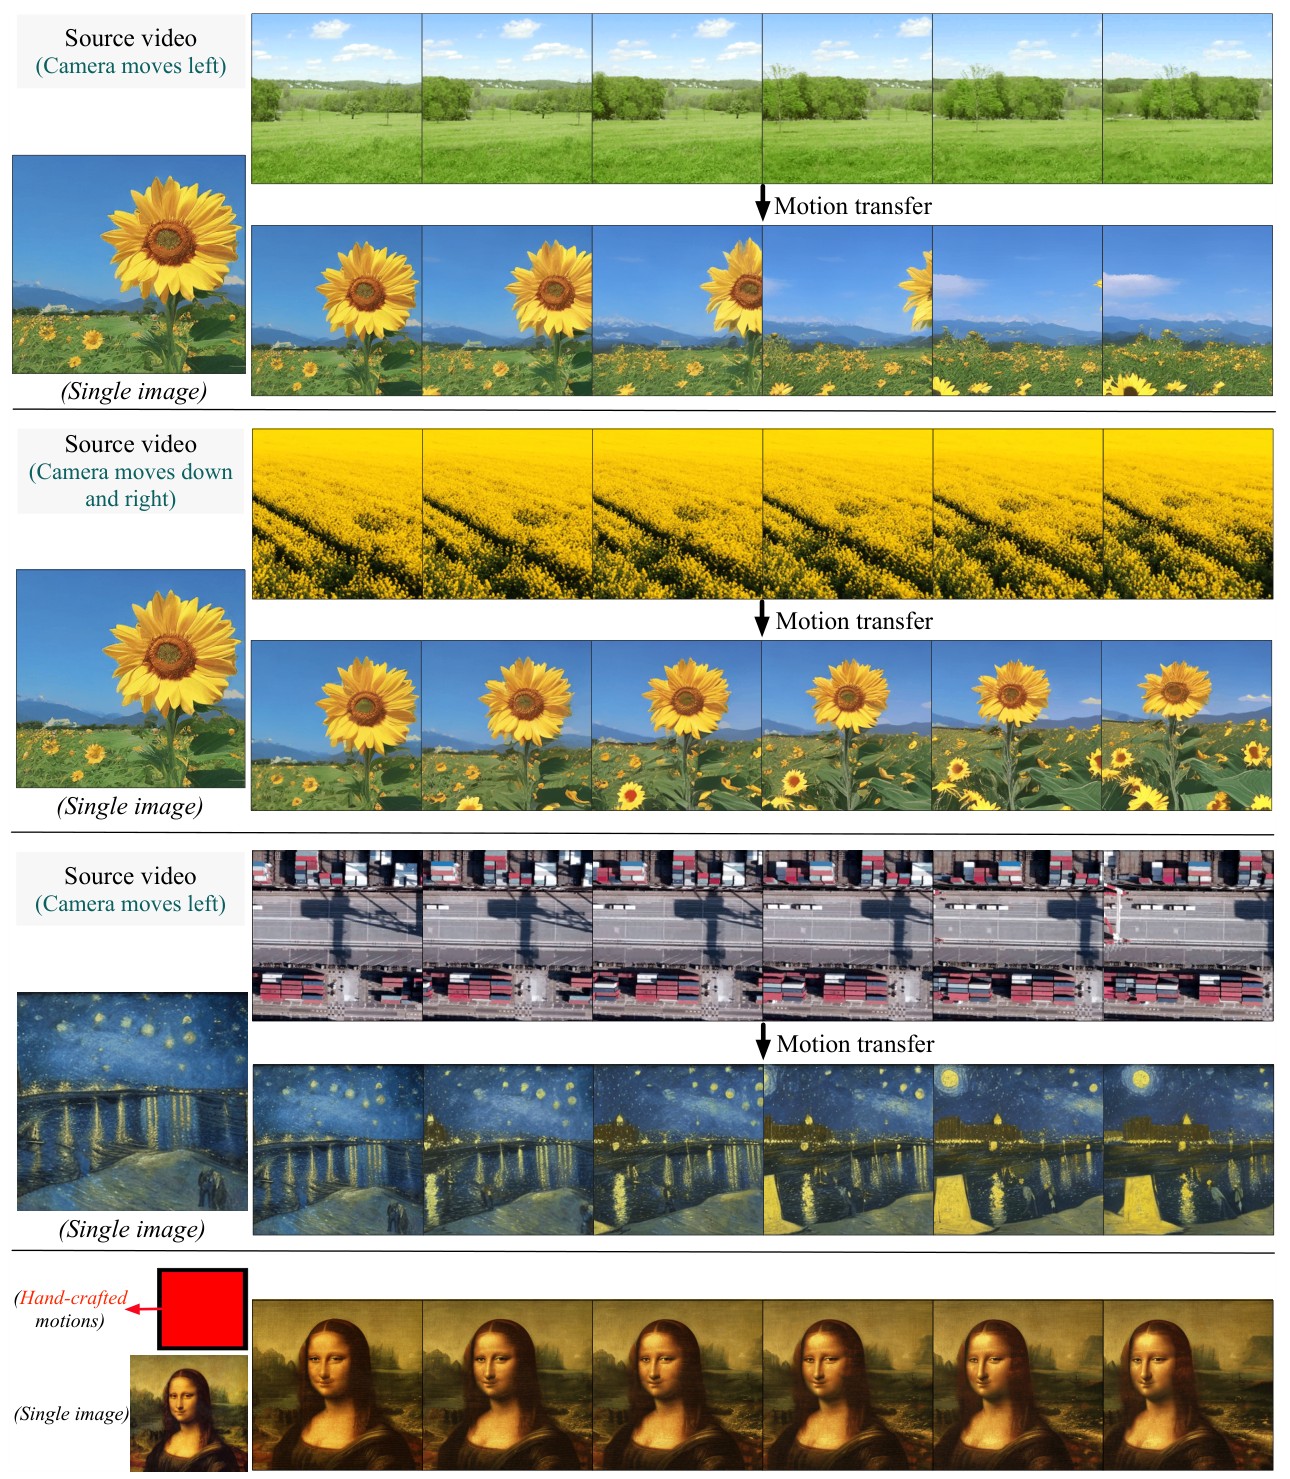
Figure A13 展示四组运动迁移:前三组使用原视频提取的运动向量,将相机运动模式迁移至单幅图像;最后一组使用人工运动。它证明控制来源可以是参考视频或人为信号,但并未量化不同对象形状、视角和遮挡下的运动可迁移边界。
附录 C · 局限与社会影响
作者明确承认 WebVid10M 水印污染和 256×256 分辨率导致细节不足,并提出未来引入超分辨率模型。后者是未来方向,不是本论文实验的组成。模型可能继承 Stable Diffusion、WebVid 与 LAION 的社会偏见,也可能生成冒犯性内容。作者建议部署前进行场景评估与监督,并过滤提示和输出;论文未提供已经验证的完整安全防护系统。
来源:附录 A–C,第 15–18 页。
11 · Reviewer 视角与研究延伸
值得保留的设计
- 条件分工清楚:文本负责粗粒度语义,空间条件负责外观/结构,时间条件提供轨迹。把任务变化转为条件组合,让同一模型支持多种编辑方式。
- STC 的接口简单:各模态编码后对齐 latent 空间,逐元素相加与通道拼接便于扩展;条件编码器内的时间建模由数值消融支持。
- 运动条件实用:压缩域 MV 与人工轨迹让用户不必完全依赖复杂自然语言描述运动,支持更可操作的控制。
证据不足之处
- 统计评估有限:无误差条、重复种子与显著性检验;1000 例评估的具体来源划分和抽样清单不充分。大量能力结论依赖精选图例。
- 一致性指标可能奖励静止:CLIP 相邻帧相似度并不直接评价几何连续性或真实运动,需要与 motion error、运动幅度及感知人工评价共同解释。
- 条件组合不等于可组合泛化已被证明:没有系统列出训练见过/没见过的组合与组合冲突测试;相加融合如何处理不一致的文字、深度和 MV 没有量化。
- 计算与复现缺口:缺少总训练算力、显存、速度、参数量与完整训练超参数;发布推理脚本与默认配置还存在需追踪的覆盖关系。
- 精度与时长边界:16 帧低分辨率实验不能支持长视频、多镜头、精确身份保持或物理仿真的广义结论。
可检验的后续研究,不是论文结果
- 冲突感知条件融合:用每模态 gating、空间置信度或条件优先级替代简单加法;建立文字–深度矛盾、MV–遮挡矛盾的受控测试,评价哪种约束被遵守。
- 压缩 MV 与光流鲁棒性:按码率、压缩器、相机运动、遮挡比例分层,比较原始 MV、稠密光流、置信度增强 MV 的控制精度与提取成本。
- 更好的运动指标:同时报告物体轨迹误差、背景稳定性、身份保持、非零运动幅度及人工评分,避免单一 CLIP 一致性奖励不动视频。
- 面向程序材质的迁移:可借鉴“条件统一编码”来融合纹理参考、法线/深度、材质参数和多视角渲染;但本文没有生成 shader / SBS 节点图,也没有可微渲染闭环。若引入材质图生成,需另建可执行性约束、参数合法性及多光照渲染评价。
阅读结论:VideoComposer 最可靠的贡献是展示显式运动条件与时序条件编码可以提高短视频的可控性,并把多种控制任务放进一个模型。它不是精确模拟器,也没有证明所有条件都可以无冲突地任意组合。
12 · 来源、归档建议与验收边界
- NeurIPS 2023 官方条目:标题、作者、venue、DOI 10.52202/075280-0334。
- 固定官方 proceedings PDF:18 页;SHA-256
0dd1f388250446cb2e8e73dc7191d472bab1c1ddf4ef9ba441a34c0c7492c0e7。 - arXiv 2306.02018:同名论文入口,未将 proceedings 文件强行映射到具体 arXiv 版本。
- 官方项目页:更多动态结果;本页嵌入的 13 张静态图从固定 PDF 提取并注明页码。
- 官方仓库固定提交:只读核查 README、config 和推理调用,没有安装依赖或运行模型。
归档建议:复用已有 PDF 与笔记,追加本精读;first_authors 应补充 Dayou Chen。建议补充 DOI、arXiv 标识和 project_page;通讯状态保持 unverified,Jingren Zhou 仅为候选。核对并复用 Xiang Wang、Hangjie Yuan、Shiwei Zhang、Dayou Chen 及 Jingren Zhou 的 People 记录,避免同名人物误合并。本交付仅提供候选追加与合并稿,未写入实际仓库、People 或共享索引。
验收说明:执行文件大小、数学源码、导航目标、内嵌图片解码、完整原表和笔记原始字节前缀检查;真实浏览器 MathJax、响应式布局与图片视觉阅读验收按当前任务要求延期。没有运行模型、构建站点或部署。图表归原作者;研究代码、权重、完整 PDF 与第三方许可证不作为本精读交付包内容。