传递“鼻子在哪里、翅膀如何动”,而不是复制源物体全部轮廓
01 · 从“保住形状”到“换掉主体”
VideoSwap: Customized Video Subject Swapping with Interactive Semantic Point Correspondence。本文精读固定于 arXiv:2312.02087v2(2023-12-05),包括 11 页主文与参考文献、5 页补充材料,共 16 页。官方代码 README 标注 CVPR 2024;不能把该版本 PDF 的年份直接改称 2024,也不能把后来的重新实现当成原实验代码。第一作者 Yuchao Gu,PDF 明确标星的通讯作者为 Mike Zheng Shou;首位作者单位为 National University of Singapore / Show Lab,合作单位为 Meta GenAI。[PDF p.1]
ED-LoRA 提供目标身份,点轨迹提供动作,AnimateDiff 提供基本时间一致性
一一对应则沿用点;缺少部件则删点;比例变化则拖点并传播位移
核心结论:在一个源视频上注册轻量点条件,可以兼顾目标主体身份、源动作与形状变化。其价值不在于完全自动或实时,而在于减少稠密控制信号对目标形状的锁定。100 步注册约 3 分钟,完整普通预处理约 4 分钟;若需要拖点,另需约 2 小时训练视频的 LNA。[补充 §7]
证据标签:下文“论文事实”指固定 PDF 的方法或测量;“作者解释”指作者对机制的解释;“阅读判断”指依据证据做的批判性解读;“研究延伸”指尚未验证的建议。此处不声称执行过代码、复现过指标或观看核验过全部视频。
02 · 为什么稠密对应会妨碍主体替换
视频编辑面临两个互相牵制的要求:生成结果要沿着源视频的动作轨迹变化,同时目标主体必须保有自己的外观与形状。边缘、深度、光流、注意力或 deformation field 能很好地约束每一帧,却可能把“源吉普的高窄形状”强加给“目标低矮跑车”,或把飞机机翼保留在直升机上。以源视频微调模型还会把其颜色、纹理和结构一起写进权重,形成 appearance / structure leakage。[§1–2]
作者假设:只用少量有明确语义的点,已足以描述主要动作;减少空间约束后,生成先验有机会补全正确的目标形状。这不是“越少的点总是越好”:删点也会丢失运动约束,论文局限部分明确承认这一代价。
原 Figure 1 · 总览与既有方法对照
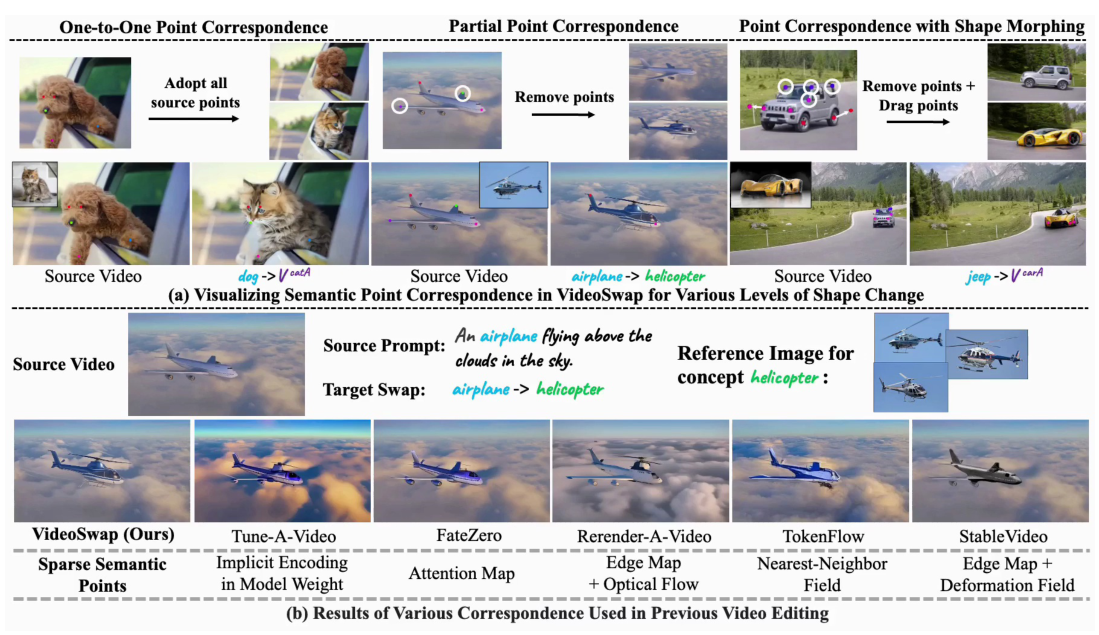
图中飞机的翼、机头、尾部等点代表可迁移的运动骨架;狗换成定制猫展示直接对应;飞机换直升机展示删翼点;吉普换跑车展示拖点改变比例。右侧与隐式运动微调、稠密约束方法的比较突出形状泄漏。该 PDF 图含可播放视频,静态截帧不足以验证时间一致性,此处保留原图编号及动态来源入口:原 Figure 1 / 官方动态补充。
原 Figure 2 · 定制身份与替换示例
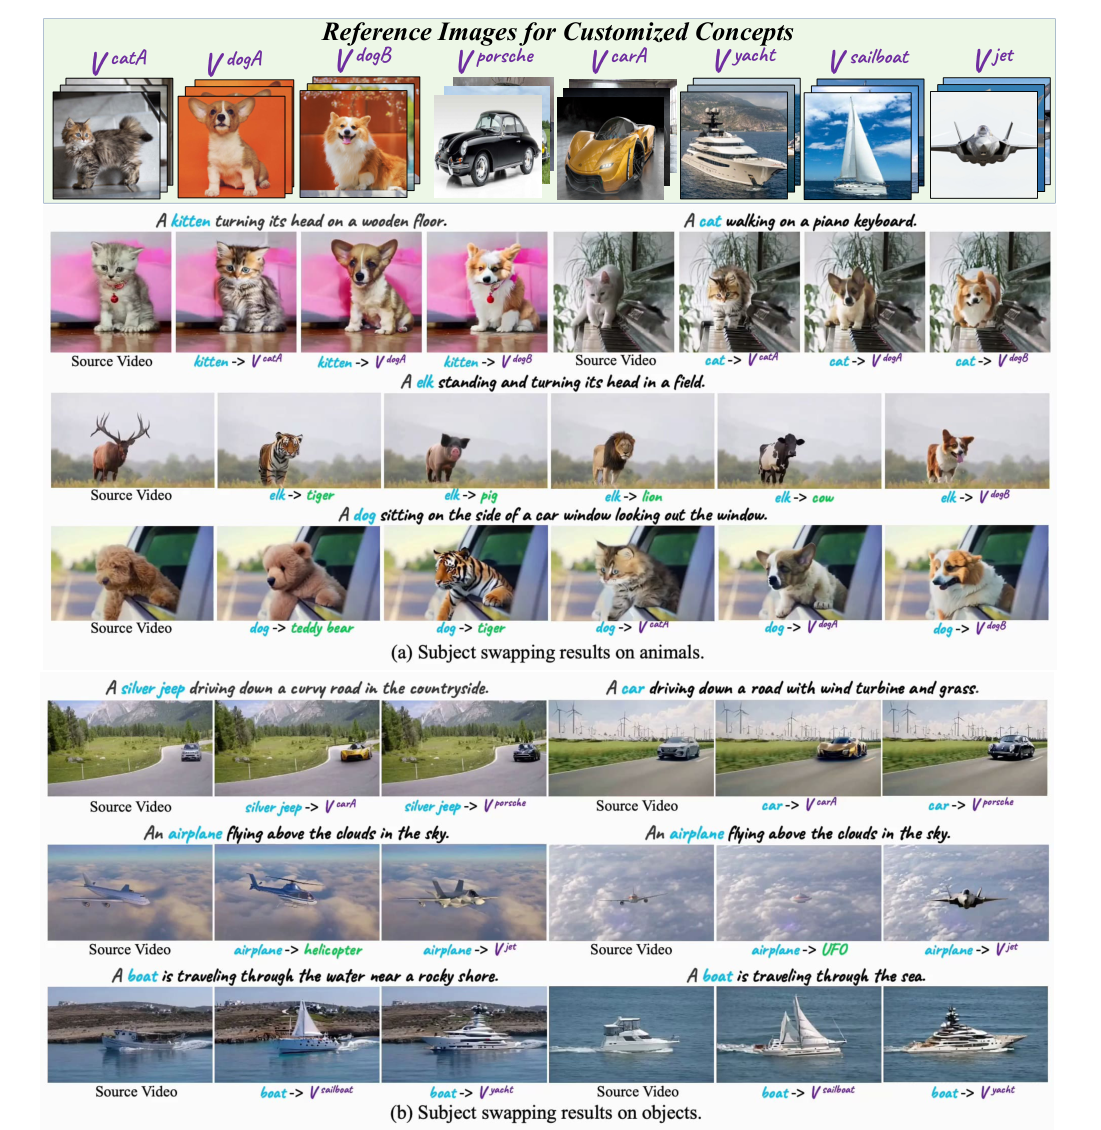
上图包含原 Figure 2 的参考图及 PDF 动态面板的静态首帧;动态结果另见官方补充,未做播放验收。参考图包括猫、两种狗、Porsche、其他汽车、游艇、帆船、喷气机等概念;以特殊概念 token 表示 ED-LoRA 身份。作者称因法律原因不展示人物替换定性结果,因此不能由公开动物/物体画廊推断人物效果同样充分。评测集合含人物,但公开可视证据与评测覆盖并不完全重合。
原 Figure 3 · 支撑假设的小实验
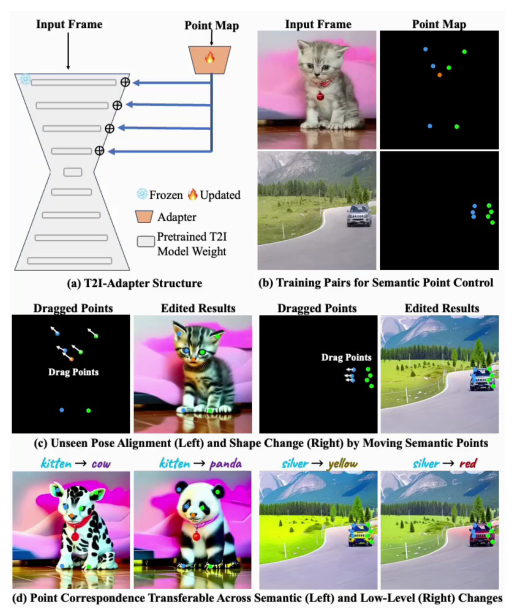
作者在同一视频的 8 帧手工标注同一组语义点,用 T2I-Adapter 训练。拖动猫脸点可以产生训练中未见的姿态,拖动车身边缘点可以改变形状;改变文本语义或低层属性后,控制还能迁移。它证明了特定视频上的可行性,并不证明开放类别通用点控制已经学成。[原 Figure 3,§3.1]
相关工作定位:Tune-A-Video 把运动隐式编码进权重;FateZero、Video-P2P 交换注意力;Rerender-A-Video / ControlVideo 使用更密集的空间控制;TokenFlow 利用特征对应;LNA / StableVideo 类方法依赖 canonical representation。ED-LoRA 属于可利用多视图参考的调优式定制。VideoSwap 的新意是把“点的语义、点的轨迹与轻量注册”连接成可操作的主体交换系统,而非新训练一个大规模视频基础模型。
03 · 输入、输出与完整推理链
输入:源视频的 \(N\) 帧、源文本描述、替换目标描述、关键帧上用户指定的 \(K\) 个语义点;定制目标还需代表性参考图与已训练 ED-LoRA。拖点场景另需源视频的 Layered Neural Atlas。输出:背景尽量不变、目标身份与形状正确、动作与源视频对齐的新视频。
| 符号 | 含义与角色 |
|---|---|
| \(z_0,z_t,z_T\) | VAE 编码后的干净视频 latent、中间带噪 latent、DDIM 反演得到的起始噪声 |
| \(P_{\mathrm{coord}},\operatorname{Tra}(k)\) | 全部点轨迹;第 k 个语义点在每帧的二维坐标和帧序号 |
| \(D_n,v_n^k,v^k,P_{\mathrm{emb}}\) | 第 n 帧 DIFT 特征、该帧第 k 点特征、跨帧平均语义特征、全部点特征集合 |
| \(\phi_l,F_c^l,F_{\mathrm{enc}}^l\) | 第 l 级两层投影 MLP、稀疏条件特征、U-Net 编码器特征 |
| \(\theta,\phi,p,\Omega\) | 基础噪声预测网络参数、所优化的点投影参数、文本嵌入、点附近的二值损失 mask |
| \(\mathcal M,\mathcal B,J_{\mathcal M},J_{\mathcal B}\) | 像素到 canonical 坐标映射、反向映射及各自局部雅可比 |
原 Figure 4 · 总流程
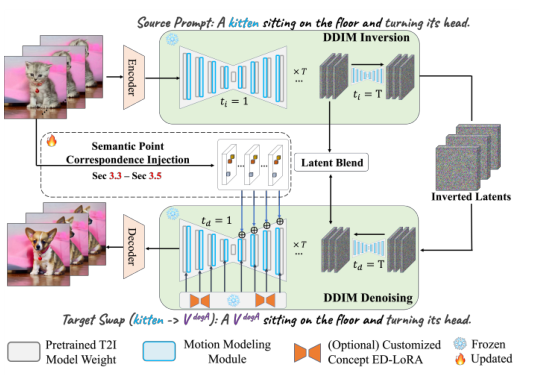
- 通过 VAE 将源视频编码为 \(z_0\),用 DDIM inversion 得到 \(z_T\),同时保存反演过程 latent 与源主体 attention mask。
- 用户选择关键帧与语义点;点追踪/检测得到跨帧轨迹,DIFT 提取并平均同一语义点特征。
- 固定基础生成能力,在源视频上优化点特征投影 MLP,建立点条件与该视频主体的语义控制关系。
- 在文本中换成预定义概念或定制概念;必要时加载对应 ED-LoRA;按语义对应关系沿用、删去或拖动点。
- 从同一个反演噪声启动 DDIM 去噪,将稀疏语义条件加入多尺度 U-Net。AnimateDiff motion layers 提供基础跨帧协调。
- 每个时间步合并源/目标主体 mask,在编辑区域保留生成 latent,背景区域混回反演 latent,最后 VAE 解码。
分工边界:点控制不是身份模型,motion layer 也不是源动作提取器。仅用 AnimateDiff + DDIM 可以生成一致视频,却可能不遵循源动作;ED-LoRA 决定“像哪个主体”;语义点约束“它的相应部位如何移动”。[§3.2]
04 · 点语义提取、稀疏特征与注册目标
原 Figure 5 · 提取与注册
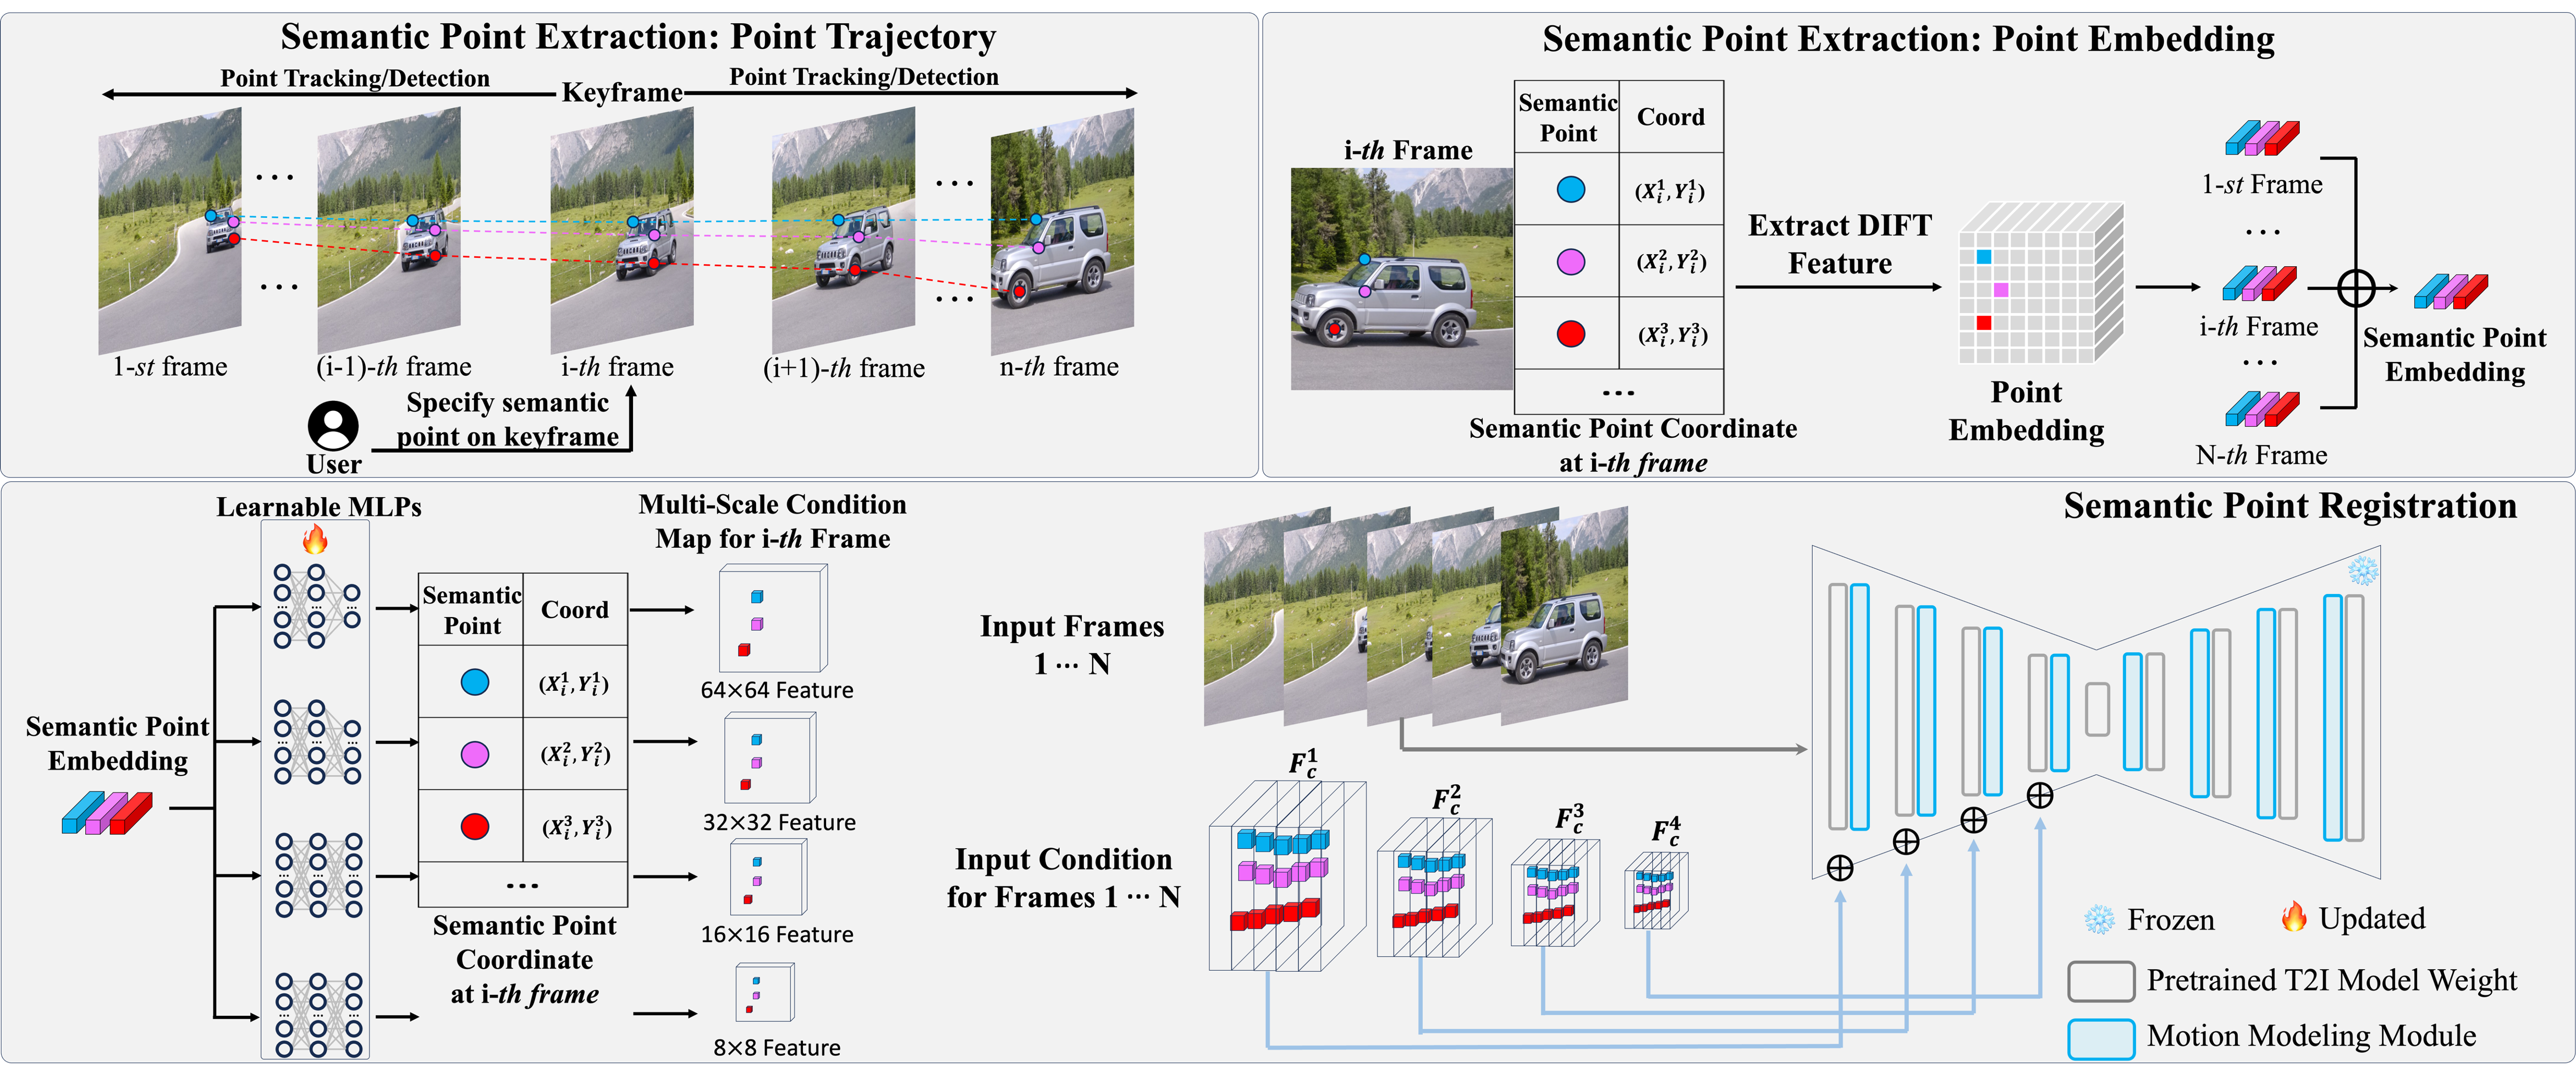
对关键帧的 \(K\) 个点,Co-Tracker 或相应检测器补齐其他 \(N-1\) 帧轨迹。人体检测器只是可选的特定类别工具,并非要求所有开放类别都套用固定人体骨架。轨迹表示为:
\[P_{\mathrm{coord}}=\{\operatorname{Tra}(k)\}_{k=1}^{K},\qquad \operatorname{Tra}(k)=\{(x_n^k,y_n^k,n)\}_{n=1}^{N}.\]
在每帧 DIFT 特征图上取点对应位置,平均得到跨帧语义表示:
\[v_n^k=D_n(x_n^k,y_n^k),\qquad v^k=\frac{1}{N}\sum_{n=1}^{N}v_n^k,\qquad P_{\mathrm{emb}}=\{v^k\}_{k=1}^{K}.\]
这一步用同一语义点的多帧观察稳定其描述,而不是让每帧有一套完全独立的身份。前提是轨迹对应准确;被遮挡或跟错的点也可能污染均值。论文没有在此给出基于追踪置信度的加权聚合,这属于后续改进空间。[§3.3]
Algorithm 1 · 稀疏条件不是一张稠密控制图
对四级 U-Net 编码器,创建与该级特征同形状的零张量。文中以 latent 尺寸 \(H,W,N\) 表示输入,并写第 l 级空间尺寸为 \(H/2^l,W/2^l\)。将点坐标按对应尺度除以 \(2^l\) 并 round;用各级两层 MLP 把同一个点语义投影至该级通道数,然后只在点位置赋值:
\[F_c^l\left(\operatorname{round}(x_n^k/2^l),\operatorname{round}(y_n^k/2^l),n\right)=\phi_l(v^k),\quad l\in\{1,2,3,4\}.\]
其余位置保持零。论文 Algorithm 1 是赋值而非求和;若多个点量化到同一位置,冲突如何处理、像素坐标如何先转换至 latent 网格,需要实际实现进一步核查,不应从此伪代码擅自补出确定规则。
\[F_{\mathrm{enc}}^l\leftarrow F_{\mathrm{enc}}^l+F_c^l,\qquad l\in\{1,2,3,4\}.\tag{1}\]
式 (1) 在 U-Net 多级编码中逐元素加入条件。作者解释:稠密 T2I-Adapter 输出会在背景也产生可学习特征,容易记住源视频;稀疏写入限制了条件自由度,使背景不会随点条件一起被编码。
式 (2) · 只学习语义点附近、高噪声时段的去噪
\[\min_{\phi}\ \mathbb E_{\epsilon\sim\mathcal N(0,I),\,t\sim U(T_{\min},T)}
\left\|\left[\epsilon-\epsilon_{\theta}(z_t,t,p,\phi(P_{\mathrm{emb}}))\right]\odot\Omega(P_{\mathrm{coord}})\right\|_2^2.\tag{2}\]
\(\epsilon\) 为加入 latent 的高斯噪声;预测器输出噪声;\(\Omega\) 只保留点附近的局部误差;\(\odot\) 是逐元素乘法。优化变量明确是 \(\phi\),不是另行训练整个基础视频模型。该公式将稀疏坐标放置简写进条件表达;实现时仍需 Algorithm 1 的轨迹定位,不能仅把向量列表传给 U-Net。
- Point patch loss:只重建点附近 \(4\times4\) patch。若用整帧重建,会奖励记住源物体全轮廓,从而削弱更换形状的能力。补充未充分说明 patch 大小的坐标单位,复现时应从实际配置确认,不能自行说成最终 RGB 的 4 像素。
- Semantic-enhanced schedule:设 \(T_{\min}=T/2\),只在高噪声时段注册。这里“early sampling steps”是逆扩散早期,也即数值较大的 t,不是低噪声的最后几步。作者希望学习高层语义而非精细纹理。
- DIFT 初始化:提供预先存在的语义信息,让 100 步注册接近随机可学习嵌入训练 300 步的效果。它支持更快适配的解释,但不是完整端到端耗时减为三分之一。
05 · 沿用、删点、拖点:形变的三种边界
一一语义对应时直接使用源点序列;部分对应时删除不存在部件的点,例如飞机到直升机去掉翼点但保留机头、尾部;语义部位对应而比例不匹配时,用户在关键帧移动相应点。删除点无需重新定义整个密集场;拖点的难点在于如何让整段视频共同改变,而不是只让单帧正确。[§3.5]
原 Figure 6 · 通过 canonical 空间传播位移
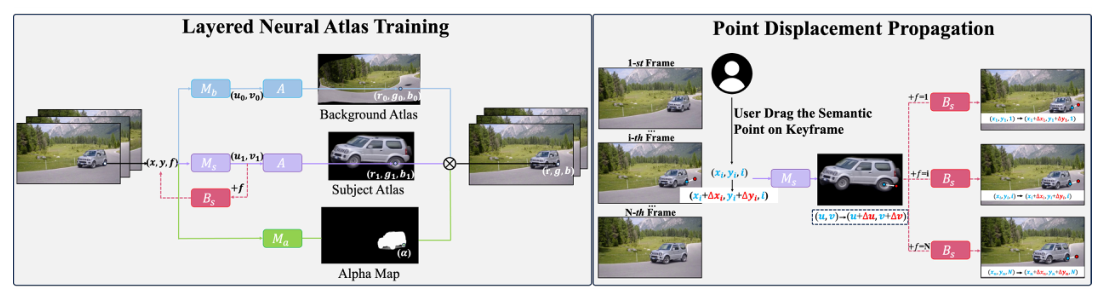
LNA 学到像素/时间到二维 canonical 空间的前向映射 \(\mathcal M:(x,y,f)\mapsto(u,v)\),及给定帧的反向映射 \(\mathcal B:(u,v,f)\mapsto(x,y)\)。设原轨迹为 \(P(f)\),关键帧拖动量为 \((dx,dy)\),先做局部线性近似:
\[\begin{bmatrix}du\\dv\end{bmatrix}=J_{\mathcal M}(x,y,f_{\mathrm{key}})\begin{bmatrix}dx\\dy\end{bmatrix}.\tag{3}\]
这里不是把同一个像素偏移硬加给所有帧,而是把它变为 canonical 空间的偏移;随相机/物体运动,该偏移在每一帧像素中的表现不同:
\[P'(f)=P(f)+J_{\mathcal B}(u,v,f)\begin{bmatrix}du\\dv\end{bmatrix}.\tag{4}\]
符号勘误提示:正文式 (4) 后印成 \((u,v)=B(x,y,f_{\mathrm{key}})\),与前面定义的方向不相容;按前向映射应理解为 \((u,v)=\mathcal M(x,y,f_{\mathrm{key}})\)。补充 §6.2 对反向映射文字和输入输出也有不够一致的表述。本页明确指出差异,不声称原文已无歧义。
式 (5)–(6) · 有限差分的可实现解释
原文使用两次邻近坐标查询近似雅可比。按二维向量映射,将每个有限差分向量放入矩阵的一列,可无歧义地写成下式;这是对原式排版的等价解释,非新增学习目标:
\[J_{\mathcal M}\approx\left[\frac{\mathcal M_s(x+\varepsilon,y,f)-\mathcal M_s(x,y,f)}{\varepsilon}\quad
\frac{\mathcal M_s(x,y+\varepsilon,f)-\mathcal M_s(x,y,f)}{\varepsilon}\right].\tag{5}\]
\[J_{\mathcal B}\approx\left[\frac{\mathcal B_s(u+\varepsilon,v,f)-\mathcal B_s(u,v,f)}{\varepsilon}\quad
\frac{\mathcal B_s(u,v+\varepsilon,f)-\mathcal B_s(u,v,f)}{\varepsilon}\right].\tag{6}\]
\(\varepsilon\) 是小坐标位移,\(s\) 表示前景 subject 映射。两次局部线性化意味着大幅拖动、映射奇异或未被训练覆盖的区域可能不可靠。论文没有给出通用误差界,也未在本文报告可复用的 \(\varepsilon\) 数值。
补充 §6.2 · LNA 训练究竟额外做了什么
前景、背景各有坐标映射 MLP;atlas MLP 把 UV 坐标映为 RGB;opacity MLP 从像素和帧预测混合权重。训练重建源视频 RGB,并使用 rigidity loss 保持局部刚性、基于预计算光流的 consistency loss 约束相邻帧对应、sparsity loss 抑制 canonical 空间重复内容。VideoSwap 只需要前后向坐标映射,不需要完全收敛的纹理 atlas,故作者称训练可由原 LNA 约 10 小时缩短至约 2 小时。完整损失权重、训练迭代和网络规格需查 LNA / INVE 及其配置,本文没有提供完整清单。[补充 §6.2]
06 · 背景保持与可复现设置
Latent blending:为新旧轮廓留出空间
从主体 token 的 cross-attention 提取反演过程主体 mask \(M_t^i\) 和去噪过程目标 mask \(M_t^d\),取并集作为需要允许变化的区域,再混合 latent:
\[M_t=M_t^i\cup M_t^d,\qquad z_t=(1-M_t)\odot z_t^i+M_t\odot z_t^d.\]
并集覆盖旧主体和新主体占据的区域,避免只保留旧轮廓而剪掉新形状。并集外回填源反演 latent,内侧保留新结果。该过程保留的是 latent 级背景条件,不保证最终逐像素严格相同;mask 质量、VAE 重建误差、边界和去噪都会影响结果。正文公式为补充 §6.1 未编号公式,不能遗漏。[补充 §6.1]
| 项目 | 论文提供的设置 | 复现时需要注意 |
|---|---|---|
| 生成底模 | Latent Diffusion Model + AnimateDiff pretrained motion layers | 本文实验细节没有明确所有 checkpoint / revision;未报告基础模型总参数量,不存在另一个独立“大模型版”结果组 |
| 定制身份 | ED-LoRA,在一组目标代表图上训练 | 目标参考图数量、训练 steps / rank 等本文未完整给出;不能等同于点注册的 100 步 |
| 视频 | 16 帧,time stride 4 | 匹配 AnimateDiff temporal window;不是证明无限长视频可直接处理 |
| 裁剪分辨率 | 高 × 宽:512 × 512 或 448 × 768 | 输入 aspect ratio 和裁剪会影响可见主体 |
| 优化器与学习率 | Adam,\(5\times10^{-5}\),点注册 100 iterations | 未完整公开 batch size、betas、weight decay、scheduler、warmup、precision、seed |
| 局部损失 | 点周围 4 × 4 patch;\(T_{\min}=T/2\) | 高噪声注册用于减少低层泄漏 |
| 采样 | DDIM;反演计时使用 50 steps | 正文未提供完整 CFG scale 与每个案例 prompt,不能照搬普通 LLM temperature / top-p 参数 |
| 硬件 | Nvidia A100 40GB | 不是“必须用满 40GB”;作者测得注册 16GB、推理 12GB |
| 阶段 | A100、16 帧作者报告 | 是否一次性/重复 |
|---|---|---|
| 轨迹 + DIFT 提取 | 约 30 秒 | 每源视频预处理 |
| 语义点注册 | 约 3 分钟 / 100 iterations | 每源视频预处理 |
| 50 步 DDIM inversion | 约 30 秒 | 每源视频预处理 |
| 普通预处理合计 | 约 4 分钟 | 不含拖点 LNA 与 ED-LoRA 身份训练 |
| 每次生成编辑 | 约 50 秒,含 latent blend | 每目标/每次编辑 |
| 关键帧拖点传播 | 约 1 秒 | 前提是 LNA 已训练 |
| LNA 训练 | 额外约 2 小时 | 需要拖点时,每源视频 |
阅读判断:“交互”表示用户能改变条件,并不意味着实时生成。50 秒一次与 2 小时准备成本限制了探索效率。代码 README 后来声称训练和推理均需 12GB,而固定 PDF 是 16GB/12GB;两者来自不同时间的实现,不能用 README 数值悄悄替换论文测量。
07 · 数据、指标与主结果逐项读
作者收集 Shutterstock / DAVIS 的 30 个视频:人物、动物、物体各 10 个;定制概念共 13 个:人物 5、动物 3、物体 5。每个源视频使用 8 个预定义概念和 2–5 个定制概念作为替换目标,文中称约 300 个编辑结果。其“每视频数量”与“约 300”是粗略说明,缺少逐案例 manifest,不能据此推算精确 300–390 次并当成确认样本数。这是小规模任务评测集,不是训练一个通用大模型的数据集;未给 train/val/test 常规划分。[补充 §8.1]
传统视频编辑方法不支持定制身份,所以该组只评预定义目标;同 AnimateDiff 底模组同时评预定义与定制目标。不能把两个分组跨行直接解释为同样任务上的公平排序。人工评估分四项:目标身份、源动作对齐、时间一致性、总体偏好;Amazon Mturk 发放 1000 份问卷,问卷数不等同于独立参与者数。
原 Table 1 · 主观偏好完整重建
每格为“VideoSwap 胜出比例 / 对手比例”,并非两个系统的准确率。粗体突出每次比较的多数偏好,不是跨不同对手的统一排名。
| 比较分组/对手 | 主体身份 | 动作对齐 | 时间一致性 | 整体偏好 |
|---|---|---|---|---|
| 既有方法:Tune-A-Video | 80% / 20% | 72% / 28% | 80% / 20% | 78% / 22% |
| 既有方法:FateZero | 74% / 26% | 67% / 33% | 73% / 27% | 70% / 30% |
| 既有方法:Text2Video-Zero | 76% / 24% | 71% / 29% | 80% / 20% | 80% / 20% |
| 既有方法:Rerender-A-Video | 81% / 19% | 72% / 28% | 84% / 16% | 84% / 16% |
| AnimateDiff:DDIM | 70% / 30% | 74% / 26% | 69% / 31% | 73% / 27% |
| AnimateDiff:DDIM + TAV | 68% / 32% | 60% / 40% | 66% / 34% | 69% / 31% |
| AnimateDiff:DDIM + T2I-Adapter | 66% / 34% | 59% / 41% | 65% / 35% | 66% / 34% |
对既有方法,整体偏好为 70%–84%;对同底模基线为 66%–73%。最接近的动作对齐对手是 DDIM + T2I-Adapter(59% 对 41%),说明密集控制保动作的能力仍强,VideoSwap 的优势更体现于动作与形状/身份的折中。缺少置信区间、每组投票数、参与者去重和显著性检验,不能断言每个差距均统计显著。[Table 1]
原 Table 2 · 自动评估完整重建
三列均越高越好;— 为原文未评,不能填零。第一组粗体为组内最佳;第二组标最佳和次佳。
| 分组/方法 | 文本对齐 ↑ | 图像身份对齐 ↑ | 时间一致性 ↑ |
|---|---|---|---|
| 既有方法:Tune-A-Video | 25.34(次佳) | — | 95.79(次佳) |
| 既有方法:FateZero | 24.39 | — | 95.49 |
| 既有方法:Text2Video-Zero | 24.85 | — | 95.02 |
| 既有方法:Rerender-A-Video | 24.99 | — | 92.28 |
| VideoSwap | 26.87 | — | 95.93 |
| AnimateDiff:DDIM | 27.36 | 79.79(次佳) | 95.89(次佳) |
| AnimateDiff:DDIM + TAV | 24.75 | 75.93 | 95.49 |
| AnimateDiff:DDIM + T2I-Adapter | 25.86 | 77.54 | 95.50 |
| VideoSwap | 26.87(次佳) | 79.87 | 95.93 |
相对既有组最强 Tune-A-Video,文本分数 +1.53,时间分数 +0.14。相对同底模 DDIM,VideoSwap 的文本分数反而 −0.49,身份图像分数只 +0.08、时间分数只 +0.04。这不是“所有指标大幅领先”。普通 DDIM 虽有高 CLIP 分数,人工动作对齐仍输 26% 对 74%,反映 frame-wise CLIP 对正确源运动不够敏感。
自动指标包括文本 CLIP 对齐、时间一致性,以及定制结果每帧和每张参考图之间的 pairwise image alignment。作者引用既有评测协议而未在这里给出全部聚合实现与 CLIP checkpoint;作者本人将其列为参考,以人工评估为主。图像相似度可能混入背景影响,时间相似度也不等于动作正确;这些是指标解释限制,不是本文实验证明的机制。[Table 2 / §8.2]
原 Figure 7 · 同底模比较要看什么
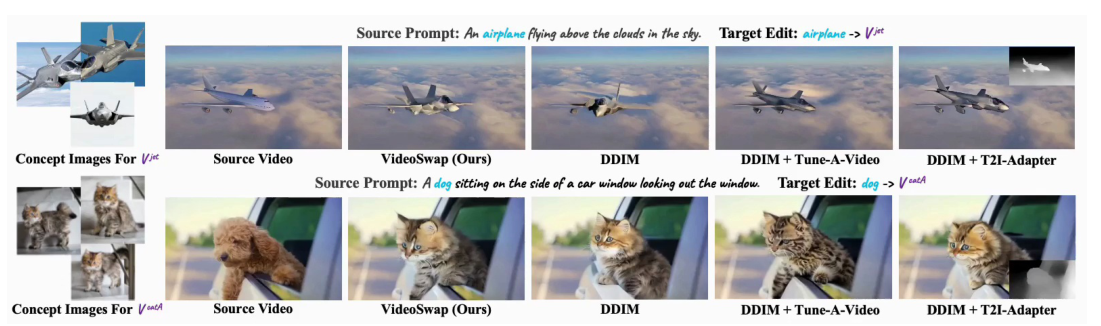
DDIM 缺少源轨迹约束;DDIM+TAV 有动作但泄漏结构/外观;DDIM+T2I-Adapter 的深度等条件限制形状且难以处理可变形运动。VideoSwap 的关键比较是相同基础生成模型、不同 motion guidance,而不是依靠更新的视频底模取胜。动态图见 原 Figure 7 与 补充比较栏;未把静态图当作时间质量测量。
原 Figure 9 · 问卷界面与评估范围
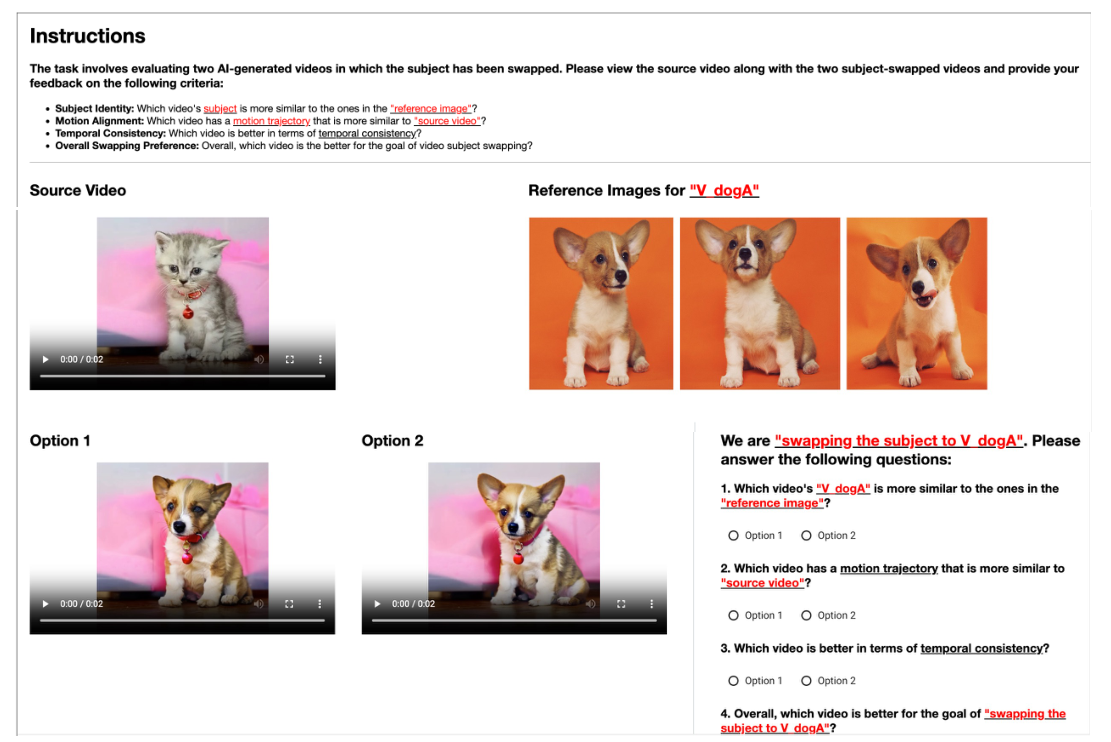
界面同时提供源视频、目标参考图及候选编辑,让评估者按四项标准选偏好。此设计比只问“好不好看”更贴合主体交换,但仍欠缺详细随机化、盲测与投票质量控制描述。
08 · 消融能支持多强的结论
原 Table 3 · 五个消融变体完整重建
完整方法为 DIFT embedding + MLP,100 iterations,启用 point patch loss 与 semantic-enhanced schedule。每格同样是“完整方法 / 变体”的偏好。
| 被比较变体 | 身份 | 动作 | 时间一致性 | 整体 |
|---|---|---|---|---|
| Point Map + T2I-Adapter,100 步 | 87% / 13% | 90% / 10% | 87% / 13% | 90% / 10% |
| Learnable Embedding + MLP,100 步 | 87% / 13% | 95% / 5% | 90% / 10% | 90% / 10% |
| Learnable Embedding + MLP,300 步 | 52% / 48% | 52% / 48% | 52% / 48% | 55% / 45% |
| 去掉 Point Patch Loss | 73% / 27% | 73% / 27% | 78% / 22% | 78% / 22% |
| 去掉 Semantic-Enhanced Schedule | 85% / 15% | 90% / 10% | 90% / 10% | 87% / 13% |
事实:同 100 步时 DIFT 明显更受偏好;随机嵌入增加到 300 步后,差距缩小至接近五五开。可支持的解释:DIFT 主要帮助快速获得可用控制语义。不能支持的更强结论:DIFT 是唯一能学出正确控制的表征,或其最终性能绝对优于充分训练的随机特征。52% / 48% 尤其不宜在无误差条时渲染成确定胜利。[Table 3]
原 Figure 8 · 四项视觉消融
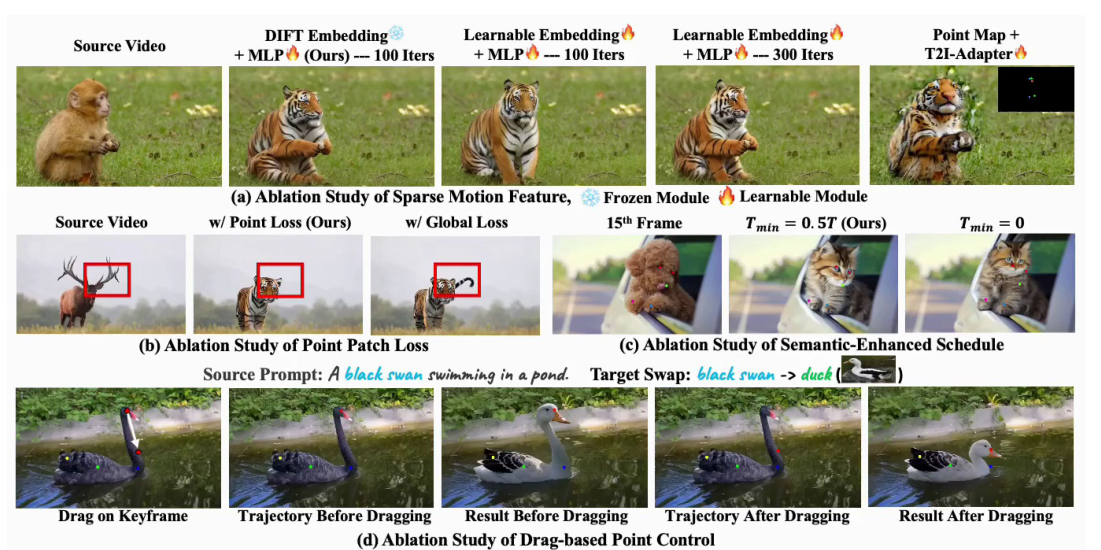
(a) 稠密点图适配器容易过拟合,与稀疏特征及 DIFT 初始化对比;(b) 去掉局部损失导致源结构泄漏;(c) 去掉高噪声 schedule 会学习过多低层信息;(d) 黑天鹅换鸭子时,沿用原点会使鸭子有天鹅长颈,拖动关键帧点并传播后更符合鸭子身份。原 Figure 8 为视频形式,见 PDF p.8 / 官方 Ablation Studies。
两个正则化措施都有独立去除对照,但稀疏特征对照也改变了条件网络结构/容量。因而“正是稀疏性、而非其他实现差异导致全部收益”仍是作者解释。缺少点数、点位置、遮挡比例、拖动量和新类别分层曲线,不能据案例断言稀疏点具有普遍最优粒度。
09 · 失败模式、审稿意见与研究延伸
原 Figure 10 · 追踪失败直接传导到生成
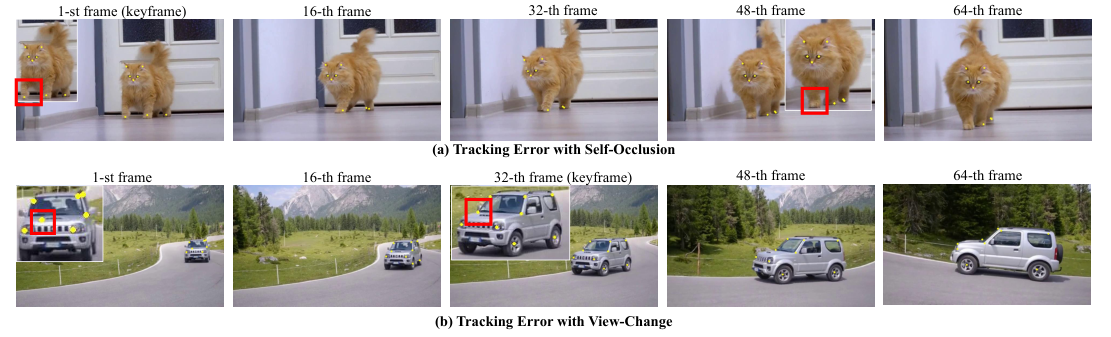
该图以第 1、16、32、48、64 帧展示 self-occlusion 与 view-change 的追踪误差;这里的 64 帧用于追踪局限图,不应误写为标准生成实验的 64 帧设置。用户可以移除错误点,但会牺牲运动对齐。LNA 对 3D 旋转、非刚性形变与自遮挡的表征能力有限,某些视频因此无法可靠支持拖点。[补充 §10.1]
Strengths · 系统各部分的目标相对清晰
- 把目标身份、源动作、背景保持与时序生成分配给不同模块,避免所有要求都挤进一个稠密控制图。
- 点的删除、移动有可解释语义;支持无对应部件和比例变化,比硬性保持源轮廓更匹配主体交换任务。
- 同 AnimateDiff 底模基线、局部损失/时间调度/初始化消融,避免只靠跨代底模比较宣传结果。
- 补充报告预处理、额外 LNA 成本、内存与失败场景,比只展示成功视频更有复现参考价值。
Weaknesses · 证据与使用门槛
- 评测规模较小,缺少开放类别/遮挡/长视频的系统统计;人物结果公开受限。
- 人工点选择、可用追踪与可训练 atlas 是隐藏于“编辑交互”前面的高要求,错误会级联。
- 注册虽然轻量,但额外 2 小时 LNA 与约 50 秒每次编辑并不满足实时体验;ED-LoRA 训练成本还未计入普通 4 分钟。
- CLIP 分数差距小且动作不敏感,主观评价缺少不确定性报告,不能仅凭平均值将所有组件结论普遍化。
- 正文有限差分映射有符号不一致;具体采样和注册配置仍需代码及 checkpoint 核对。
Research Extension · 未经本文验证的可执行方向
- 置信度感知点控制:用追踪遮挡/可靠性对特征聚合、局部损失和条件注入加权。实验按遮挡比例分层,比较相同人工点数下的轨迹误差与身份偏好。
- 自适应稀疏度:比较语义点、边界点、混合点,并限制总人工交互预算;检验在何种运动/形变强度下点太少或太多。
- 摆脱二维 atlas 的传播:尝试三维或时间条件变形场,在旋转和非刚体序列评估位移传播误差,而不只看最终视觉质量。
- 编辑后校验与重试:生成后重新追踪目标语义点,计算偏离用户目标轨迹的量,作为局部重新采样/调条件的反馈。该闭环不属于原 VideoSwap。
- 迁移到程序化材质研究:可借鉴“稀疏语义约束保留自由度”的原则,在材质节点/参数上设置少量可解释锚点,再用渲染反馈校准。本文没有材质图、SBS/SBSAR、程序生成或 execution-aware decoding 实验,不能把此类比视为已经验证的跨域能力。
伦理:作者承认定制人物身份可能用于误导性视频,提出 anti-DreamBooth 式保护和不可见水印等方向,但没有报告它们已整合进本系统或经过抗攻击评测。身份使用授权和显式标识仍然重要。[补充 §10.3]
10 · Paper vs. Implementation:只读核查边界
本次核查资料为已保存的官方项目页、官方动态补充页与代码 README;未运行训练/推理、未下载权重,未逐文件审计实现。README 明确声明此仓库是第一作者在 NUS 期间的 re-implementation,并列出 2024-03-28 训练与推理代码发布。它不是固定 2023 v2 PDF 内实验环境的不可变快照。[官方仓库]
| 核查点 | README 明确内容 | 解释/未确认项 |
|---|---|---|
| 环境 | Python 3.10、PyTorch 2.2.1、Diffusers 0.19.3;示例安装 CUDA 12.1、xformers | 只记录依赖要求;未安装或验证兼容性 |
| 准备 | scripts/prepare_dataset_model.sh 提供预处理数据、预训练模型和结果下载 | 未执行;下载可用性、授权、文件完整性未验 |
| 推理入口 | test.py -opt options/test_videoswap/animal/2001_catheadturn_T05_Iter100/2001_catheadturn_T05_Iter100.yml | 是 README 示例,不证明所有案例都用相同参数 |
| 训练入口 | train.py -opt options/train_videoswap/animal/2001_catheadturn_T05_Iter100/2001_catheadturn_T05_Iter100.yml | 配置名与 100 步/T05 相呼应,未打开配置则不能当作独立验证 |
| 内存 | README 写 A100,训练与推理需要 12GB | PDF 写注册 16GB、推理 12GB;重实现与测量口径可能不同,原因未验证 |
| 外部组件 | Diffusers、AnimateDiff、Mix-of-Show、Co-tracker | 确认为依赖说明;LNA 拖点完整工作流是否包含在公开重实现中,本次未从源码确认 |
建议复现顺序(未执行):首先检查访问许可与现有预处理样例,再核对 checkpoint、ED-LoRA 与配置版本;先运行不拖点的预定义概念,确认反演/背景混合/点坐标尺度;随后测试定制概念,最后引入 LNA 拖点。逐项记录 seed、帧采样、目标 prompt、点位置、点 mask 坐标单位、CFG 与时步 schedule,避免把一个失败归结为整体算法不可复现。
既有笔记中“曾申请仓库访问但邮件未及时查收,申请过期,需要重新申请”的个人复现备注已原样保留。本次没有重新申请、没有提交表单,也没有将 README 可读误写为所有数据与模型访问均已获准。
11 · 来源、覆盖清单与保存边界
- 固定 arXiv v2 元数据入口 / 固定 PDF(16 页):§1–5 为正文;§6–10 补充方法、运行成本、评估、失败与伦理。正文公式 (1)–(6)、未编号轨迹/聚合/混合式、Algorithm 1 均已解释。
- 官方项目页:方法和结果的公开展示。
- 官方动态补充:用户交互、动物/物体编辑、旧方法与同底模比较、四组消融。本页未内嵌大体积视频。
- 官方代码仓库:README 重新实现说明、环境与入口;与论文事实分开使用。
图表覆盖:原 Figure 1–10 全部展示并逐项讲解;Figure 1、2、3、7、8 从 PDF 中隐藏的动画 Widget appearance 提取各组 .0 静态首帧,仅在内存中改变可见性,不改写源 PDF、不宣称播放验收;保留一手原文/动态视频入口。原 Table 1、2、3 全部方法行与指标列以 HTML 原生表重建。标准实验为 16 帧,与 Figure 10 的 64 帧追踪演示明确区分。
验收边界:已做结构、公式源码、表格完整性、图片嵌入、文件体积与原笔记字节前缀检查;本轮按要求不运行浏览器验收、不部署、不改本地 vault。MathJax 3 引擎随 HTML 保存;Figure 5 使用已核验 HTTP 200 的官方高清原图链接,需要联网加载,其他静态图内嵌;动态视频需到官方网页查看。原 PDF 不进入最终交付目录,已有源文件身份以 SHA-256 核对;新增笔记仅作为待合并候选。