局部代码修复不够
SWE 类任务主要要求修复已有项目的问题,很难衡量从需求理解、界面组织到部署的全流程。这里要求从视觉与文字约束出发完成整站实现。
从「看起来像」
到「真正运行起来」。
一套把视觉网页开发拆成三层能力、再用受约束 Agent 验证的评测系统。重点精读:任务如何构造,工作流如何测试,分数究竟说明什么。
A Hierarchical Benchmark for Visual Website Development with Agent Verification
输入截图、需求和素材,输出可运行网站,再通过实际访问判断视觉与功能。Vision2Web 测量的是 模型 × Agent 框架 × 执行环境 的联合表现。
本页以最新 v3 的 23 页 PDF(正文与附录)为主。官方仓库公告称论文获 ICML 2026 Spotlight;此 venue 标记来自作者官方公告。主实验保留论文中的 8 个模型 × 2 个框架,不把更新的线上榜单混入论文结果。当前仓库存在验证器与推理框架更新,详见实现差异。[1][2]
SWE 类任务主要要求修复已有项目的问题,很难衡量从需求理解、界面组织到部署的全流程。这里要求从视觉与文字约束出发完成整站实现。
静态 UI-to-code 擅长测布局复刻,却无法证明导航连贯、表单有效、登录状态保持或前后端数据一致。网页不只是一张渲染图。
固定选择器容易被不同实现打破;自由 GUI Agent 又容易绕路、误判。作者用专家定义的目标、动作、断言约束 Agent,让它适应界面变化而不改写测试目标。
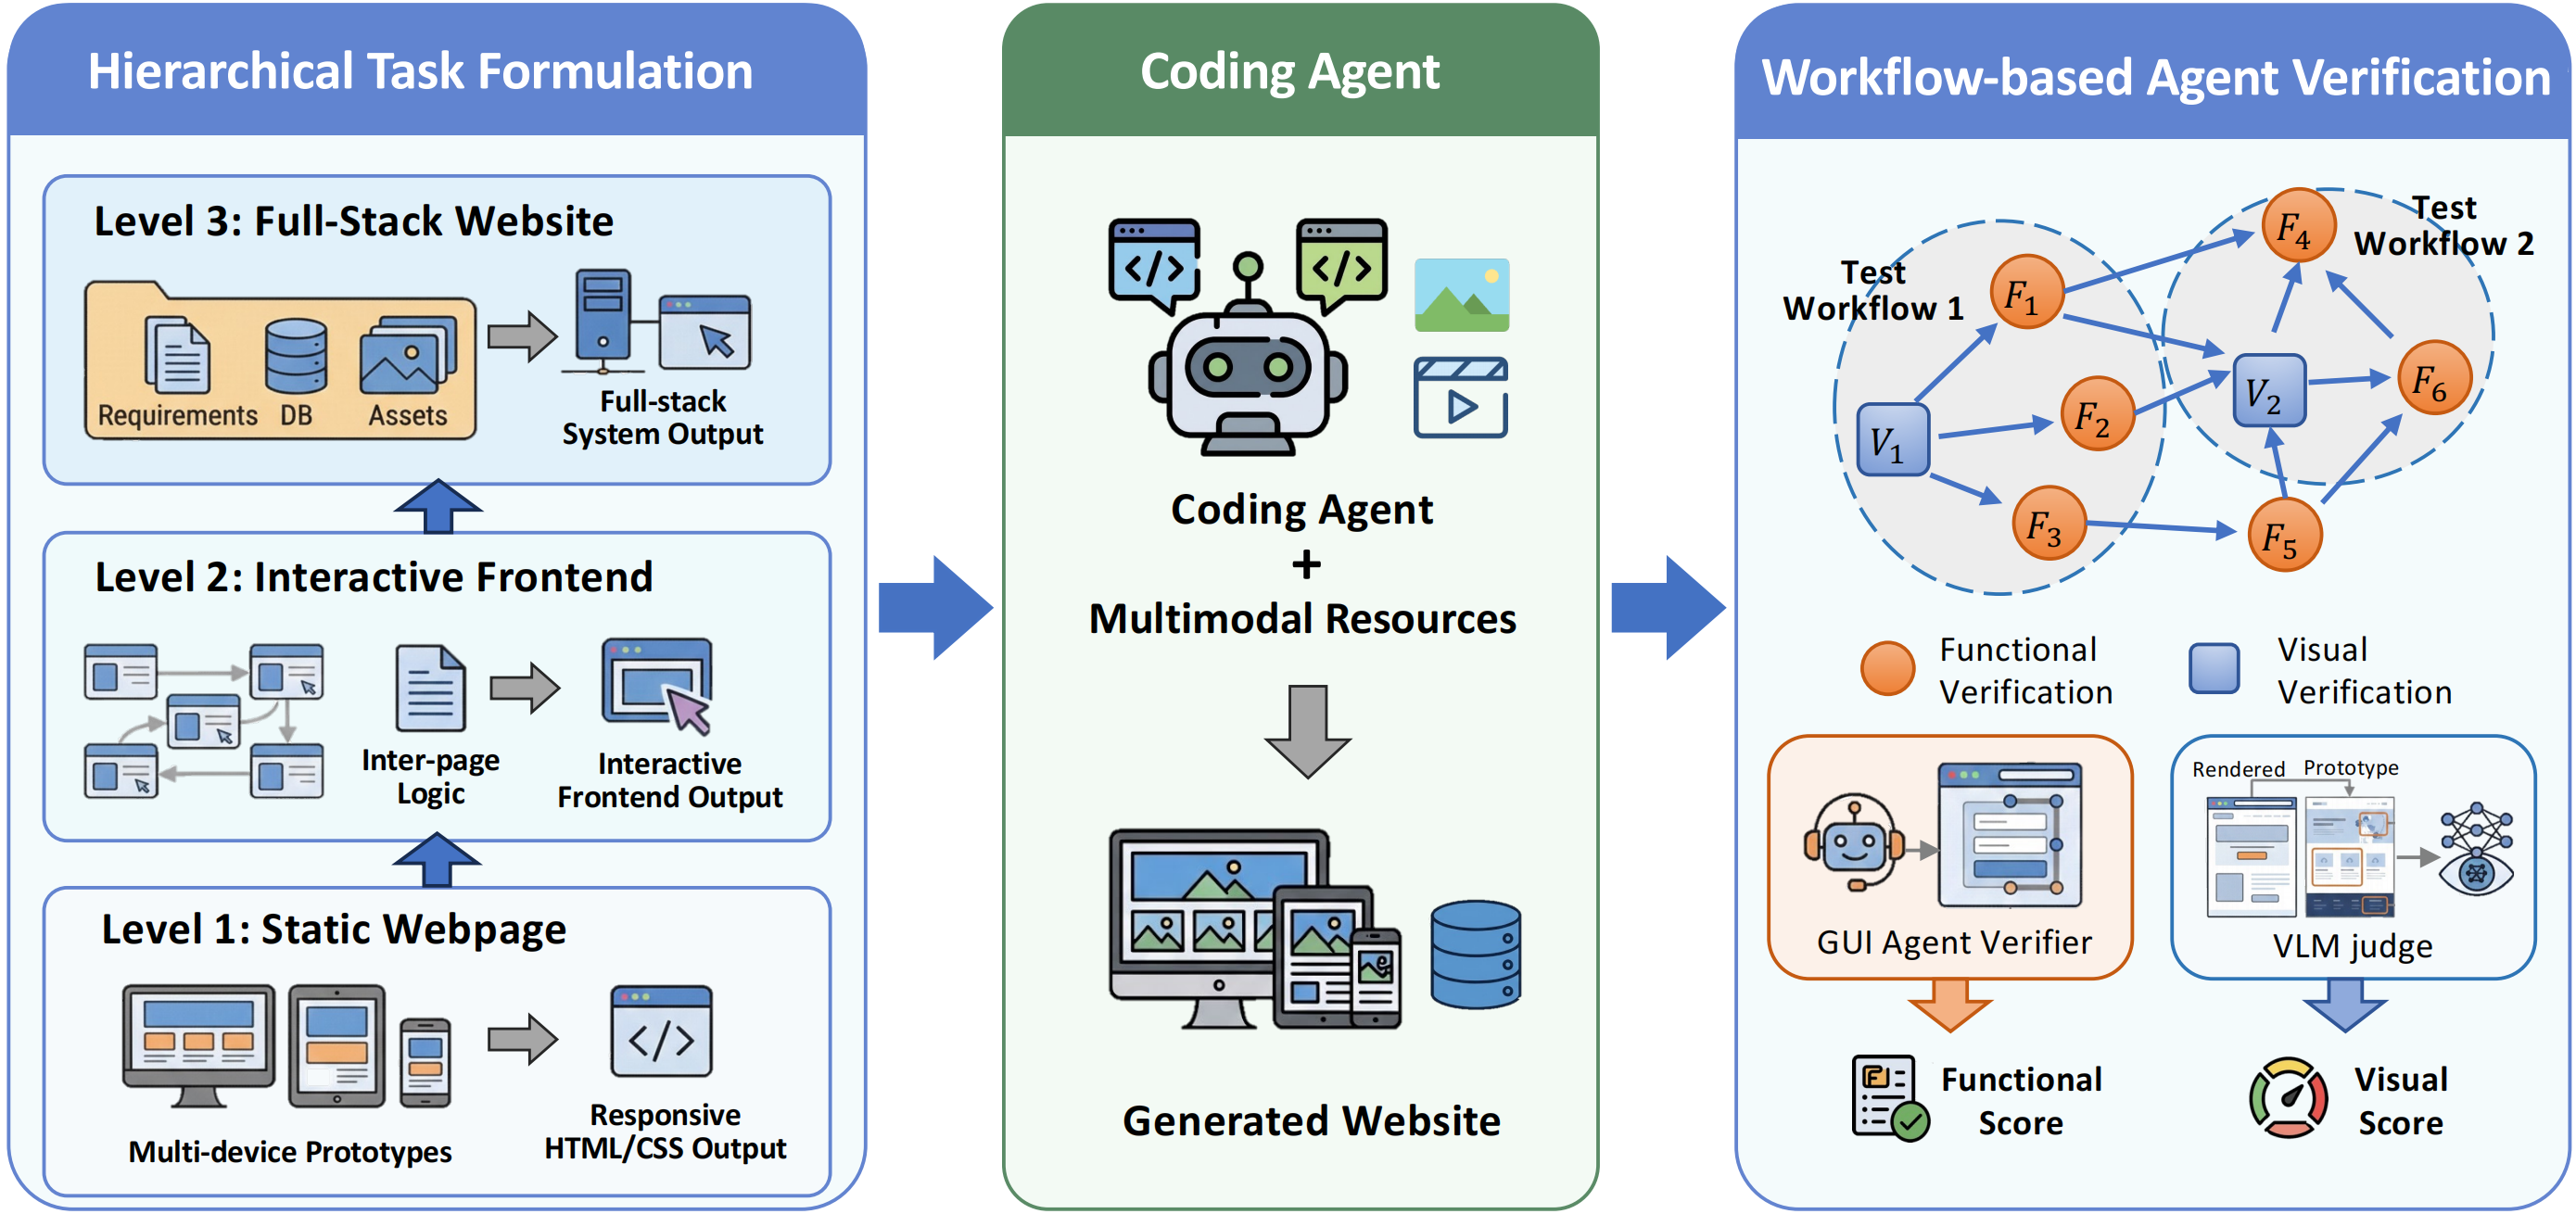
以下重建论文 Table 1。这里的「多模态」指任务是否提供视觉输入;计数不能直接当作难度排序。
| Benchmark | # Tasks | # Test Cases | # Prototypes | # Multimodal | Task Types |
|---|---|---|---|---|---|
| SWE-Bench Multimodal | 617 | \(-\) | \(-\) | ✓ | Issue fixing |
| Design2Code | 484 | \(-\) | 484 | ✓ | Single page UI-to-Code |
| WebGenBench | 101 | 647 | \(-\) | ✗ | Website generation |
| Vision2Web | 193 | 1255 | 918 | ✓ | Full-stack website development |
真正的新意在于任务分层 + 可观察行为规格 + 工作流验证共同构成评测协议。论文没有提出新的网页生成模型,也没有训练一个专用 backbone。因此 optimizer、学习率、epoch、训练 GPU 等并非本文方法的配置项;核心复现对象是任务、Agent 执行设置与评测器。
论文 §2.1 将任务按交付范围分层,所有层级都配有图像、图标、视频、字体等素材资源。它不是将同一个网站固定地升级三次,也不是训练课程表;三个任务集合的规模和输入分布不同。[1, §2.1–2.3]
输入:同一网页的桌面、平板、手机原型与分辨率;资源库。
交付:一个可执行的页面,在三个指定设备尺寸上保持相应布局、内容与样式。
评测:3 张原型对应的 Visual Score。没有功能 FS。
能力:图像—资源匹配、布局分解、排版、断点响应式设计。
不是为每张截图输出一张位图;代码需要能在指定尺寸实际渲染。
输入:多页原型,描述页面关系的文本与资源库。
交付:完整可交互前端;页面、组件和导航关系一致。
评测:目标页面的 VS + 功能节点通过率 FS。
能力:跨页组件复用、路由、交互状态、页面间视觉一致性。
单独做出精美首页仍可能在二级页面和导航测试中丢分。
输入:结构化 PRD、多页原型、资源库。
交付:前端、后端、数据库与 seed data;集成部署、文档及启动脚本。
评测:更长的业务流程、状态与边界场景 FS + VS。
能力:需求分解、鉴权、持久化、API/数据库连接、系统调试。
要求是真实全栈;评分证据仍主要来自可观察行为,见评测盲区。
| Level | Webpage | Frontend | Website |
|---|---|---|---|
| Avg Prototype Images | \(3\pm 0\) | \(5.9\pm 0.5\) | \(8.5\pm 2.3\) |
| Avg Test Cases | \(-\) | \(7.5\pm 4.5\) | \(28.2\pm 12.0\) |
| Avg Text Tokens(\(10^{3}\)) | \(-\) | \(1.0\pm 0.6\) | \(4.3\pm 1.1\) |
原论文 Table 2,保留 ± 的原始表达;表注未进一步明确其统计定义,不擅自将其标成置信区间。文本 token 单位为千;“—”表示该表未提供该项,并非代理执行时完全不接收任何指令。
规模上的变化:L3 平均 28.2 个测试用例,对比 L2 的 7.5 约为 3.76 倍;需求文本由约 1.0k 增至 4.3k。更困难的不只是看更多图片,而是让多个功能在共享状态下同时成立。以上倍数为根据 Table 2 的四舍五入均值复算。
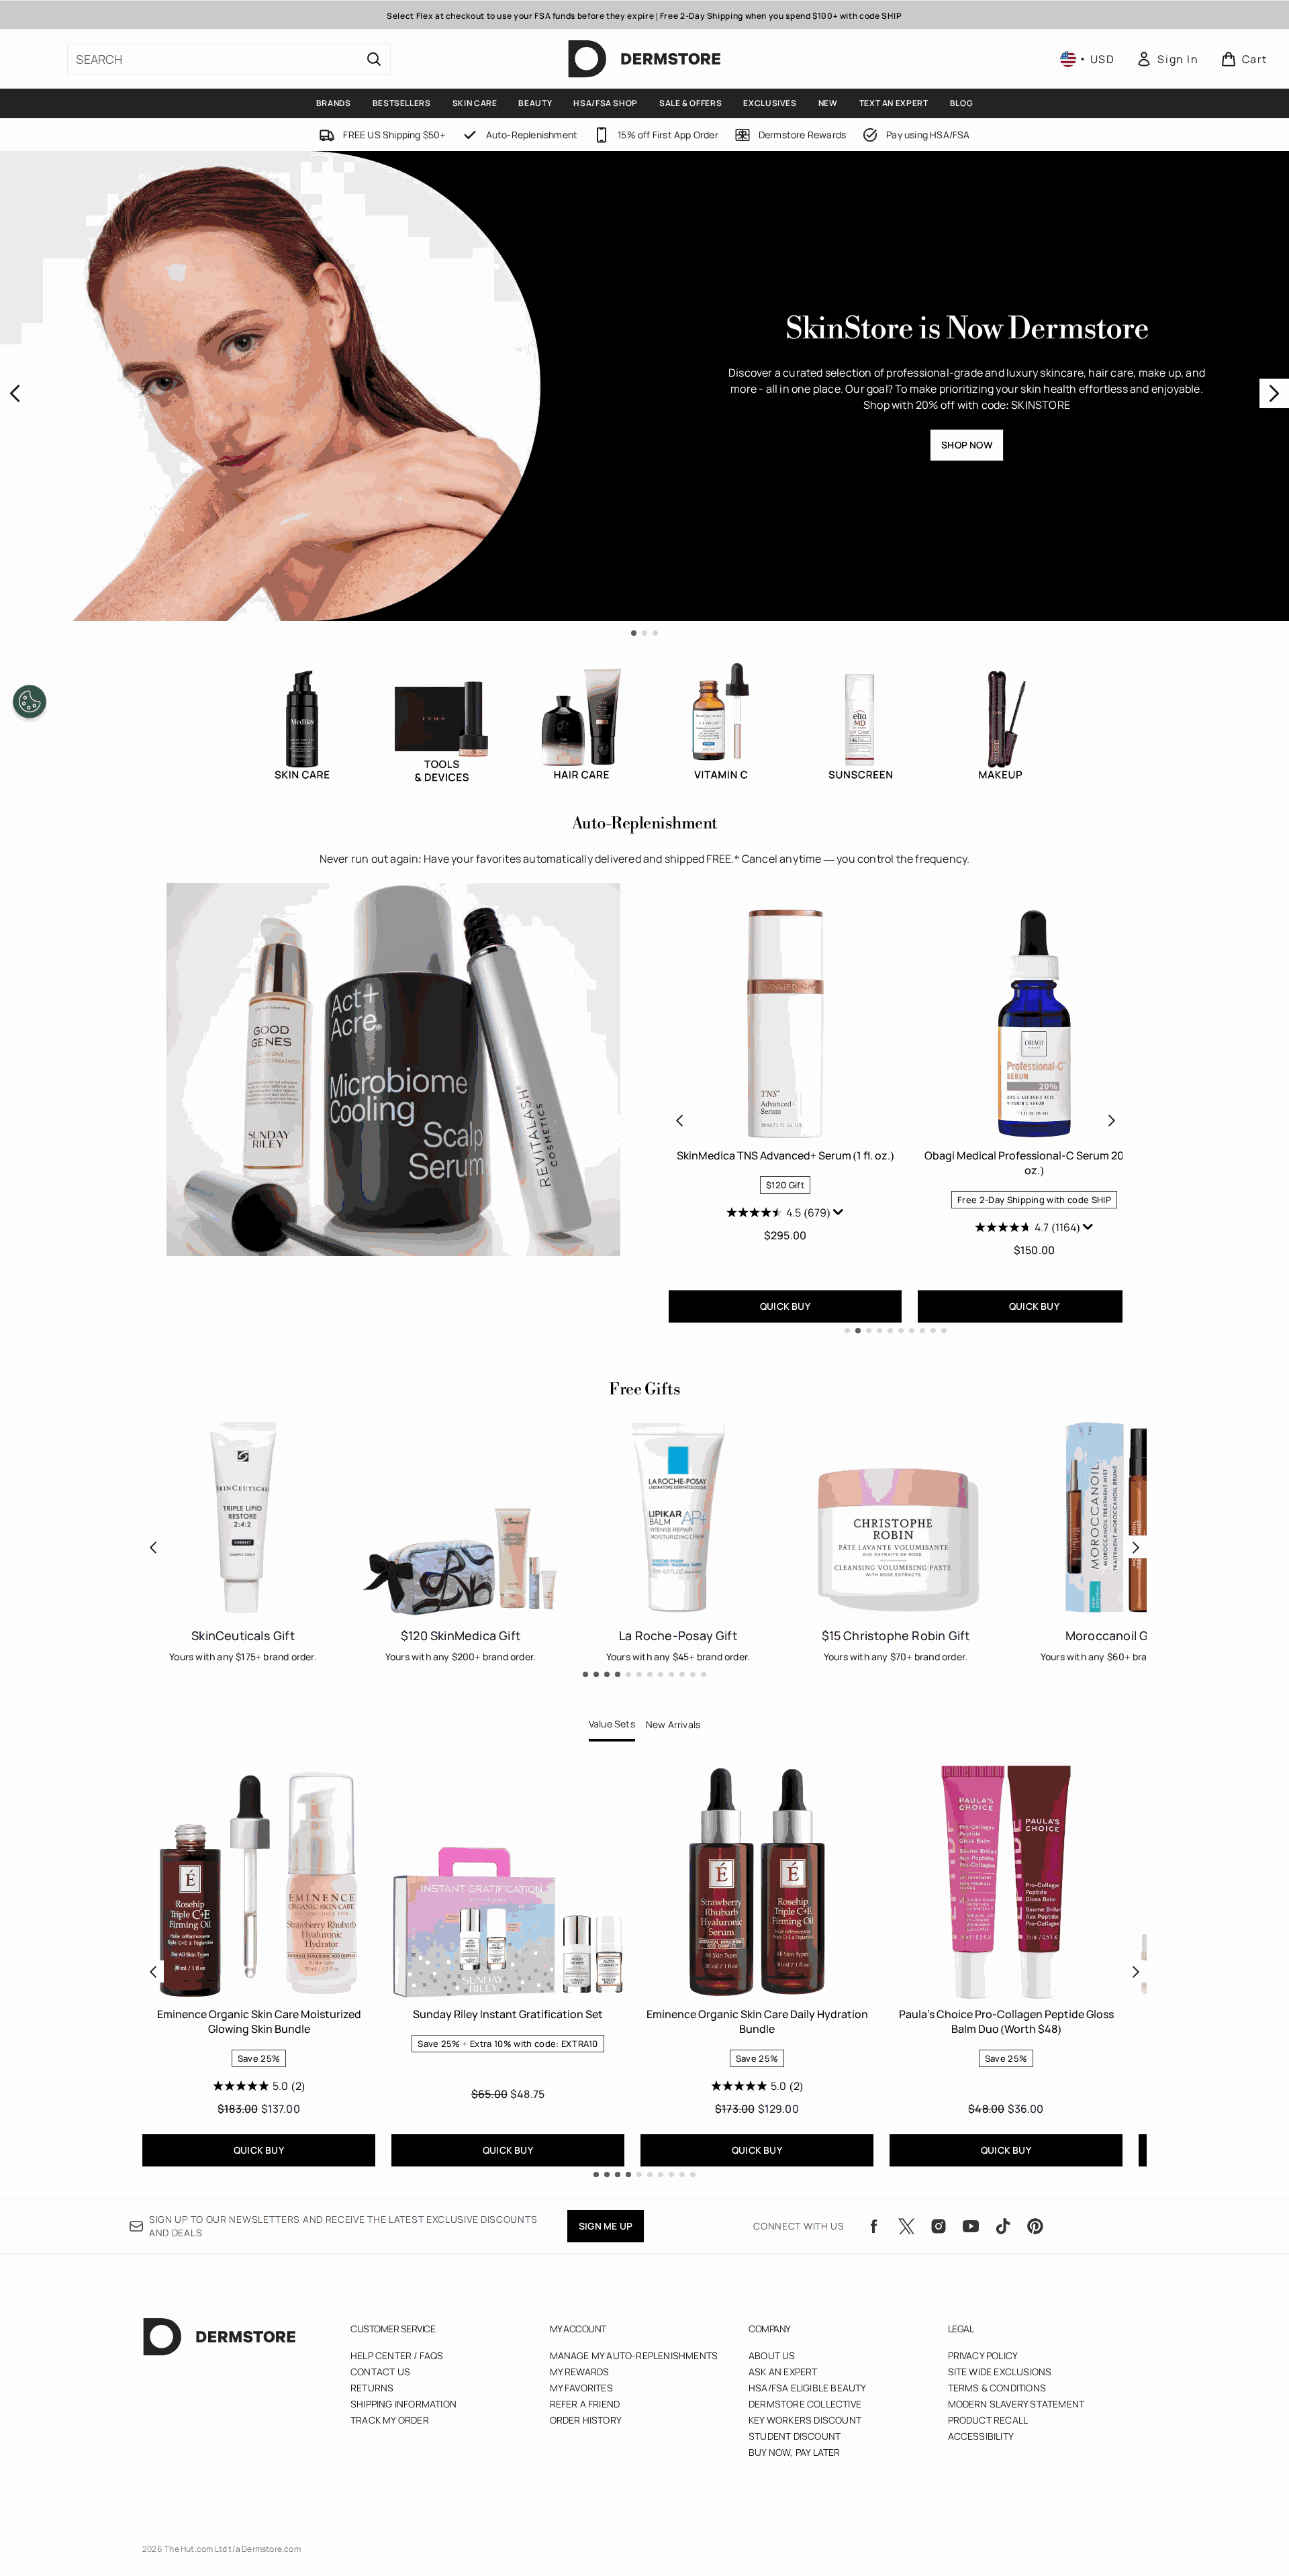
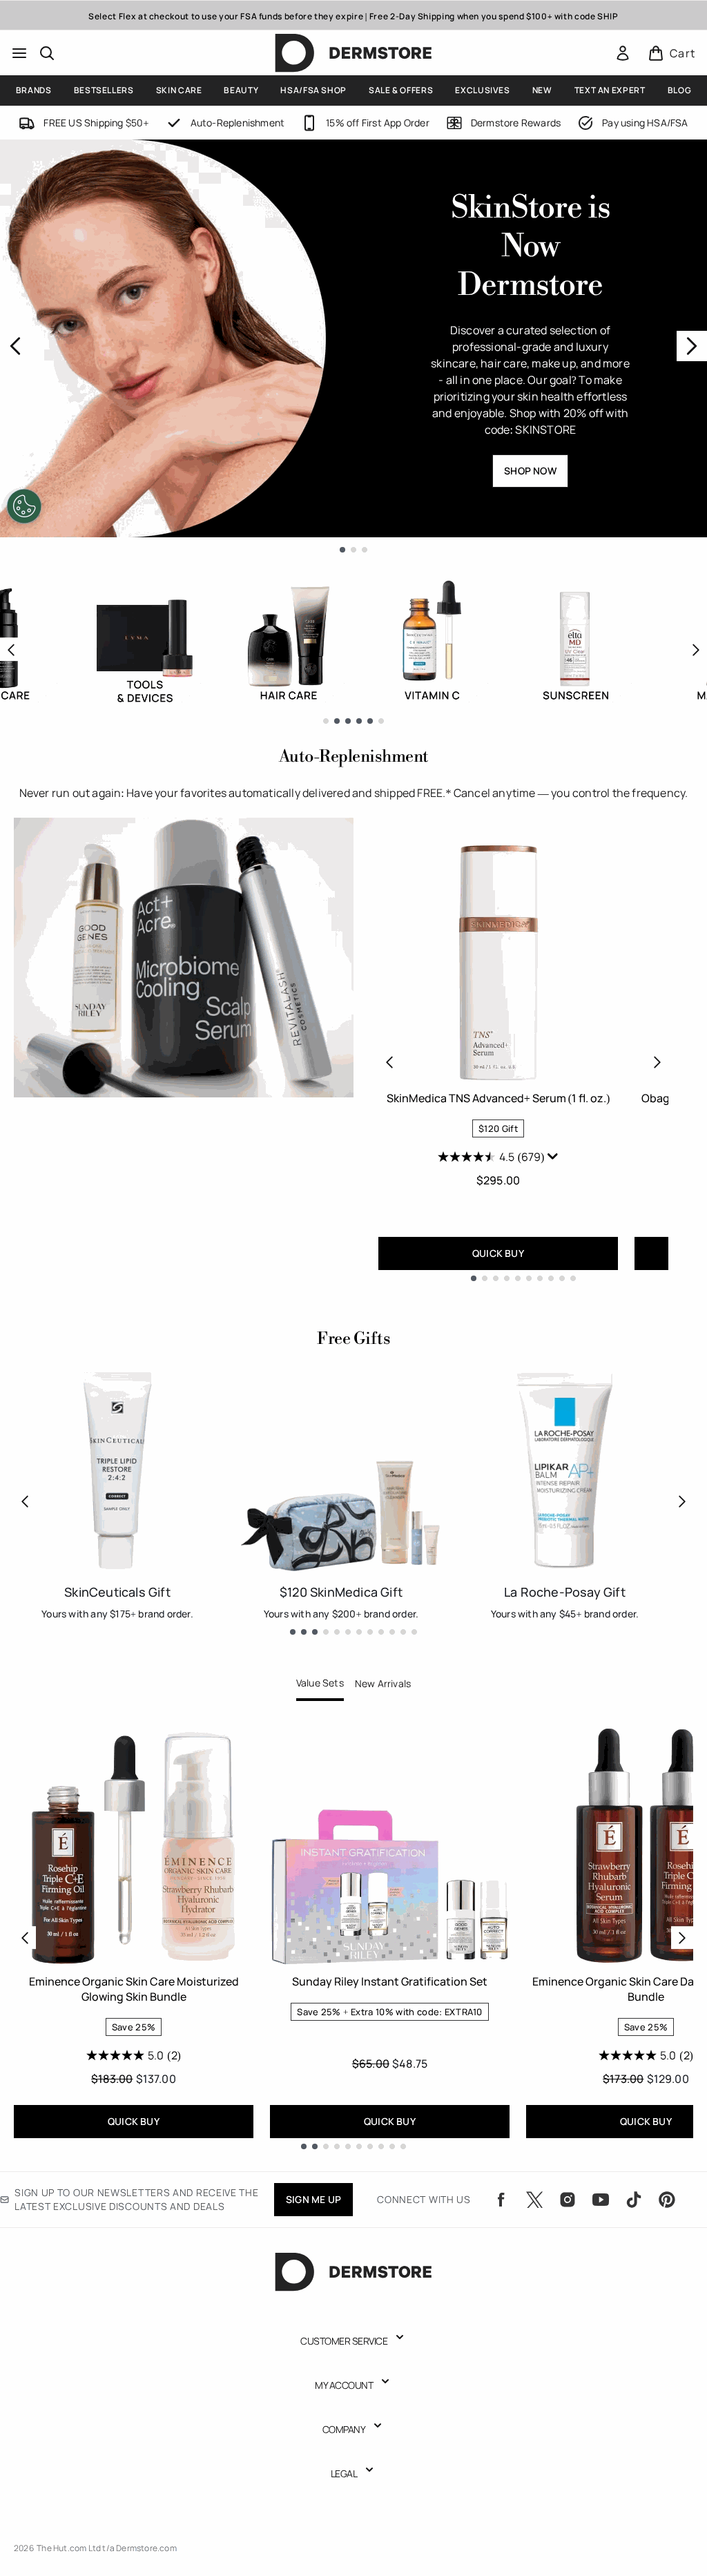

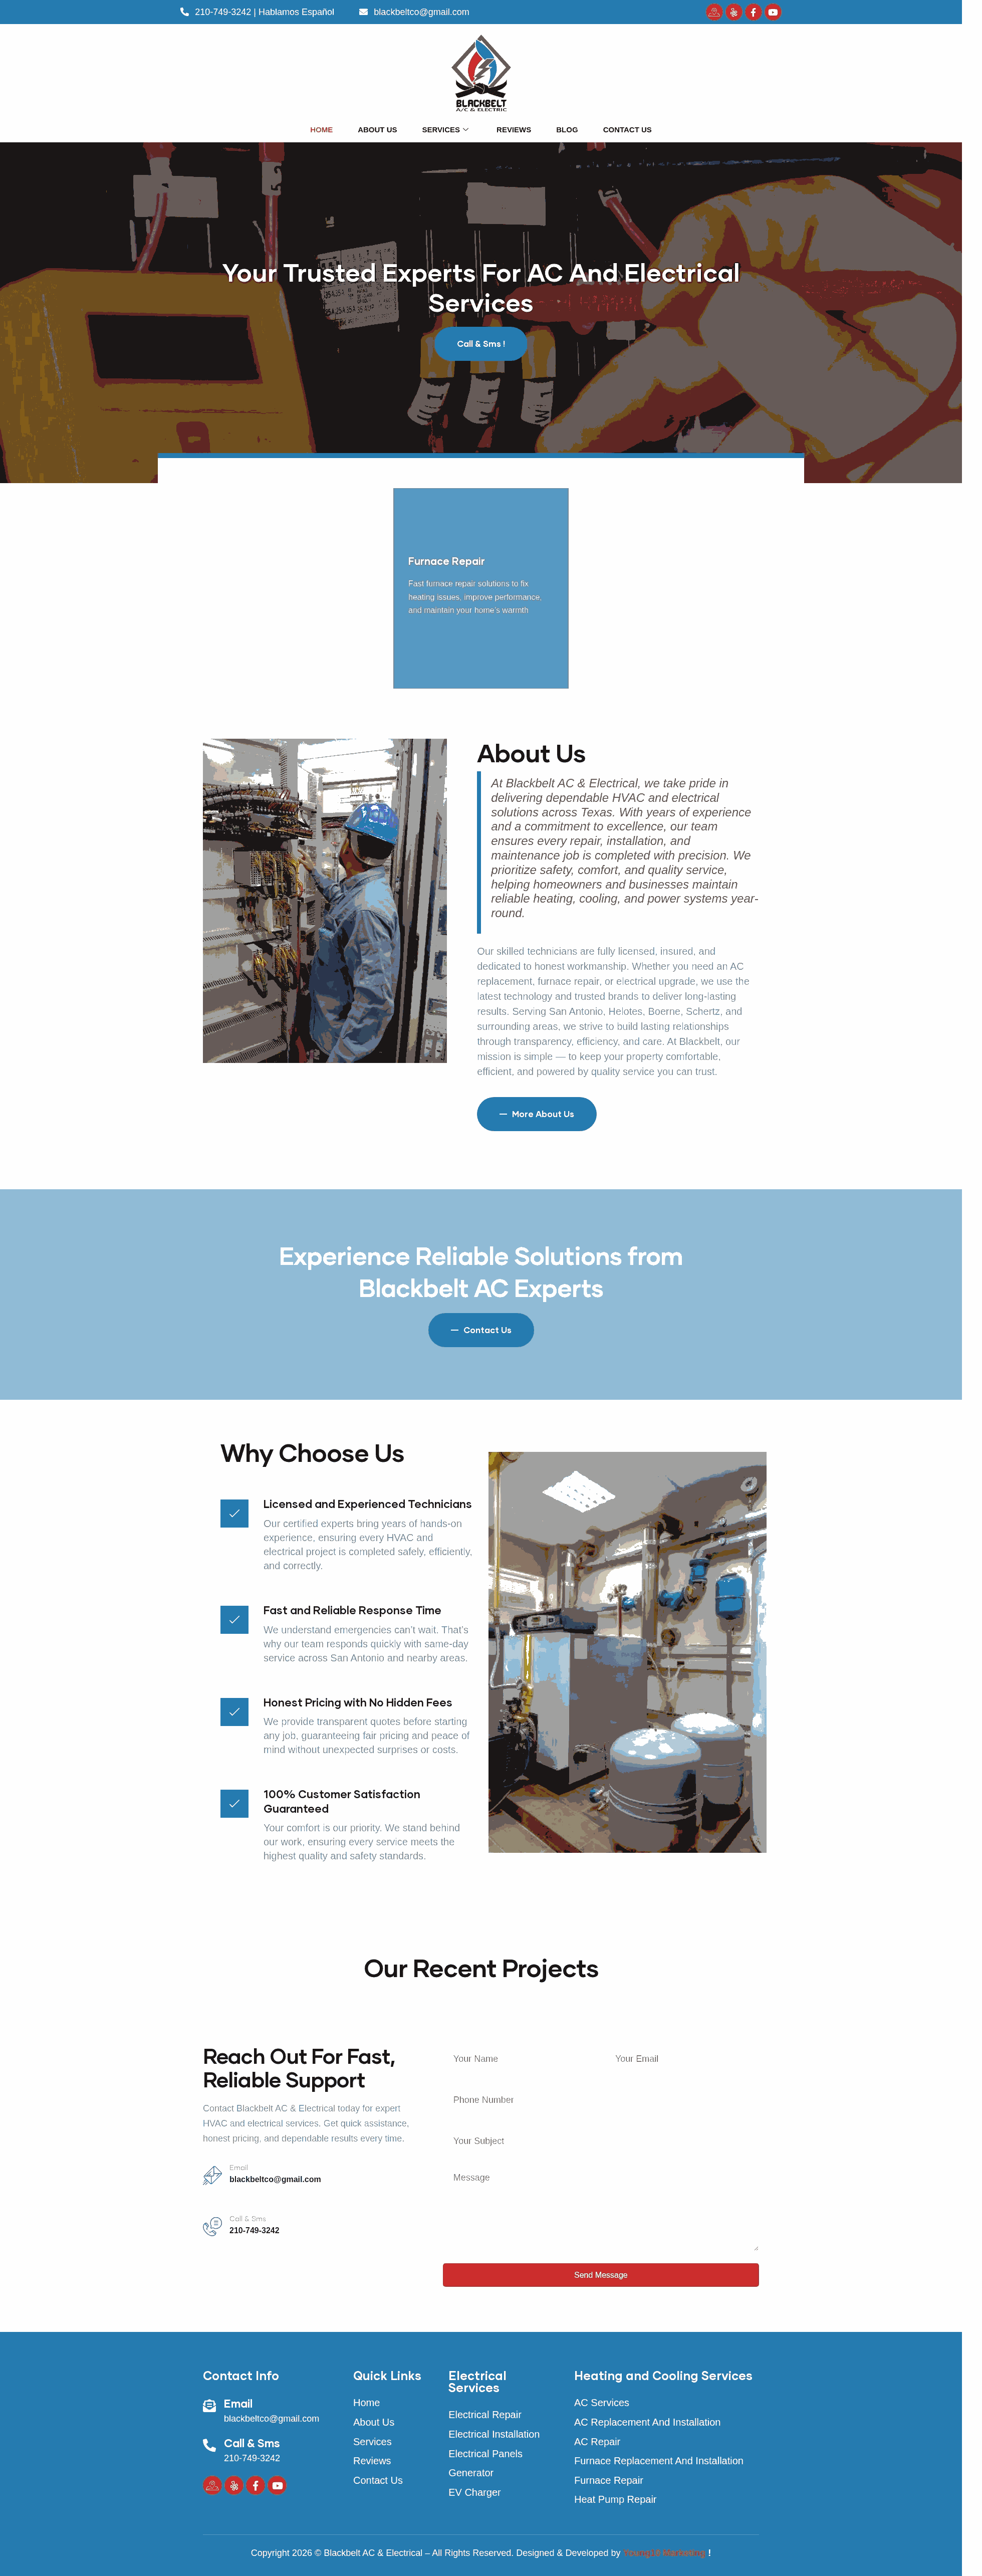
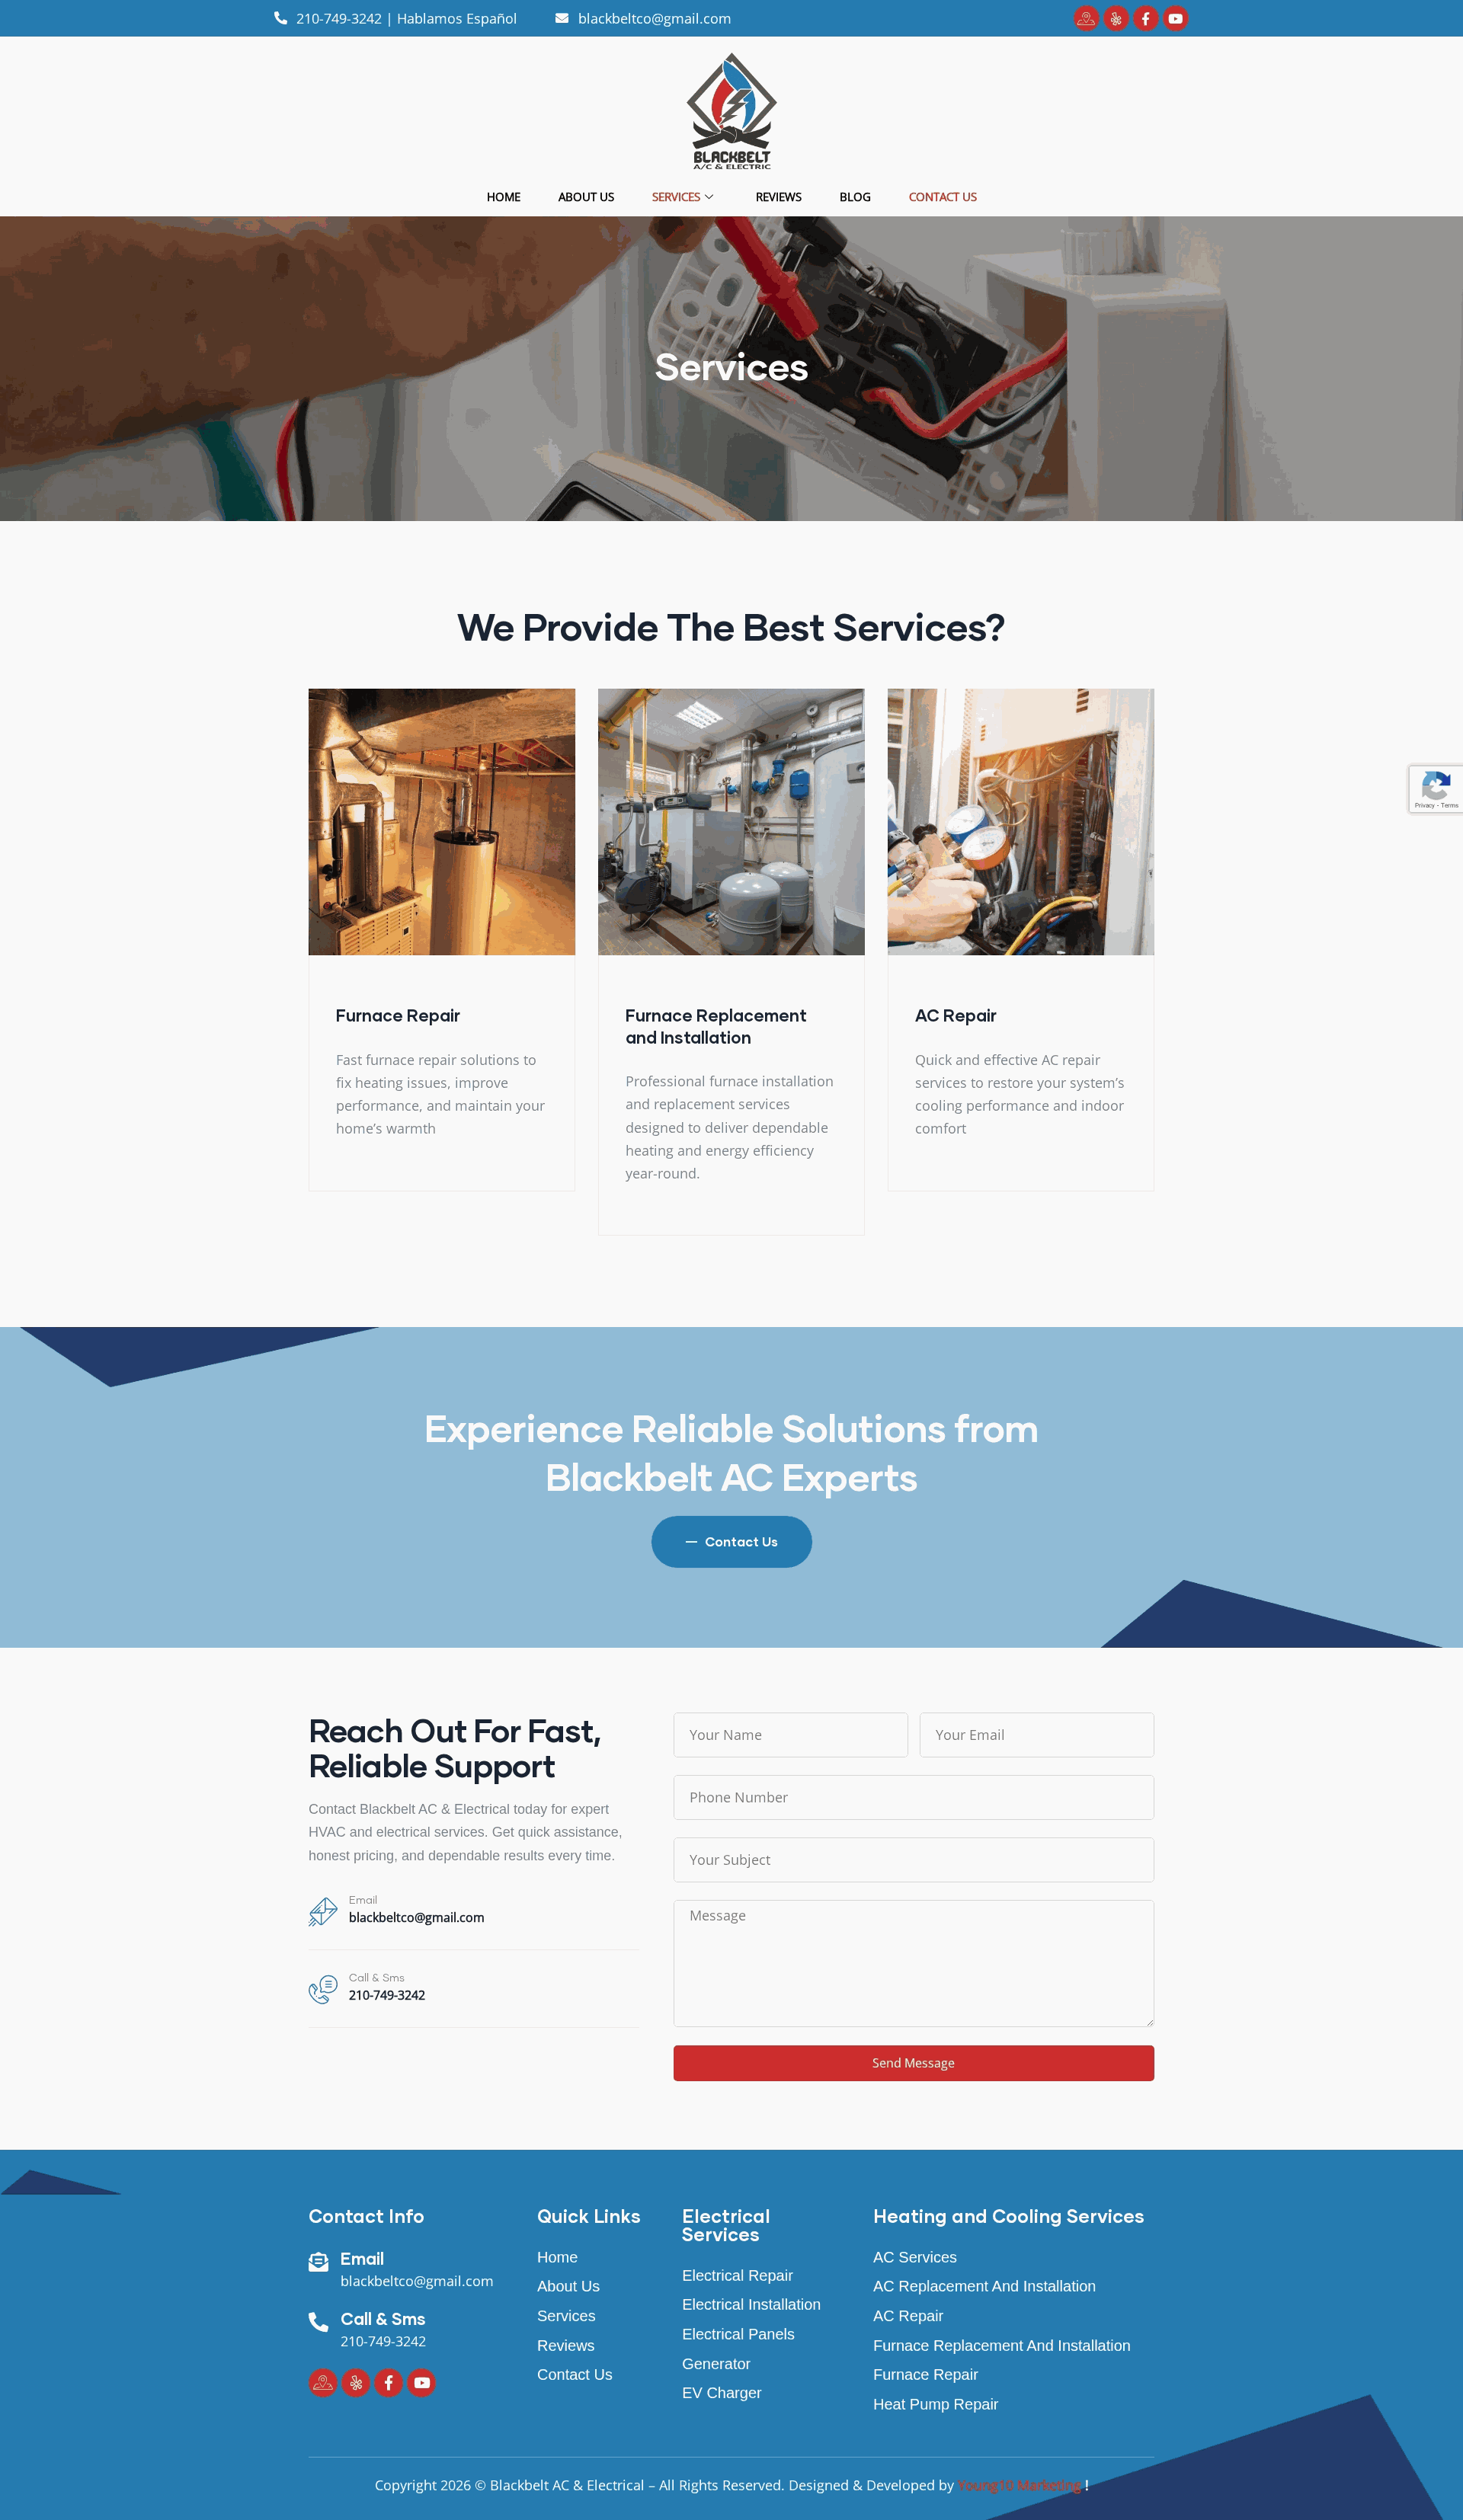
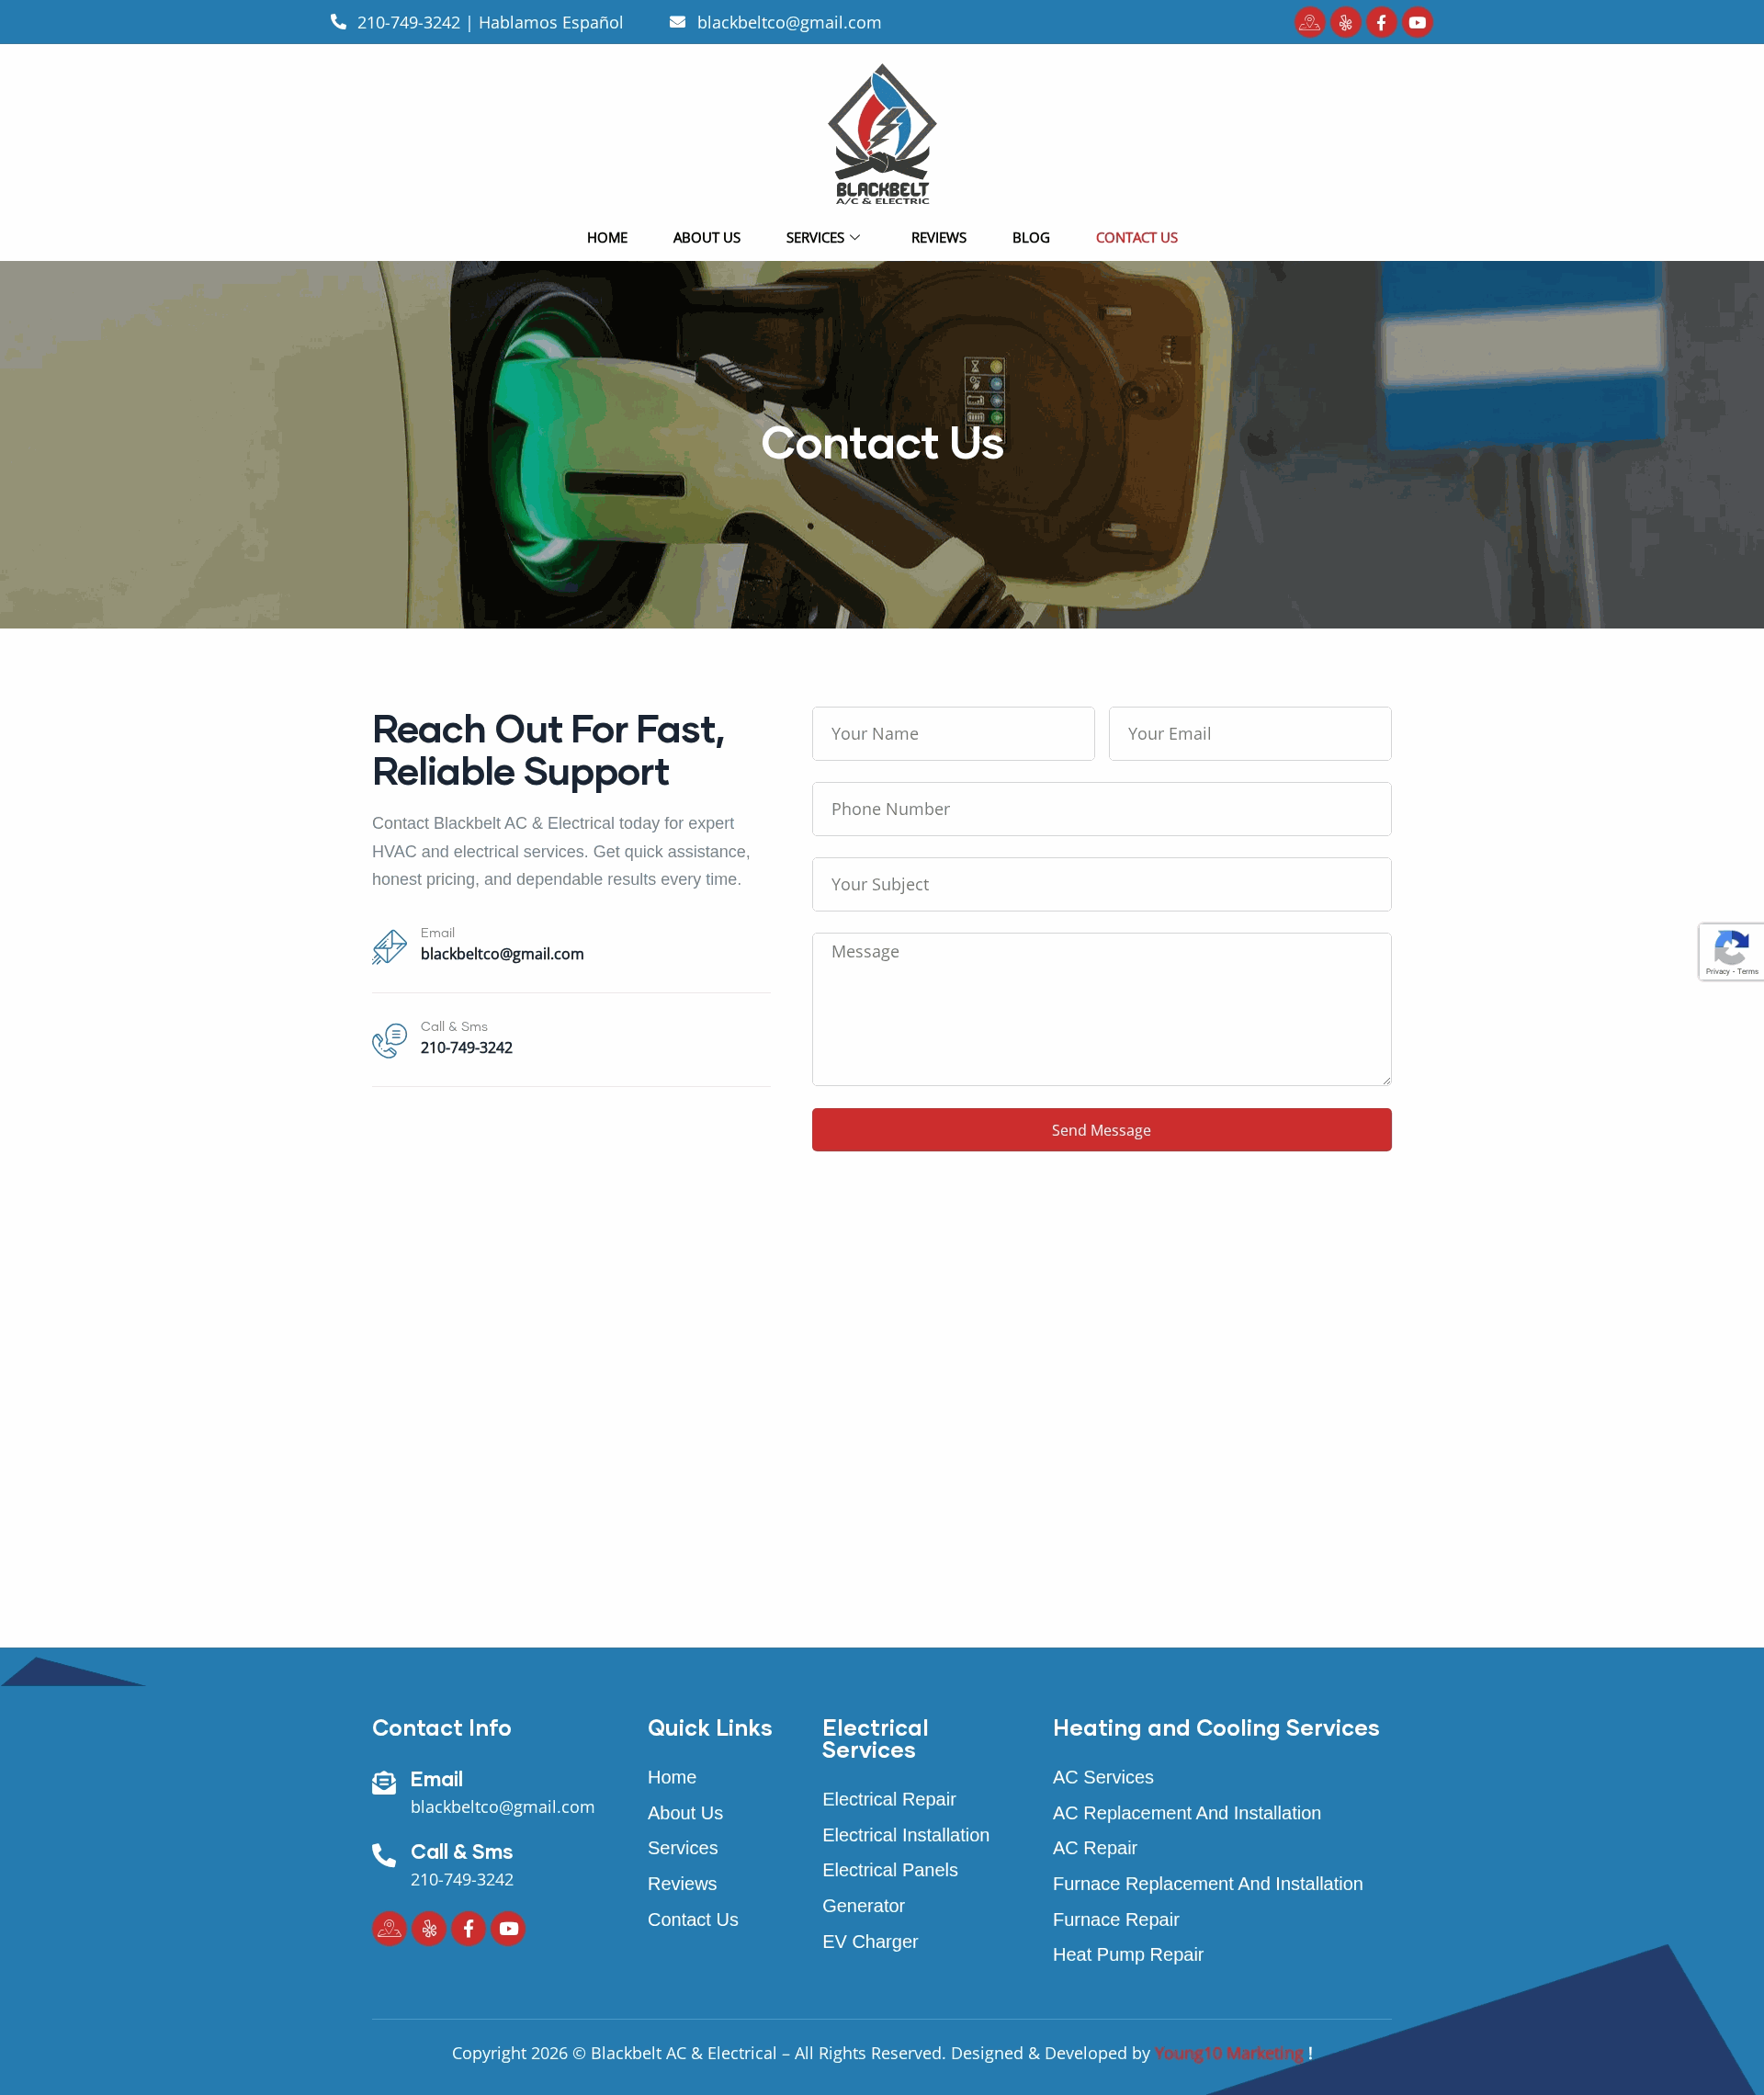
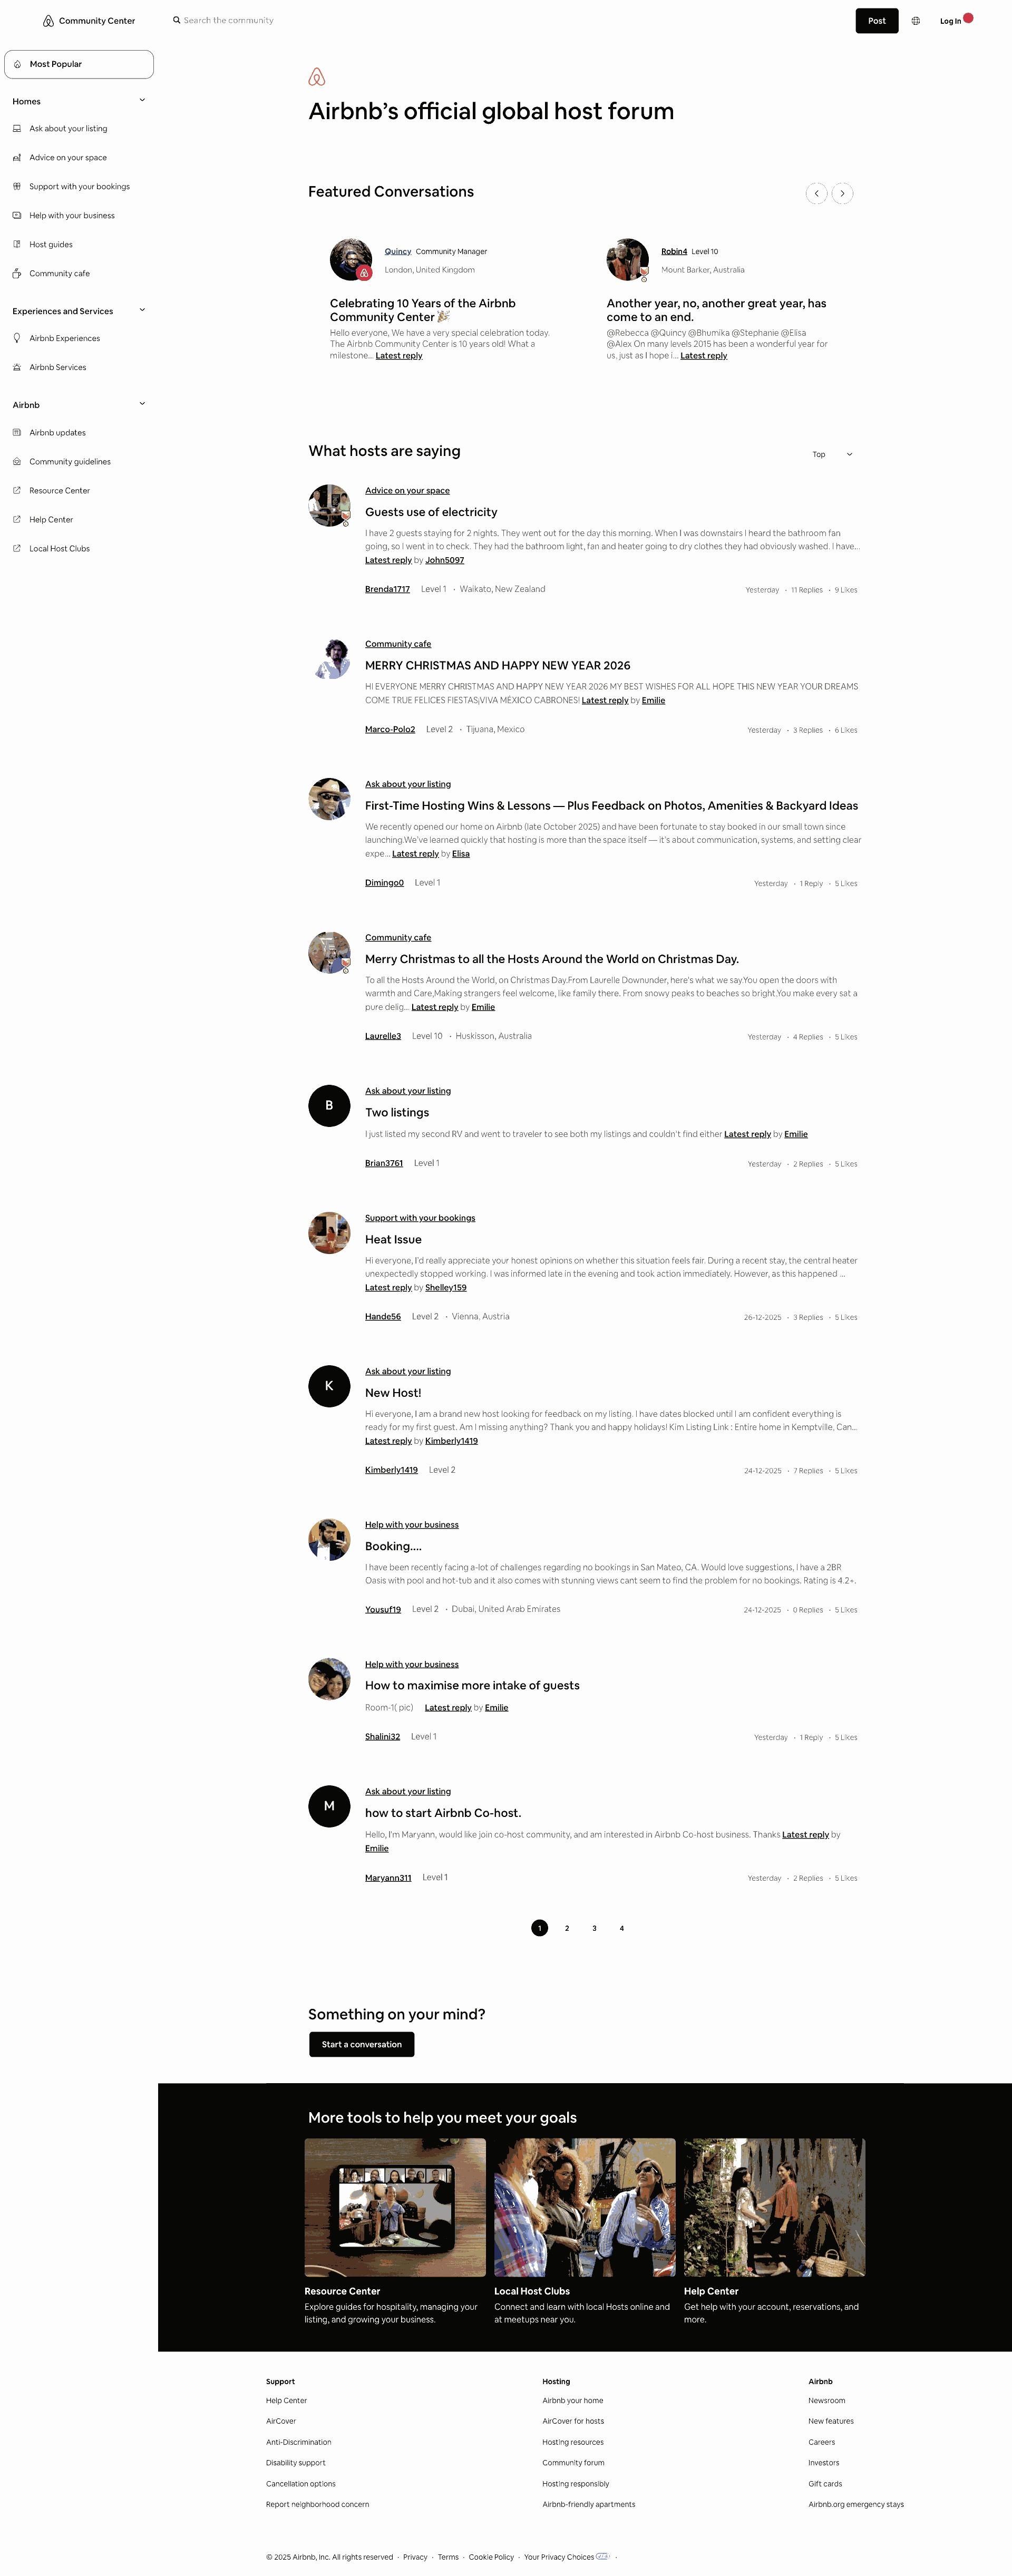
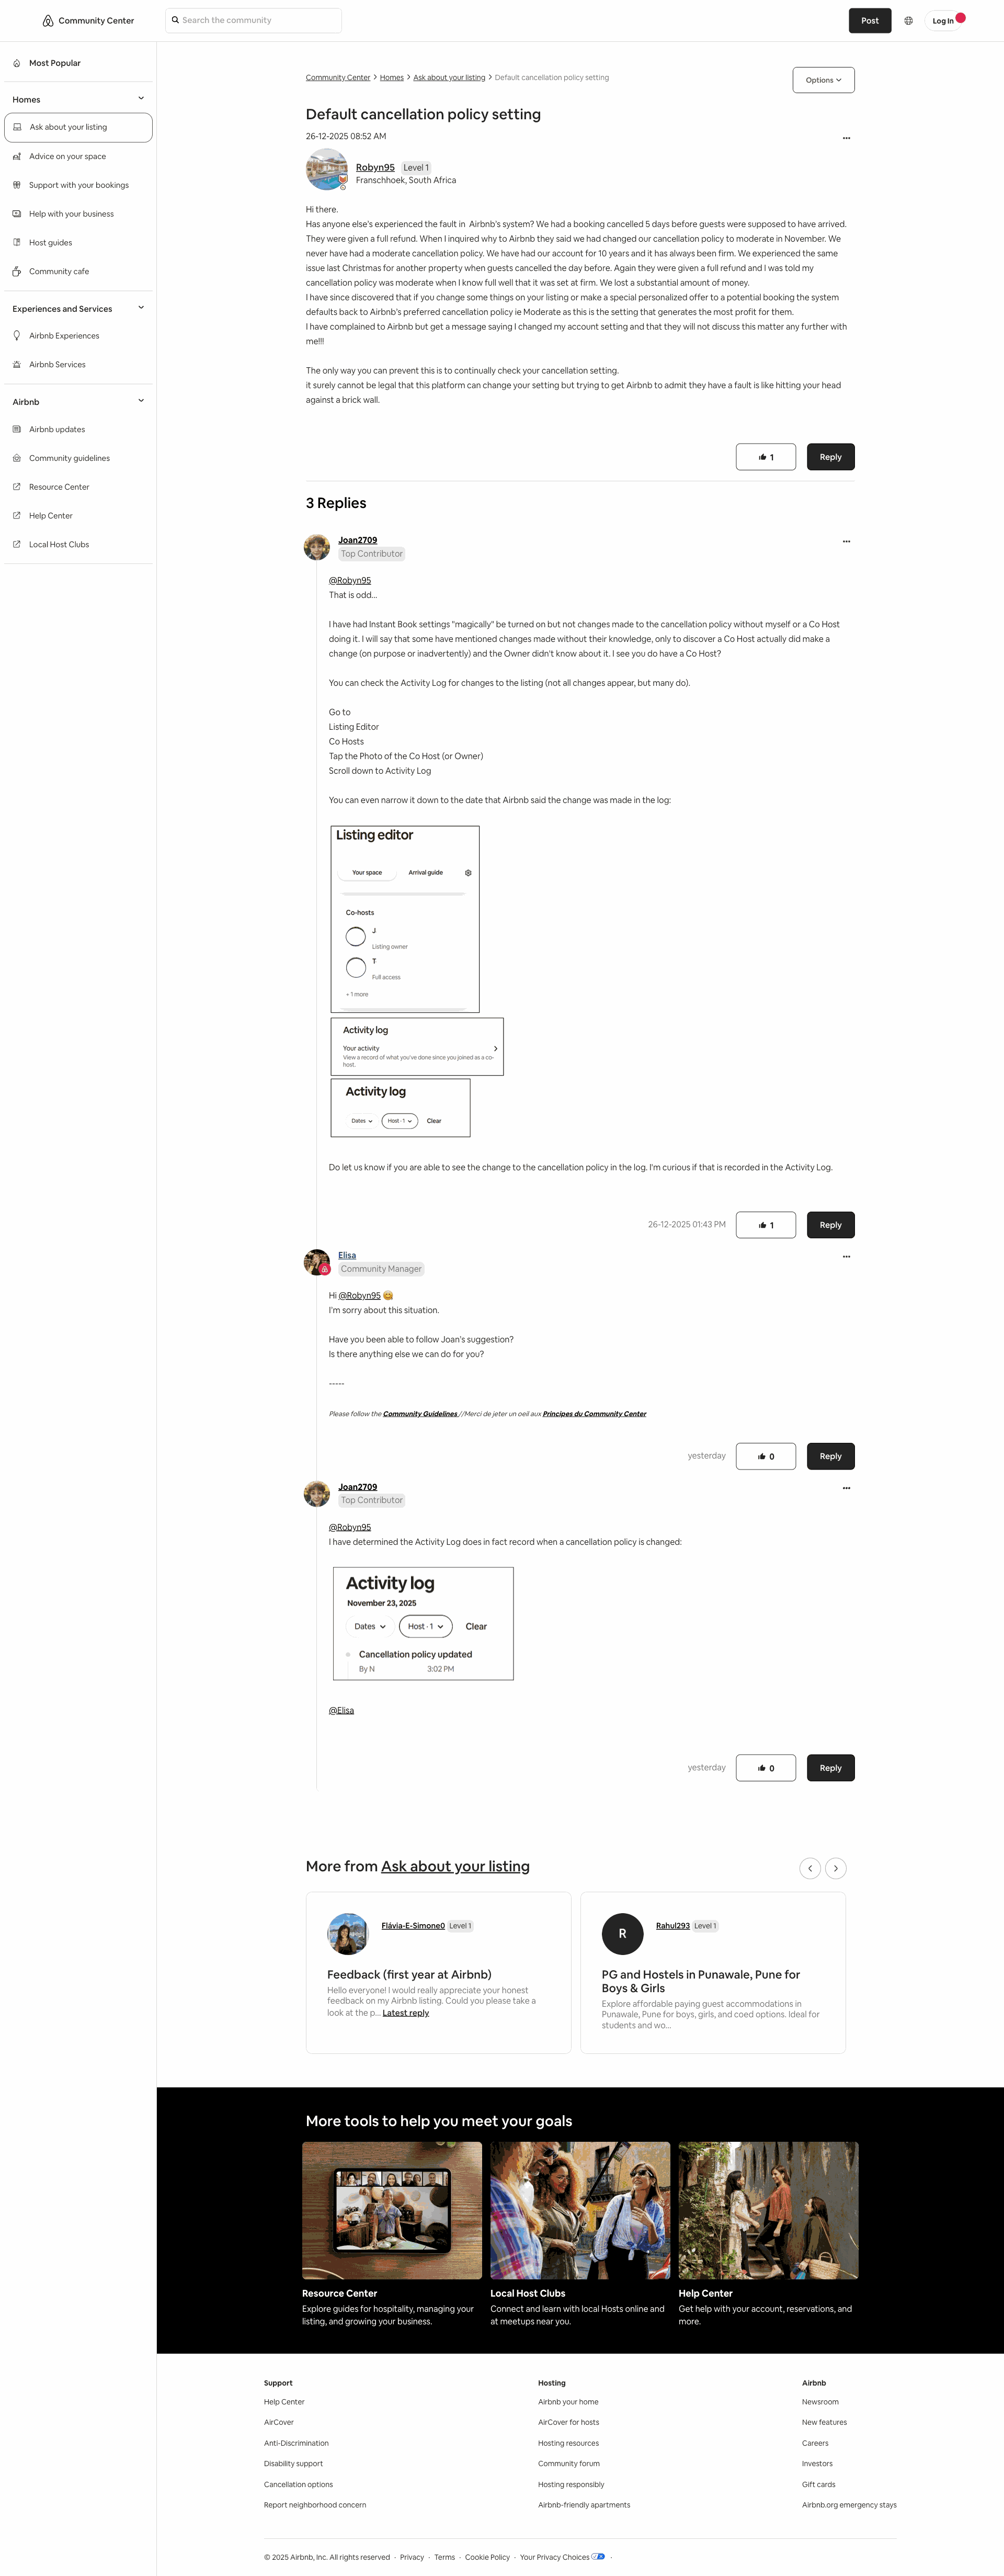
Figure 7 展示同页三设备形态;Figure 8 的主页、服务页、联系我们页面说明跨页复刻范围;Figure 9 展示主页、对话与登录视图。原型图仅表达目标状态,不能单独替代交互需求文档。
Our Interpretation · 教学记号 \(\mathcal{P}\) 是原型集合,\(D\) 是需求,\(\mathcal{R}\) 是素材;\(\mathcal{A}_{\theta}\) 表示模型驱动的开发 Agent,\(\mathcal{E}\) 是工具/运行环境,\(B\) 为执行预算;\(C\) 是生成代码与部署产物,\(W\) 是可访问的网站。这是本页为解释流程引入的记号,不是论文提出的训练目标或概率模型。
执行环境承担编译、启动与浏览器渲染。论文不要求某一种 latent、tokenization 或代码生成解码器,也没有统一 beam search / top-p 的方法创新;这些因素若影响复现,必须作为具体模型与框架设置记录。
使用 HTML 标签分布、DOM 深度和 token 长度检查页面;排除结构畸形、布局过于简单、语义不足的样本。63,515 是该阶段留下的候选网站数量,论文没有在这里给出完整初始池大小。
VLM 评估功能丰富度、模块清晰度与视觉一致性,保留 7,391 页;排除交互贫乏、组织混乱、功能覆盖低的候选。从 63,515 到 7,391 的保留率约 11.64%,是本页复算,而不是论文单列指标。
审核跨设备一致性、实现难度、页面尺寸、交互的清晰度与丰富性,并控制类别覆盖。网站来源与最终开发任务不是无需人工处理的直接一一转换;不能把 193/7,391 当成一个严格自动筛选器的性能。
作者称通过 C4 validation 来源降低污染风险,并使用“contamination-free”措辞。但 C4 validation 并不等于任意商业模型的未见数据:同一网页可能经其他抓取进入预训练,也可能有近重复。原文未提供各受测模型训练集级别的排重证明。因此能确认的是来源控制策略,不能确认零污染。筛选 VLM 的具体版本、所有分数阈值和完整筛选日志也未在所读正文/附录中充分列出。
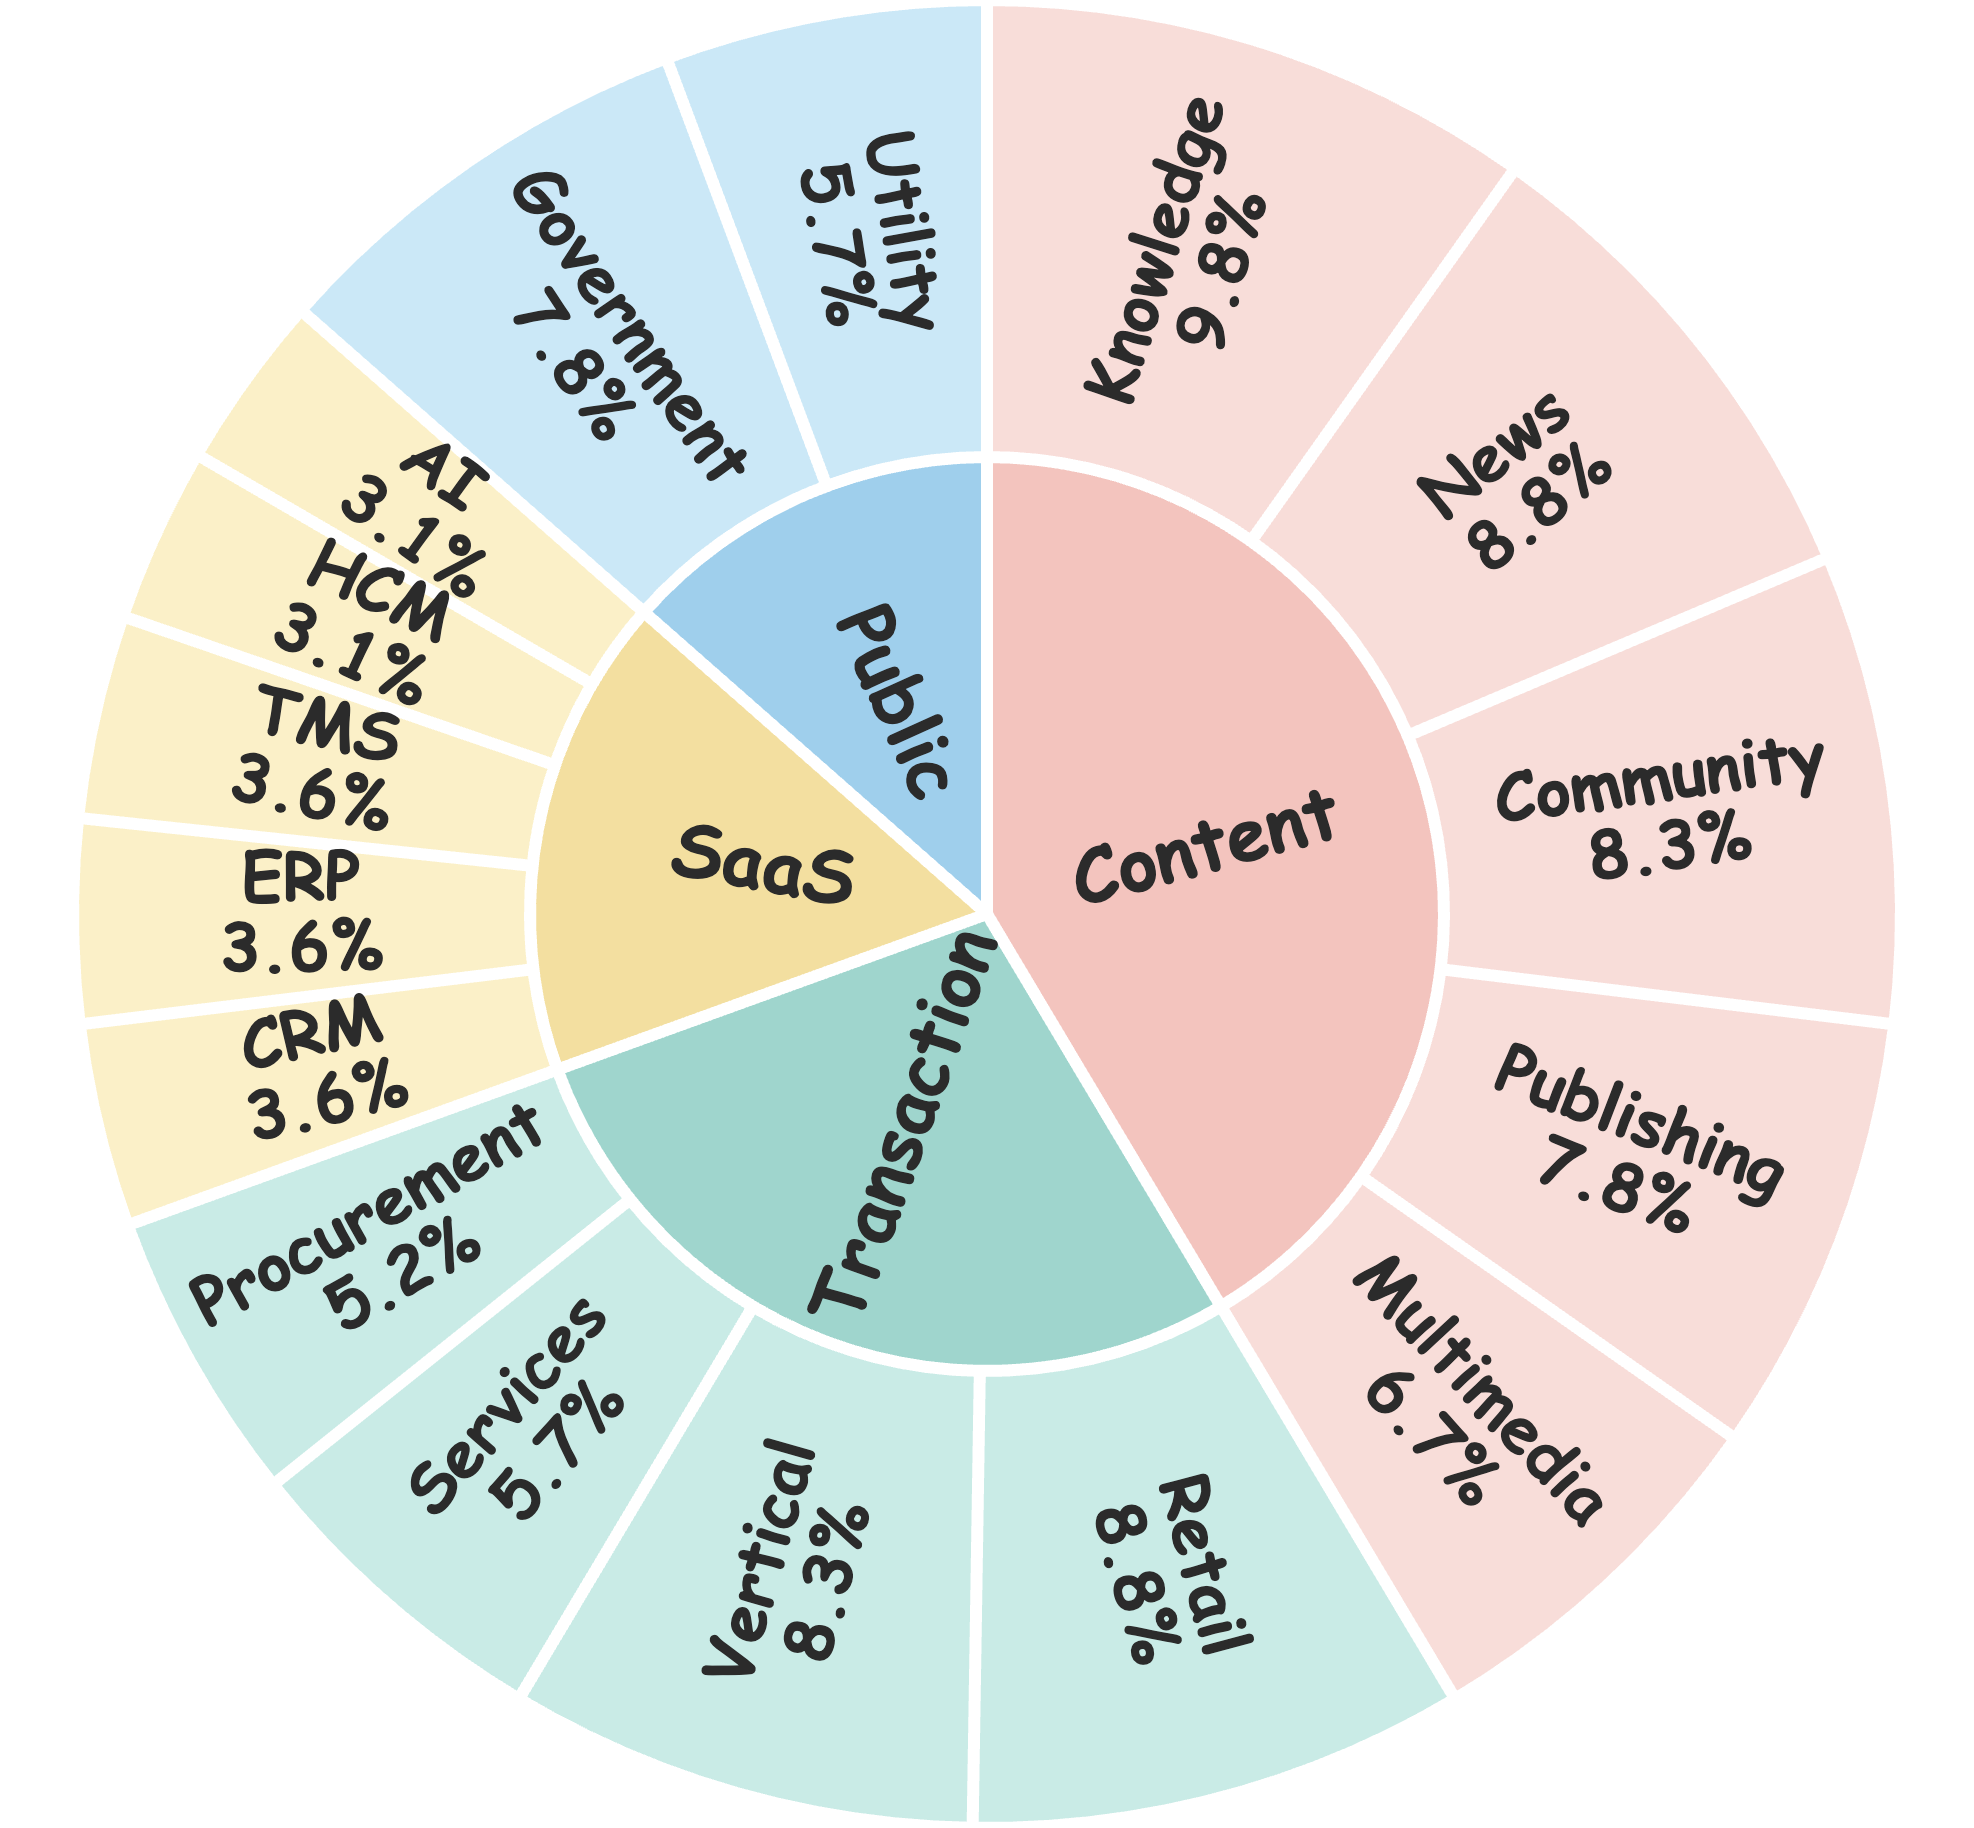
分类体系来自前端工程师访谈与计算机专业博士生整理。以下按 Table 7–8 合并,原论文中的知名网站名是类别示例,不能据此推断这些品牌都是最终测试样本。搜索可查看具体子类。
| 大类 | 子类 | L1 | L2 | L3 | 能力解读(本页) |
|---|---|---|---|---|---|
| Content 内容 | News 新闻 | 8 | 7 | 2 | 内容层级、信息浏览 |
| Content 内容 | Community 社区 | 8 | 6 | 2 | 帖子、互动、账号状态 |
| Content 内容 | Multimedia 多媒体 | 6 | 5 | 2 | 资源呈现与媒体交互 |
| Content 内容 | Knowledge 知识 | 10 | 7 | 2 | 课程/知识导航 |
| Content 内容 | Publishing 出版 | 8 | 5 | 2 | 创作与内容展示 |
| Transaction 交易 | Retail 零售 | 10 | 5 | 2 | 商品与交易链 |
| Transaction 交易 | Vertical Markets 垂直市场 | 8 | 6 | 2 | 领域搜索与预订 |
| Transaction 交易 | Services 服务 | 6 | 3 | 2 | 服务申请与业务表单 |
| Transaction 交易 | Procurement 采购 | 4 | 4 | 2 | 企业采购流程 |
| SaaS 平台 | CRM 客户管理 | 3 | 3 | 1 | 客户信息 CRUD |
| SaaS 平台 | HCM 人力管理 | 3 | 2 | 1 | 人员数据与权限 |
| SaaS 平台 | ERP 企业资源 | 5 | 1 | 1 | 跨模块资源状态 |
| SaaS 平台 | TMS 任务管理 | 3 | 3 | 1 | 任务流与状态更新 |
| SaaS 平台 | AI Platform | 3 | 2 | 1 | 服务交互与会话 |
| Public Services 公共服务 | Government Portal 政府门户 | 9 | 4 | 2 | 信息与服务入口 |
| Public Services 公共服务 | Public Utility 公用事业 | 6 | 3 | 2 | 公共信息及服务流程 |
Table 8 复算总计:Content 40/30/10;Transaction 28/18/8;SaaS 17/11/5;Public Services 15/7/4;三个层级合计 100/66/27。覆盖广不代表均匀抽样;L3 部分 SaaS 子类仅 1 个任务。
论文 Figure 6 用静态网页 DOM 统计对比 Design2Code-Hard:平均标签数 1,385±985 对 251±232;平均 DOM 深度 22±7 对 10±4;不同标签类型数 40±14 对 22±5。结构规模明显更高,但 DOM 复杂度是难度代理变量,不是对 Agent 推理难度的直接测量。
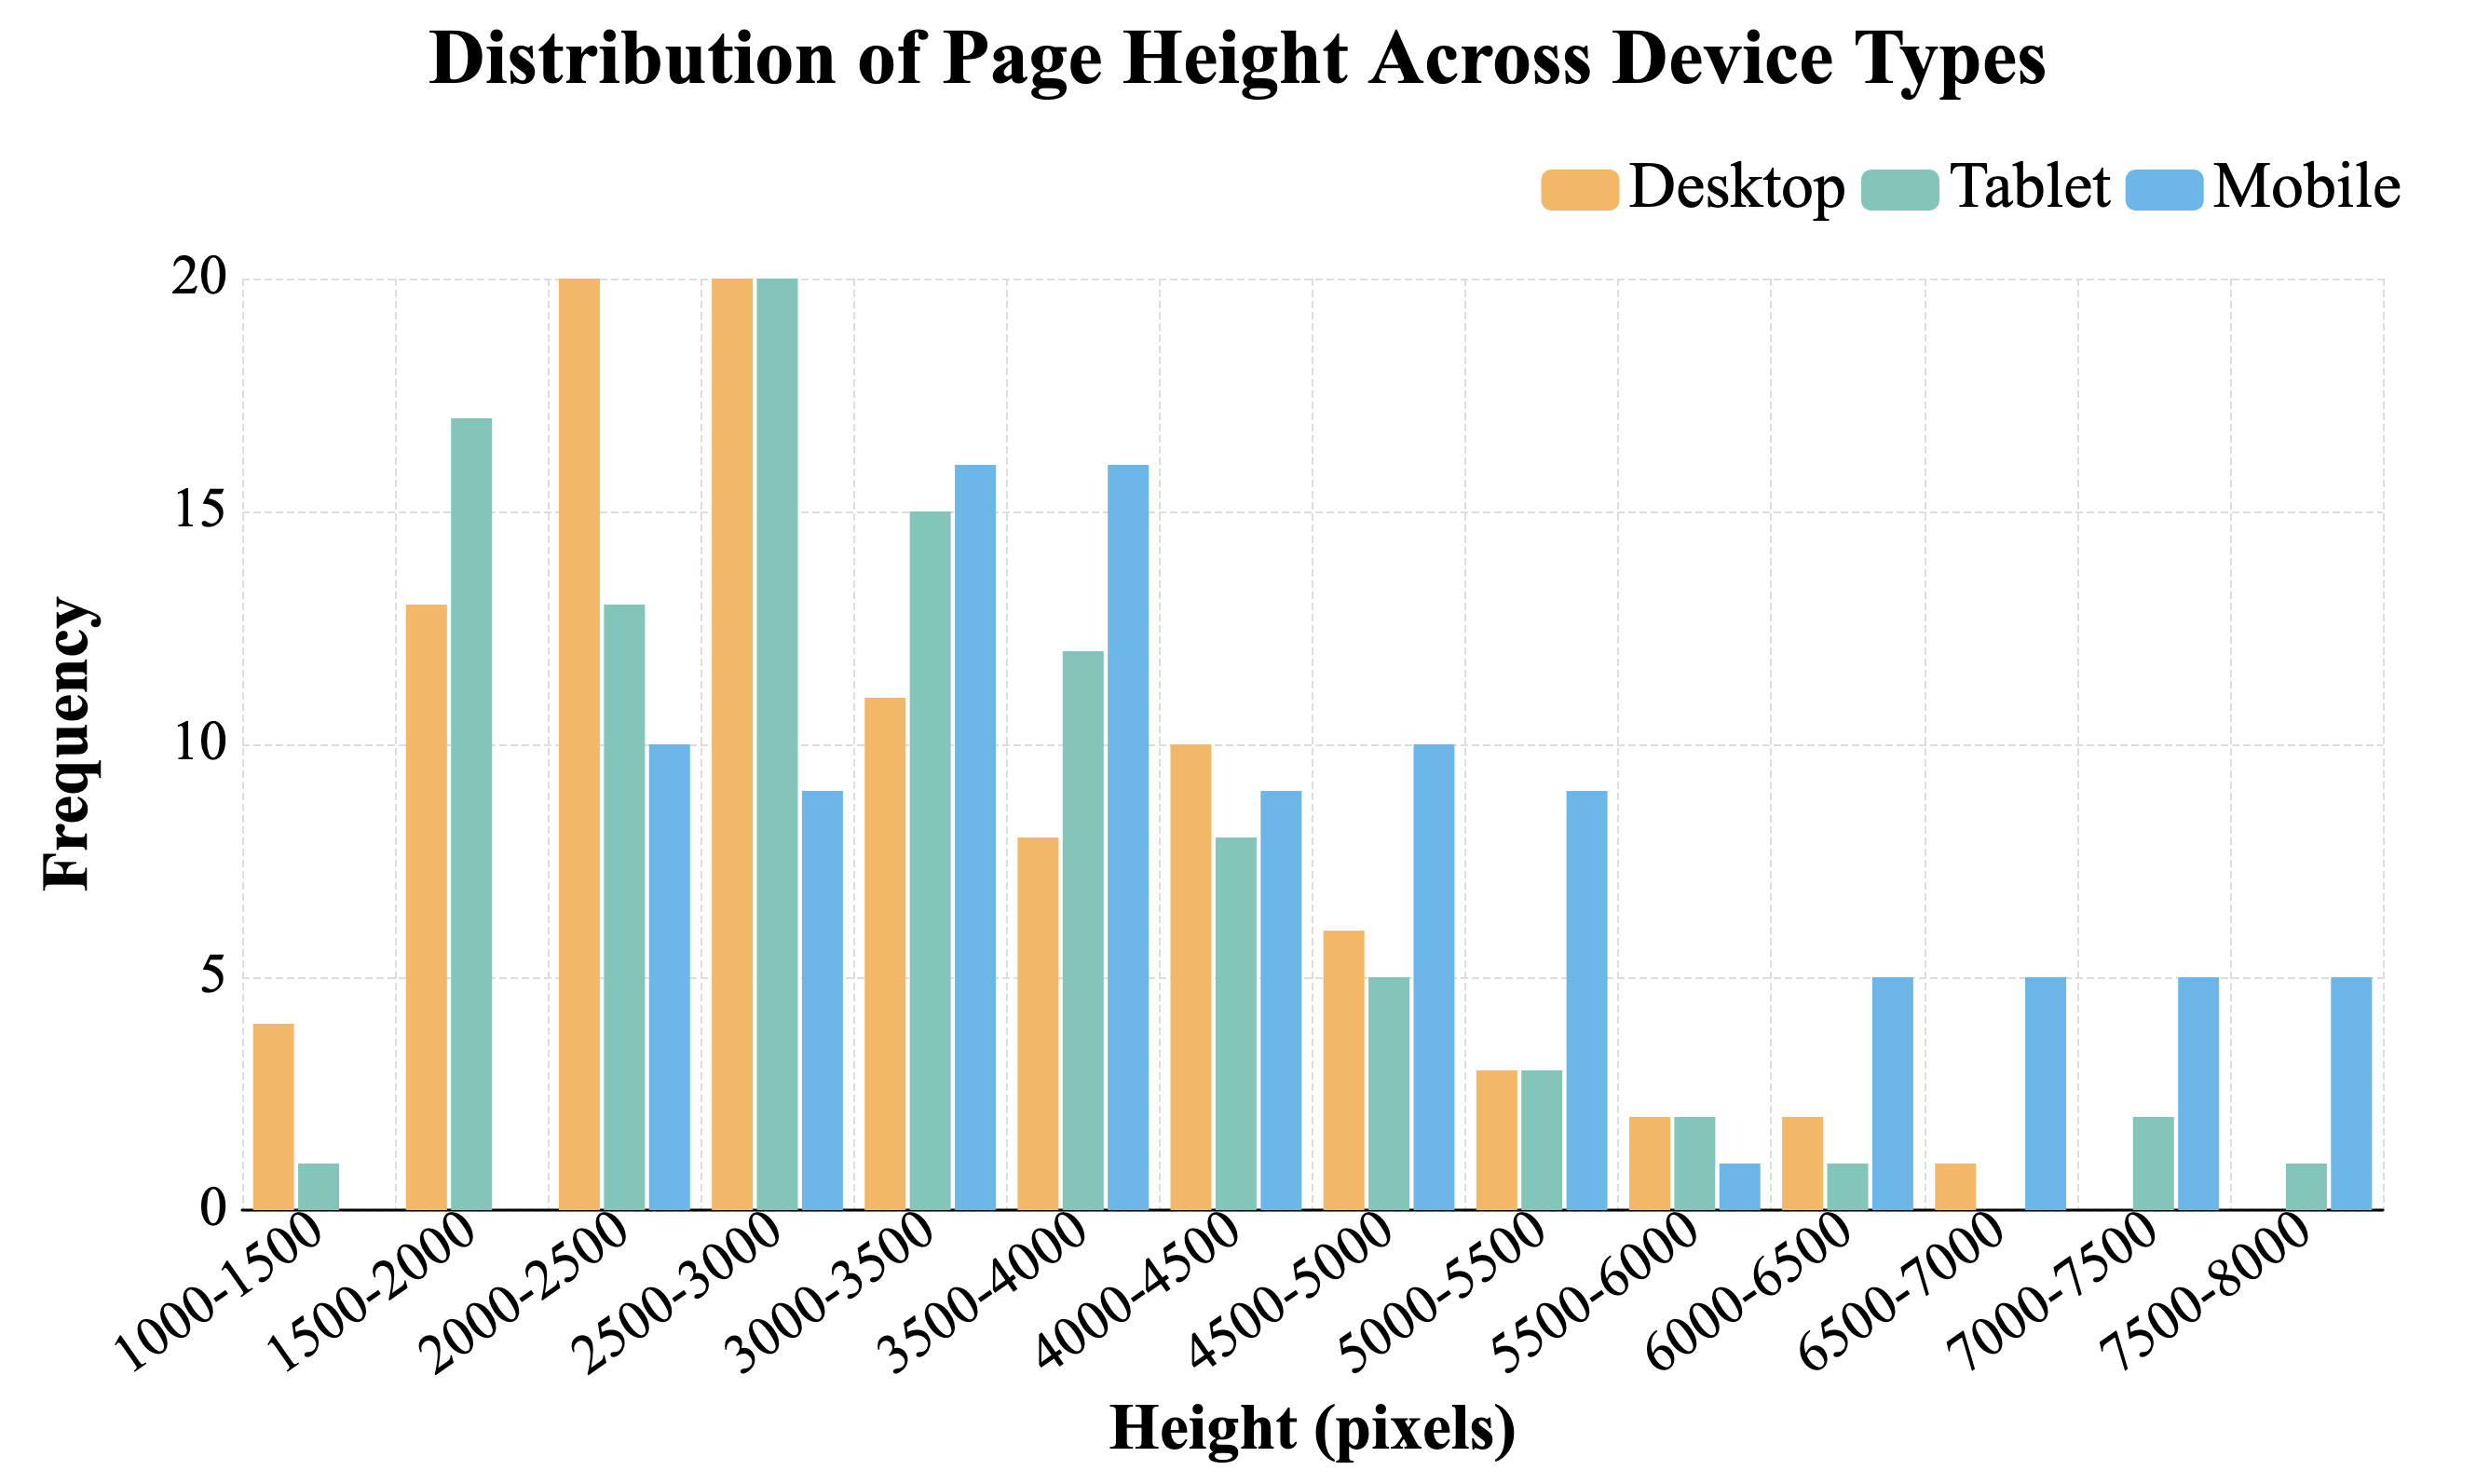
Figure 5 表明三种设备截图的高度分布不同。长页面同时增加视觉输入负担、遗漏风险和素材匹配需求。Figure 4 则分析高度与视觉表现的关系,见实验章节。
datasets/
  webpage/  → 100 个任务
  frontend/ → 66 个任务
  website/  → 27 个任务
每个任务的材料(按层级适用):
  prototypes/   原型图片及设备形态
  resources/    图像、图标、字体、视频等
  prompt.txt    L2 需求文字
  prd.md        L3 产品需求
  workflow.json 评测用工作流
官方数据仓库包含这些材料。workflow.json 的存在不代表应把隐藏评分规则提供给生成 Agent;复现实验应检查推理阶段输入如何构造,并记录是否发生测试规格泄漏。全量共有 21,516 个输入文件,918 是原型图数量,不是所有图片素材的数量。本文无专用训练集训练过程,193 项是评测任务,不应自行编造 train/val/test 比例。[3]
从 PRD 和原型确定用户目标、先决条件、动作序列、预期结果和共享状态;既拆分过长依赖链,又合并相关检查。
把草案转成 objective–action–validation 结构,补清动作与判断条件,提示遗漏边界;不能脱离原始需求自创正确答案。
检查完整性、正确性与需求一致性;去除重复、歧义及绑定某种实现的断言,保留用户可观察的行为。
Our Interpretation质量控制的关键是测试规格是否唯一且必要,不是标注文本是否足够长。原文没有完整量化标注工时、不同审核员一致率或需求覆盖率,因此无法仅凭“专家参与”推出标注已无遗漏。
| 测试类 | 典型观察(本页说明) | 主要能力 |
|---|---|---|
| Navigation & Routing | 点击进入正确页面;返回后上下文是否合理 | 路由与跨页关系 |
| State Management | 操作后其他视图是否同步;刷新后的状态是否满足要求 | 状态传递与持久化 |
| Form Interaction | 必填项为空时阻止提交;合法输入可完成 | 校验与提交链 |
| UI Feedback | 成功、错误、加载、空态是否按要求出现 | 反馈与异常路径 |
| Authentication & Authorization | 登录态控制入口及动作权限 | 身份与权限 |
| CRUD Operations | 创建、读取、修改、删除后结果一致 | 数据流与业务逻辑 |
| Search / Filter / Sorting | 查询、筛选、排序是否改变正确集合 | 列表与条件组合 |
| File & Media Operations | 资源操作与显示是否完成 | 浏览器与系统资源整合 |
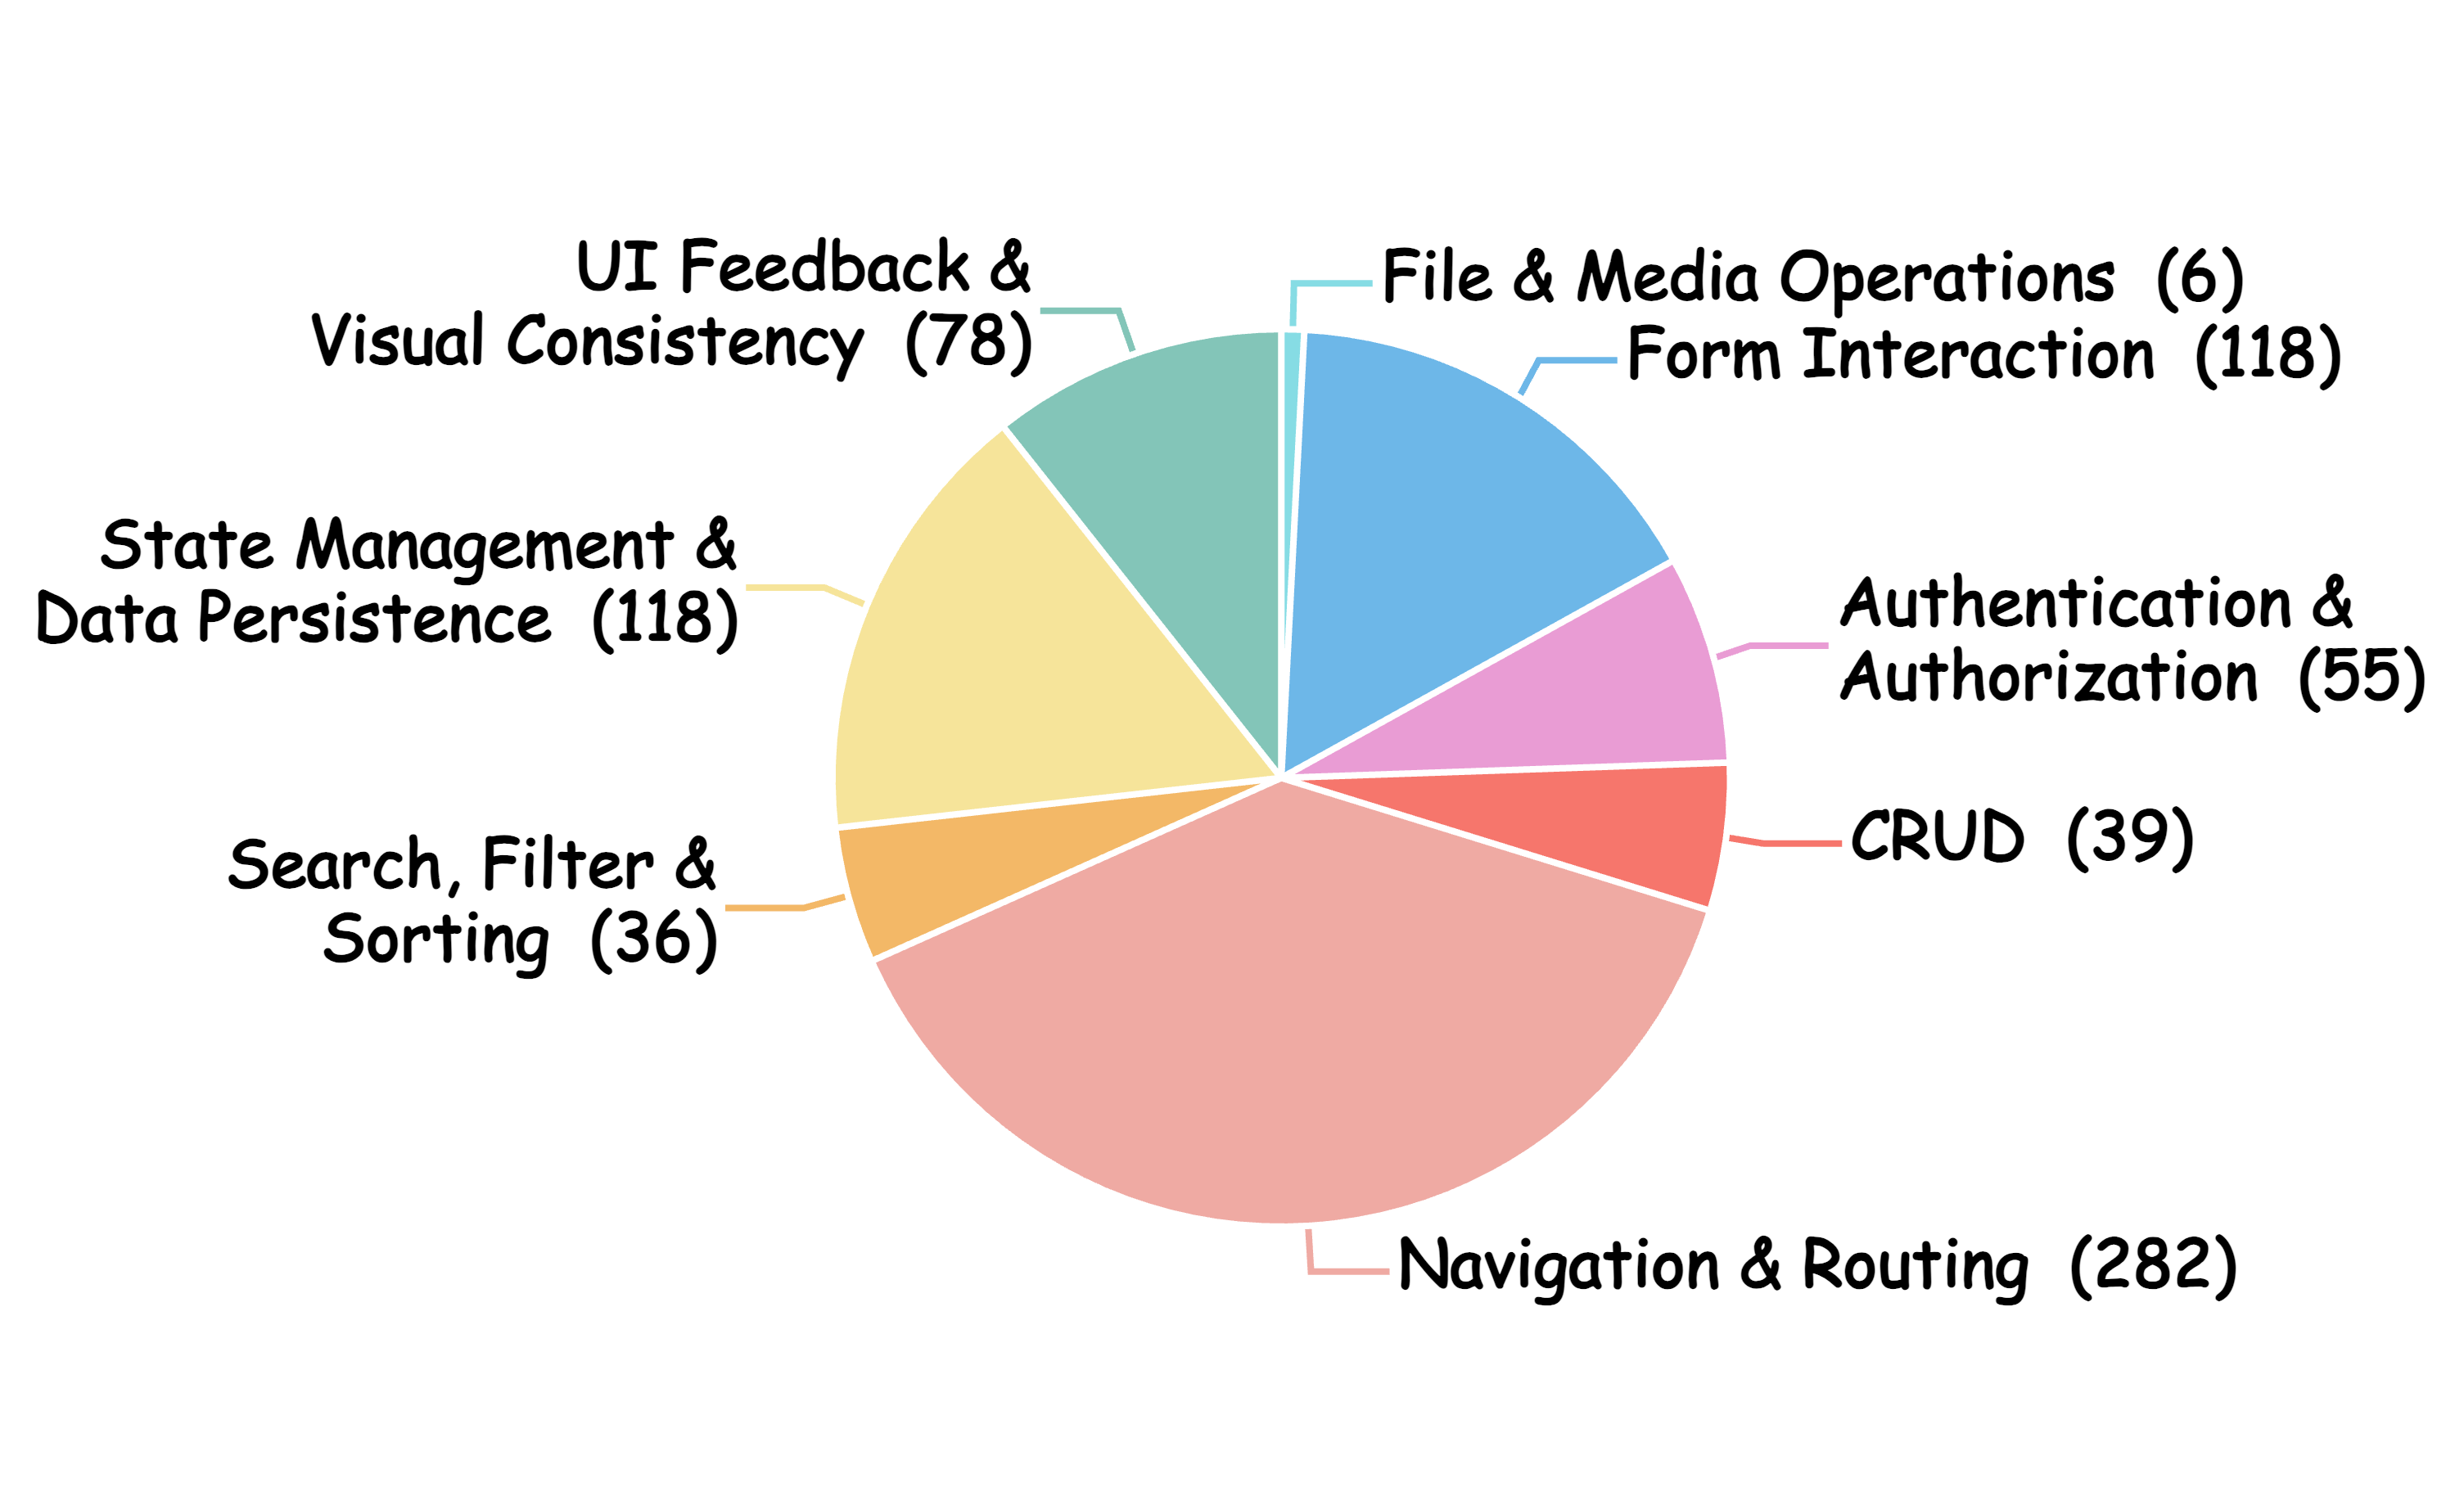
Figure 3 是全栈任务的用例类型分布。上表“典型观察”为类别解释,不宣称每个例子都逐项出现在数据集中;真实测试以 workflow.json 为准。
一个“点击提交”的结果,取决于之前是否登录、字段是否填写、页面是否到达。论文把这些依赖显式组织起来,而不是独立询问模型“这个网站好不好”。
论文将整体测试视为有向依赖图:节点是可独立描述的验证子过程,边表示顺序依赖和共享状态。\(G,N,E\) 是本页的辅助记号;\(\mathcal{W}\) 是具体可执行工作流。多条工作流共同覆盖图中节点。[1, §3 & Algorithm 1]
浏览商品 → 加购物车 → 结账,若放成一条很长的链,首步失效可能遮蔽后续能力。论文倾向拆成不同工作流,降低错误传播。
同一表单里的输入、必填校验与成功提交放在共享会话中,避免不断重建登录和导航状态。
Our Interpretation“拆分”并不自动保证每条 workflow 有可独立重置的数据库快照。复现时仍需检查各流的前置条件、账号、清理规则和重跑副作用;有依赖的实际应用状态不会因为测试命名不同就消失。
论文的功能验证器以 WebVoyager 任务执行协议为基础,用 GLM-4.6V 处理当前观察、思考并选择 GUI 动作。原文简化 prompt 的动作空间包含 Click、Type、Scroll、Wait、GoBack、Refresh、Key、Answer;输入包括整页与当前 viewport 截图,输出为 Thought 与 Action。这是测试 Agent 的循环,不是网站生成 Agent 的训练过程。
\(P_i\) 是目标原型,\(S_i\) 是浏览器/应用状态,\(s_i\) 是评分(本页改用小写以避免与验证条件 \(V_i\) 混淆)。视觉节点可以处在登录、导航或填表之后;因此 VS 不一定只测网站首页。若导航失败,后续截图可能反映错误页面,这同时包含到达状态失败和视觉复刻失败的影响。
下列内容来自附录 A.2.1(PDF pp.17–18),原文标为 Simplified Workflow Example。视口 1920×1080,整个流程在同一浏览器会话执行。可点击步骤查看验证目的。
关键细节:准备节点的 validations 为 None;当前分析代码只把有 validations 的功能节点纳入 FS 分母。一次功能节点可能含多个断言,评分单位仍是节点,而不是给每条断言分别加一分。视觉节点“Prototype: post”则触发截图比对,并不产生功能通过分。
伪代码本身没有详尽定义失败恢复、每步预算、跨工作流数据库重置策略。不要将这些工程细节当成已经由 Algorithm 1 充分规定。
以下公式把 §3.2 的自然语言定义显式化,并与核查的 analyzer.py 对照。VS/FS 对外通常报告在 0–100 尺度。[1][4]
\(N_{\ell}\) 是某层全部计分功能节点数量。当前实现为有 validations 的用例初始化 0 分,成功结果文件中的 Pass 记为 1;Fail、Blocked 或缺失结果保持 0。先汇集所有节点,再求平均:用例较多的任务对该层 FS 的权重更高,并非每个网站先算通过率后等权平均。
\(K_p\) 为评审对第 \(p\) 张原型划分的组件数,\(q_{p,k}\) 是组件分数;\(M_{\ell}\) 为该层原型总数。组件先等权平均,各原型再等权平均。这意味着多原型任务占更大权重,但组件较多的页面不会仅因组件多就在第二次平均中更重。
| 组件分数 | 原文评分含义(中文转述) | 理解时要注意 |
|---|---|---|
| 1.00 | 位置、间距、字体、文本、色彩、图标与素材精确一致 | 最高档要求无可见差异 |
| 0.75 | 极小偏差,轻微错位、文本或素材差异;prompt 举出小于 2px 的错位 | 这是 VLM rubric,不是执行了像素阈值算法 |
| 0.50 | 布局大致对应,但明显错位、文本差异或素材不准确 | “能认出来”不意味着高分 |
| 0.25 | 组件可辨认,整体布局和内容偏差大 | 仍有部分对应关系 |
| 0.00 | 缺失、完全错放或不相关 | 丢失功能区可被压到零分 |
VLM 自动按有意义的功能区分块,输出 name、score、reason 的 JSON 列表。论文使用 Gemini-3-Pro-Preview。没有固定的人工区域掩码,也不是像素面积加权。分块粒度会改变分数:同一大片内容被切成 5 块与 1 块,和其余区域的相对权重可能不同。
前三个层级 Avg 与论文 Table 3 对齐;最后 Overall 来自当前官方分析实现,原文主表并未列出单一 Overall 列。它对三层等权,因此 L3 的 27 项与 L1 的 100 项对总分各占三分之一。
教学情景:网站 A 有 2 个节点并全部通过;网站 B 有 8 个节点。改变 B 的通过数,观察池化分数与“按网站平均”的差别。
本例仅解释权重,不对应论文真实任务,也不作为替代官方分数。
DSR 表示能否成功部署,Table 3 将其作为参考而非官方核心指标。以 OpenHands + GPT-5 为例,L3 DSR 为 100%,但 VS 18.3、FS 49.7、Avg 34.1:全部启动成功不等于所有功能正确。当前代码把失败部署对应的原型/功能结果保留为零,不能只筛出成功部署的样本后报告更好看的均值。
VS 与 FS 各 50% 允许互相补偿:视觉高、业务弱与视觉弱、业务强可能同分。应同时展示二维分数和 DSR,而非只报 Overall。固定的 193 项若长期公开使用,还需防范 benchmark 特化与隐藏测试泄漏。
论文主实验:8 个多模态模型,分别放入 Claude Code 与 OpenHands。比较的是端到端系统,不应把框架、模型、部署与环境影响全部归因于视觉理解。
以下保留全部 16 组结果与 DSR。表格可横向滚动;同一框架内各指标最佳值加粗、次佳值加下划线(DSR 不做名次标记)。“Avg”是相应层级综合分,不是网站完成百分比。
| 框架 | 模型 | L1 Desktop | L1 Tablet | L1 Mobile | L1 Avg | L1 DSR | L2 VS | L2 FS | L2 Avg | L2 DSR | L3 VS | L3 FS | L3 Avg | L3 DSR |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Claude Code | Claude-Opus-4.5 | 54.2 | 50.4 | 46.8 | 50.5 | 94.0% | 46.1 | 63.6 | 54.9 | 98.5% | 34.3 | 53.1 | 43.7 | 92.6% |
| Claude Code | Claude-Sonnet-4.5 | 44.7 | 38.6 | 36.7 | 40.0 | 89.0% | 24.9 | 48.7 | 36.8 | 93.9% | 14.5 | 26.8 | 20.7 | 66.7% |
| Claude Code | GPT-5 | 45.3 | 44.2 | 39.9 | 43.1 | 97.0% | 23.3 | 64.7 | 44.0 | 98.5% | 9.6 | 23.4 | 16.5 | 85.2% |
| Claude Code | Gemini-3-Pro-Preview | 59.2 | 51.5 | 46.2 | 52.3 | 92.0% | 13.3 | 14.6 | 14.0 | 65.2% | 5.7 | 12.9 | 9.3 | 63.0% |
| Claude Code | Gemini-3-Flash-Preview | 48.5 | 41.7 | 39.7 | 43.3 | 92.0% | 13.1 | 27.9 | 20.5 | 78.8% | 2.3 | 4.6 | 3.5 | 63.0% |
| Claude Code | Seed-1.8-VL | 20.1 | 18.6 | 15.3 | 18.0 | 43.0% | 7.0 | 13.3 | 10.2 | 36.4% | 0.0 | 0.0 | 0.0 | 0.0% |
| Claude Code | Qwen3-VL-32b-Instruct | 0.9 | 1.0 | 0.8 | 0.9 | 3.0% | 0.0 | 0.0 | 0.0 | 0.0% | 0.0 | 0.0 | 0.0 | 0.0% |
| Claude Code | Qwen3-VL-8b-Instruct | 12.4 | 11.9 | 11.3 | 11.9 | 46.0% | 0.0 | 0.0 | 0.0 | 0.0% | 0.0 | 0.0 | 0.0 | 0.0% |
| OpenHands | Claude-Opus-4.5 | 58.9 | 53.7 | 47.7 | 53.4 | 98.0% | 46.5 | 66.7 | 56.6 | 98.5% | 38.4 | 57.6 | 48.0 | 96.3% |
| OpenHands | Claude-Sonnet-4.5 | 51.9 | 44.9 | 44.4 | 47.1 | 100.0% | 32.4 | 59.0 | 45.7 | 97.0% | 15.7 | 23.9 | 20.4 | 66.7% |
| OpenHands | GPT-5 | 49.0 | 44.6 | 40.5 | 44.7 | 100.0% | 23.9 | 61.4 | 43.2 | 100.0% | 18.3 | 49.7 | 34.1 | 100.0% |
| OpenHands | Gemini-3-Pro-Preview | 63.3 | 55.8 | 48.3 | 55.8 | 95.0% | 29.7 | 40.7 | 35.2 | 93.9% | 11.7 | 22.6 | 17.2 | 77.8% |
| OpenHands | Gemini-3-Flash-Preview | 53.0 | 46.2 | 44.3 | 47.8 | 88.0% | 25.9 | 38.4 | 32.2 | 93.9% | 7.7 | 17.2 | 12.5 | 66.7% |
| OpenHands | Seed-1.8-VL | 1.1 | 1.4 | 1.4 | 1.3 | 72.0% | 7.5 | 33.9 | 20.2 | 56.1% | 0.0 | 0.0 | 0.0 | 14.8% |
| OpenHands | Qwen3-VL-32b-Instruct | 0.0 | 0.0 | 0.0 | 0.0 | 4.0% | 0.0 | 0.0 | 0.0 | 0.0% | 0.0 | 0.0 | 0.0 | 0.0% |
| OpenHands | Qwen3-VL-8b-Instruct | 0.2 | 0.0 | 0.1 | 0.1 | 51.0% | 0.0 | 0.0 | 0.0 | 0.0% | 0.0 | 0.0 | 0.0 | 0.0% |
OpenHands + Gemini-3-Pro-Preview 从 L1 Avg 55.8 到 L3 Avg 17.2,相差 38.6 分。静态图复刻表现不能替代全栈能力判断。
OpenHands + Opus-4.5 的 L3 Avg 为 48.0(VS 38.4、FS 57.6),在论文主表中领先,但功能与视觉都仍有较大缺口。
GPT-5 的 L3 Avg 从 Claude Code 的 16.5 到 OpenHands 的 34.1,提高 17.6 分。框架差异足以显著改变结论。
作者概括“复杂度越高性能持续下降”,但这不是每个层级相邻分数都严格单调的定理:Opus-4.5 在 OpenHands 的 L1 Avg 53.4、L2 Avg 56.6、L3 Avg 48.0;Claude Code 下也有 L2 高于 L1 的情况。L1 只有 VS,L2 的 Avg 加入了 FS,而且任务集合不同,不能将这三项当作同一样本的受控难度曲线。
OpenHands + Gemini-3-Pro-Preview 桌面 63.3、平板 55.8、手机 48.3;桌面到手机下降 15.0 分,约为桌面分数的 23.7%。这也说明论文“10–20%”概括需要分清相对百分比与百分点,并非所有条目都落入该范围。Opus-4.5 对应 58.9 → 47.7,下降 11.2 分。
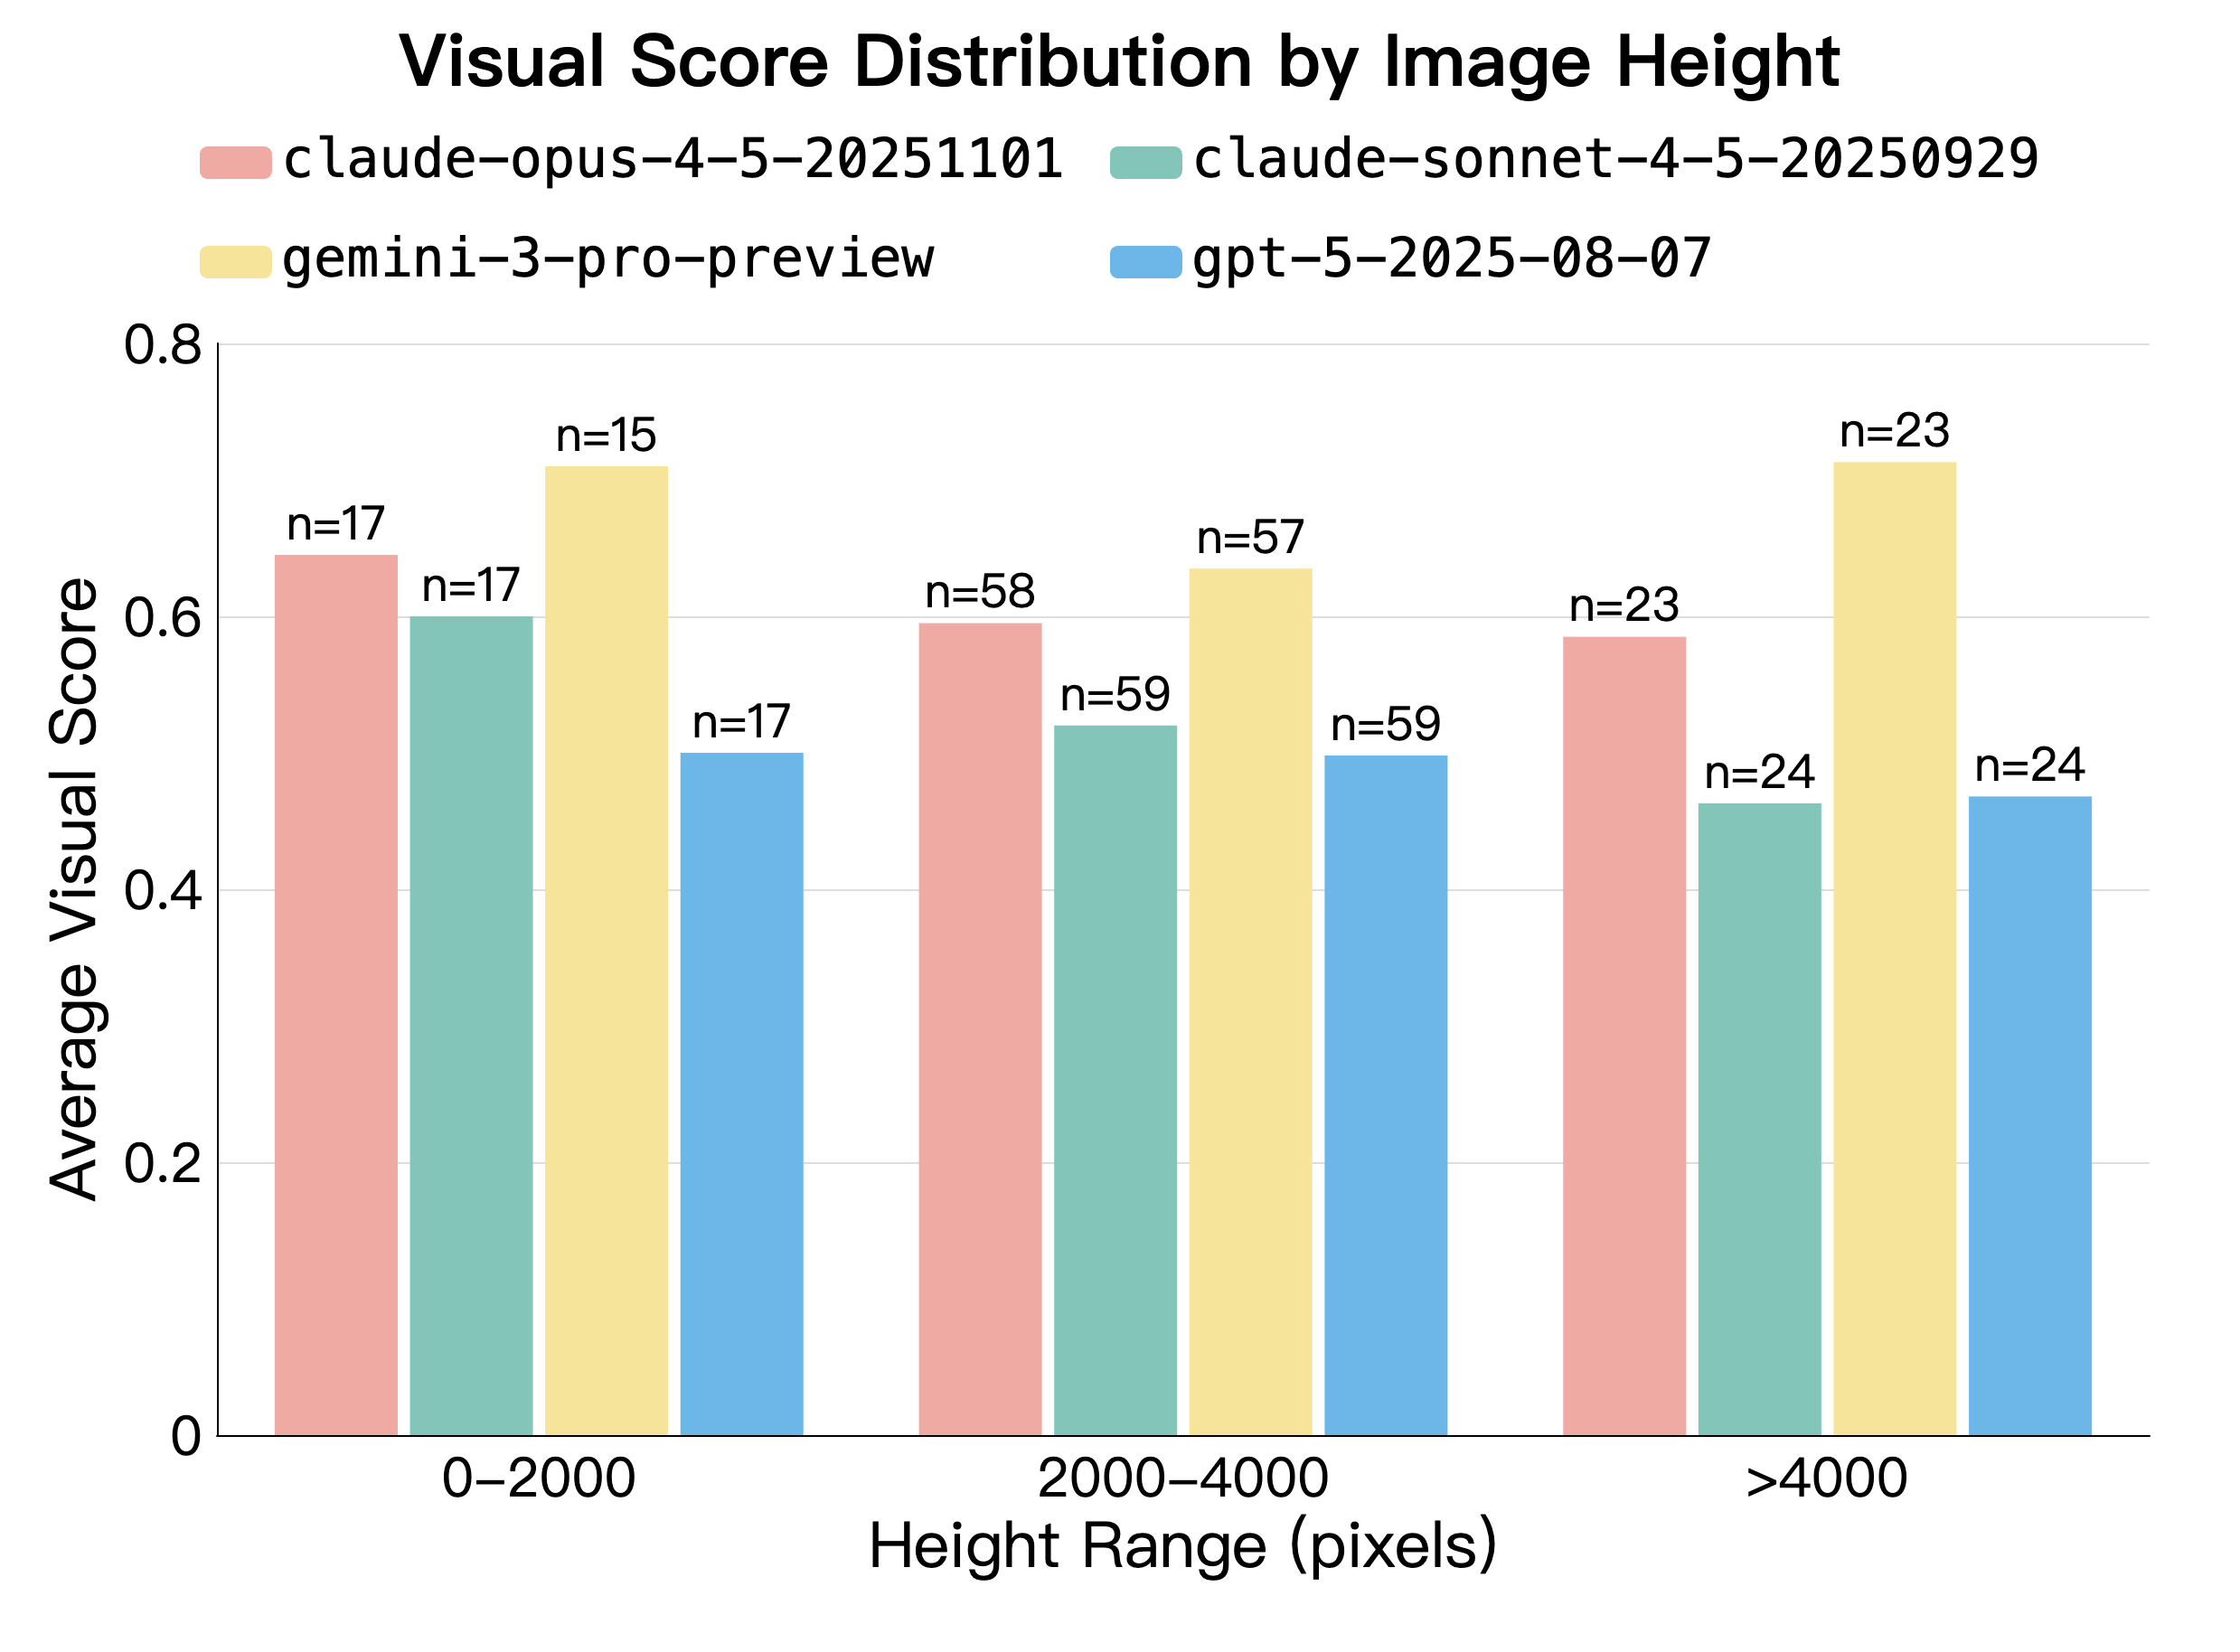
Figure 4 是原型高度与 VS 的分布关系。它支持长/密集页面更困难的关联观察,但未隔离文本长度、模块数量、图像压缩、素材难度等混杂因素;“视觉输入太长导致失败”仍不是严格的因果消融。
| Website Category | Opus-4.5 | Sonnet-4.5 | GPT-5 |
|---|---|---|---|
| Content | 37.1 / 61.2 | 9.3 / 16.1 | 20.7 / 53.5 |
| Transaction | 43.2 / 64.9 | 10.8 / 14.3 | 13.4 / 50.6 |
| SaaS Platform | 22.9 / 39.9 | 21.7 / 42.8 | 16.7 / 40.5 |
| Public Service | 56.9 / 60.0 | 41.2 / 52.0 | 27.4 / 56.0 |
Opus-4.5 在公共服务 VS/FS 为 56.9/60.0,SaaS 为 22.9/39.9。作者将差异解释为后者有更多跨页与复杂交互。注意:SaaS 下 Sonnet-4.5 的 FS 42.8、GPT-5 的 FS 40.5 都略高于 Opus 的 39.9;“总体最好”不代表每个子项都最好。L3 子类样本小,类别差异不宜过度外推。
| Test Case Category | Opus-4.5 | Sonnet-4.5 | GPT-5 |
|---|---|---|---|
| Navigation & Routing | 66.3 | 25.9 | 53.9 |
| State Management | 43.2 | 16.1 | 41.5 |
| Form Interaction | 49.2 | 23.7 | 56.8 |
| UI Feedback | 56.4 | 23.1 | 30.8 |
| Authentication & Authorization | 61.8 | 25.5 | 60.0 |
| CRUD Operations | 43.6 | 20.5 | 35.9 |
| Search / Filter / Sorting | 55.6 | 16.7 | 50.0 |
| File & Media Operations | 33.3 | 0.0 | 16.7 |
Opus 的导航路由 66.3,但状态管理 43.2、CRUD 43.6、文件媒体 33.3;GPT-5 的表单交互 56.8 高于 Opus 的 49.2。这些数据适合定位错误类别,不能把某类低分直接归结为单一内部能力缺陷。比如文件操作还会受浏览器工具和执行环境影响。
间距、尺寸、颜色与规则重复组件不匹配;依赖资源文件名猜图,文件名模糊时容易用错素材。
首页尚可,后续页面缺失或布局不一致;交互失效、链接断裂,组件与状态无法协调。
弱系统常在缺页、启动或崩溃处失效;较强系统主要暴露数据库持久化、API 路由、前后端数据流及边界条件问题。
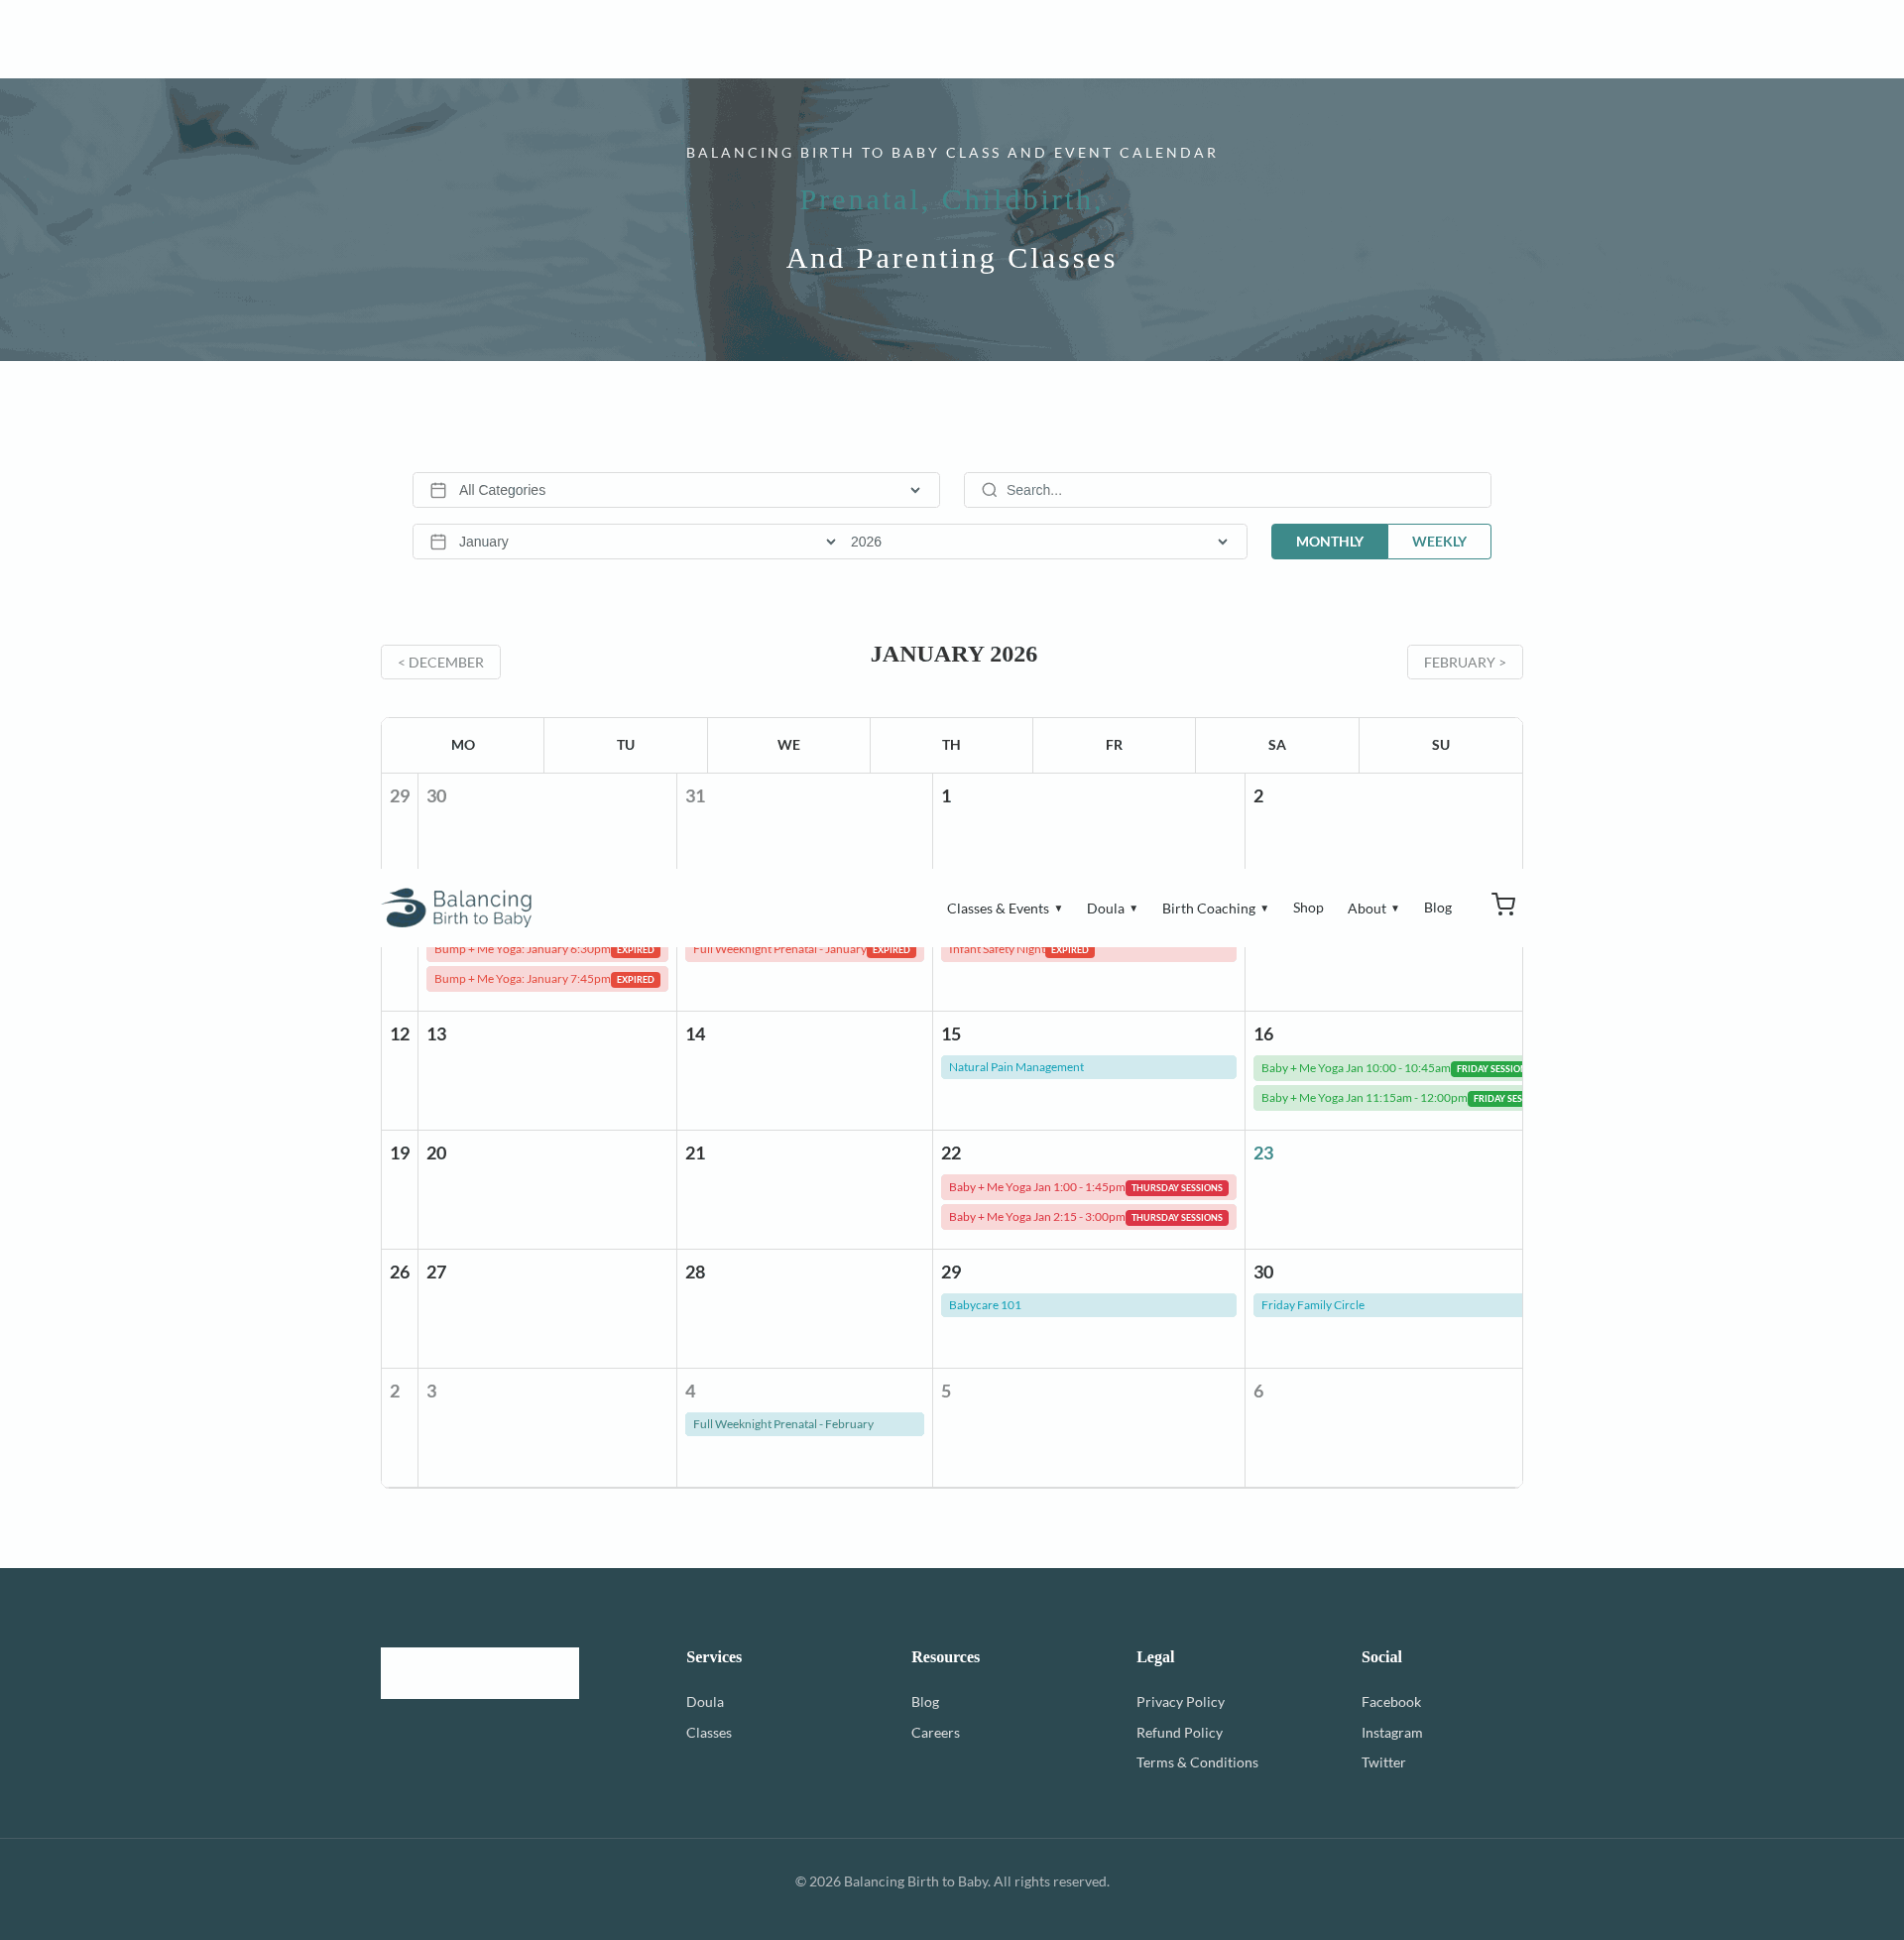
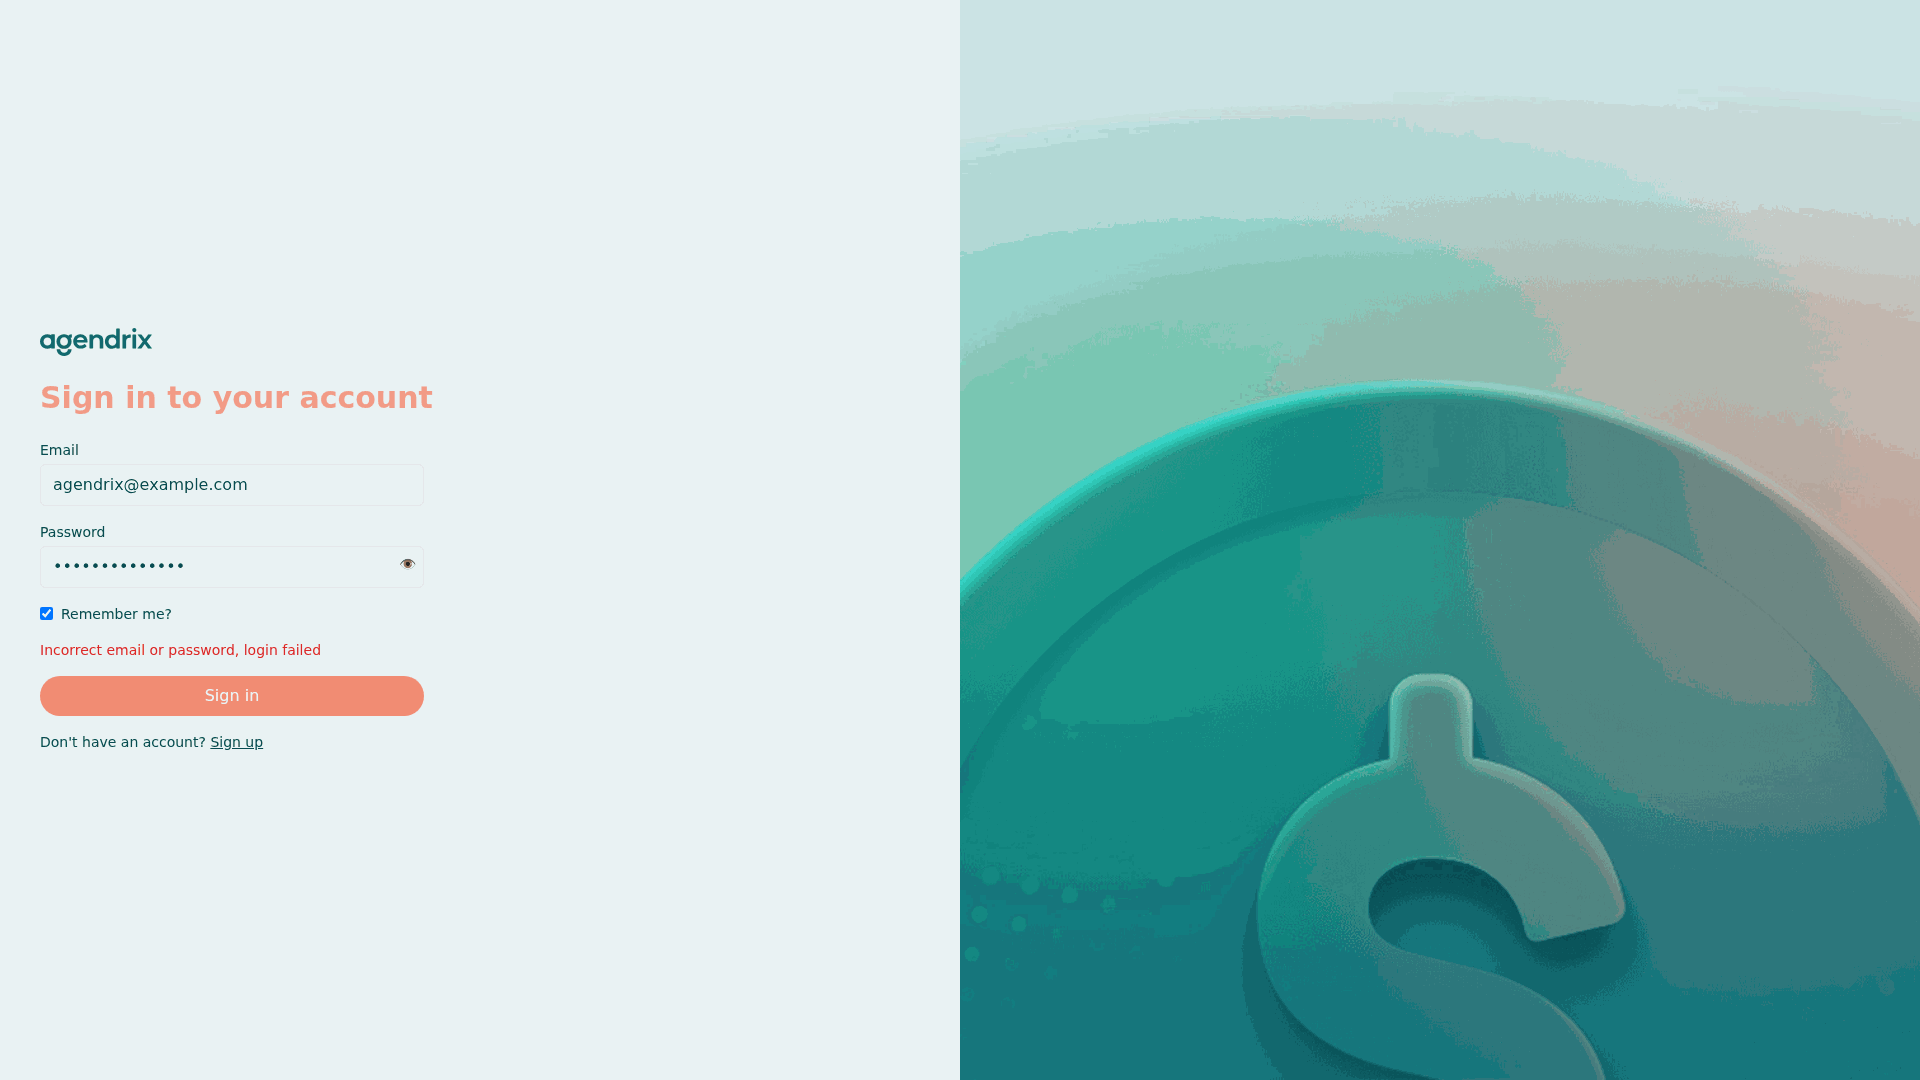
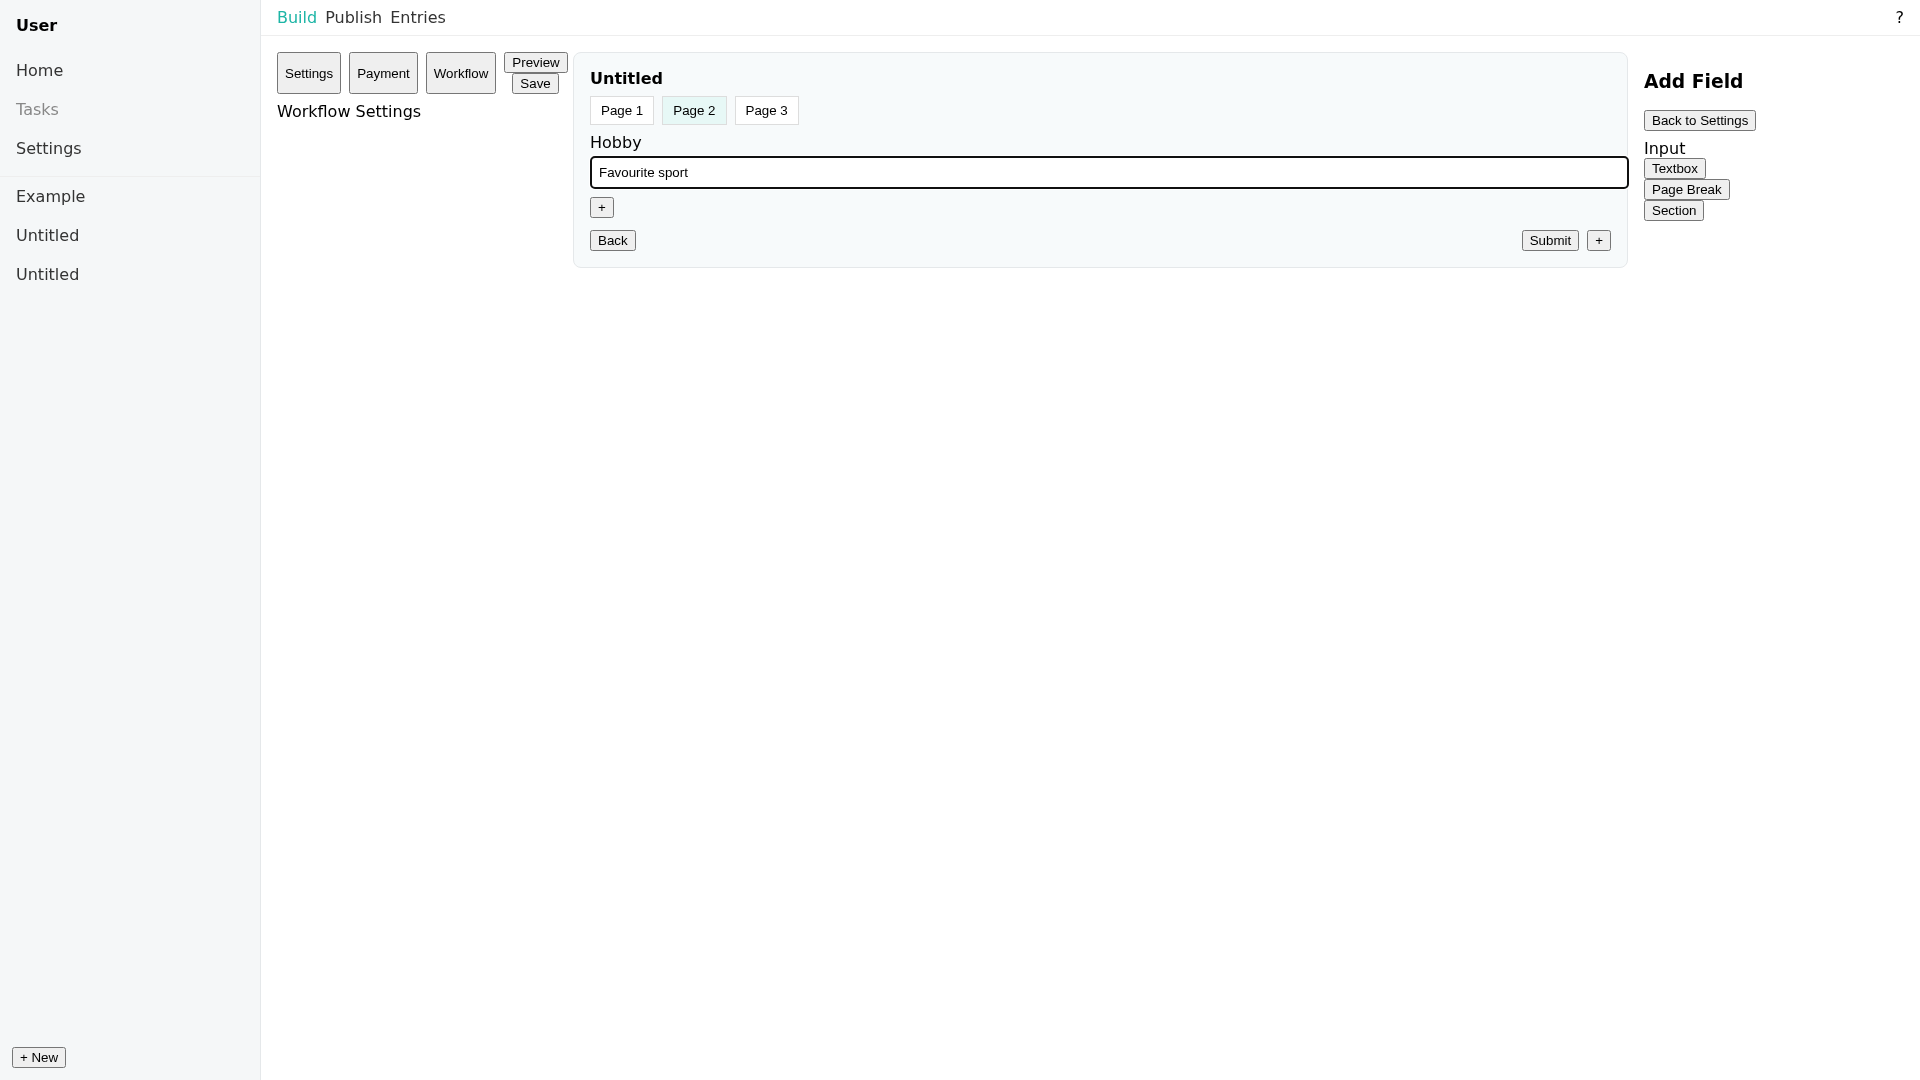
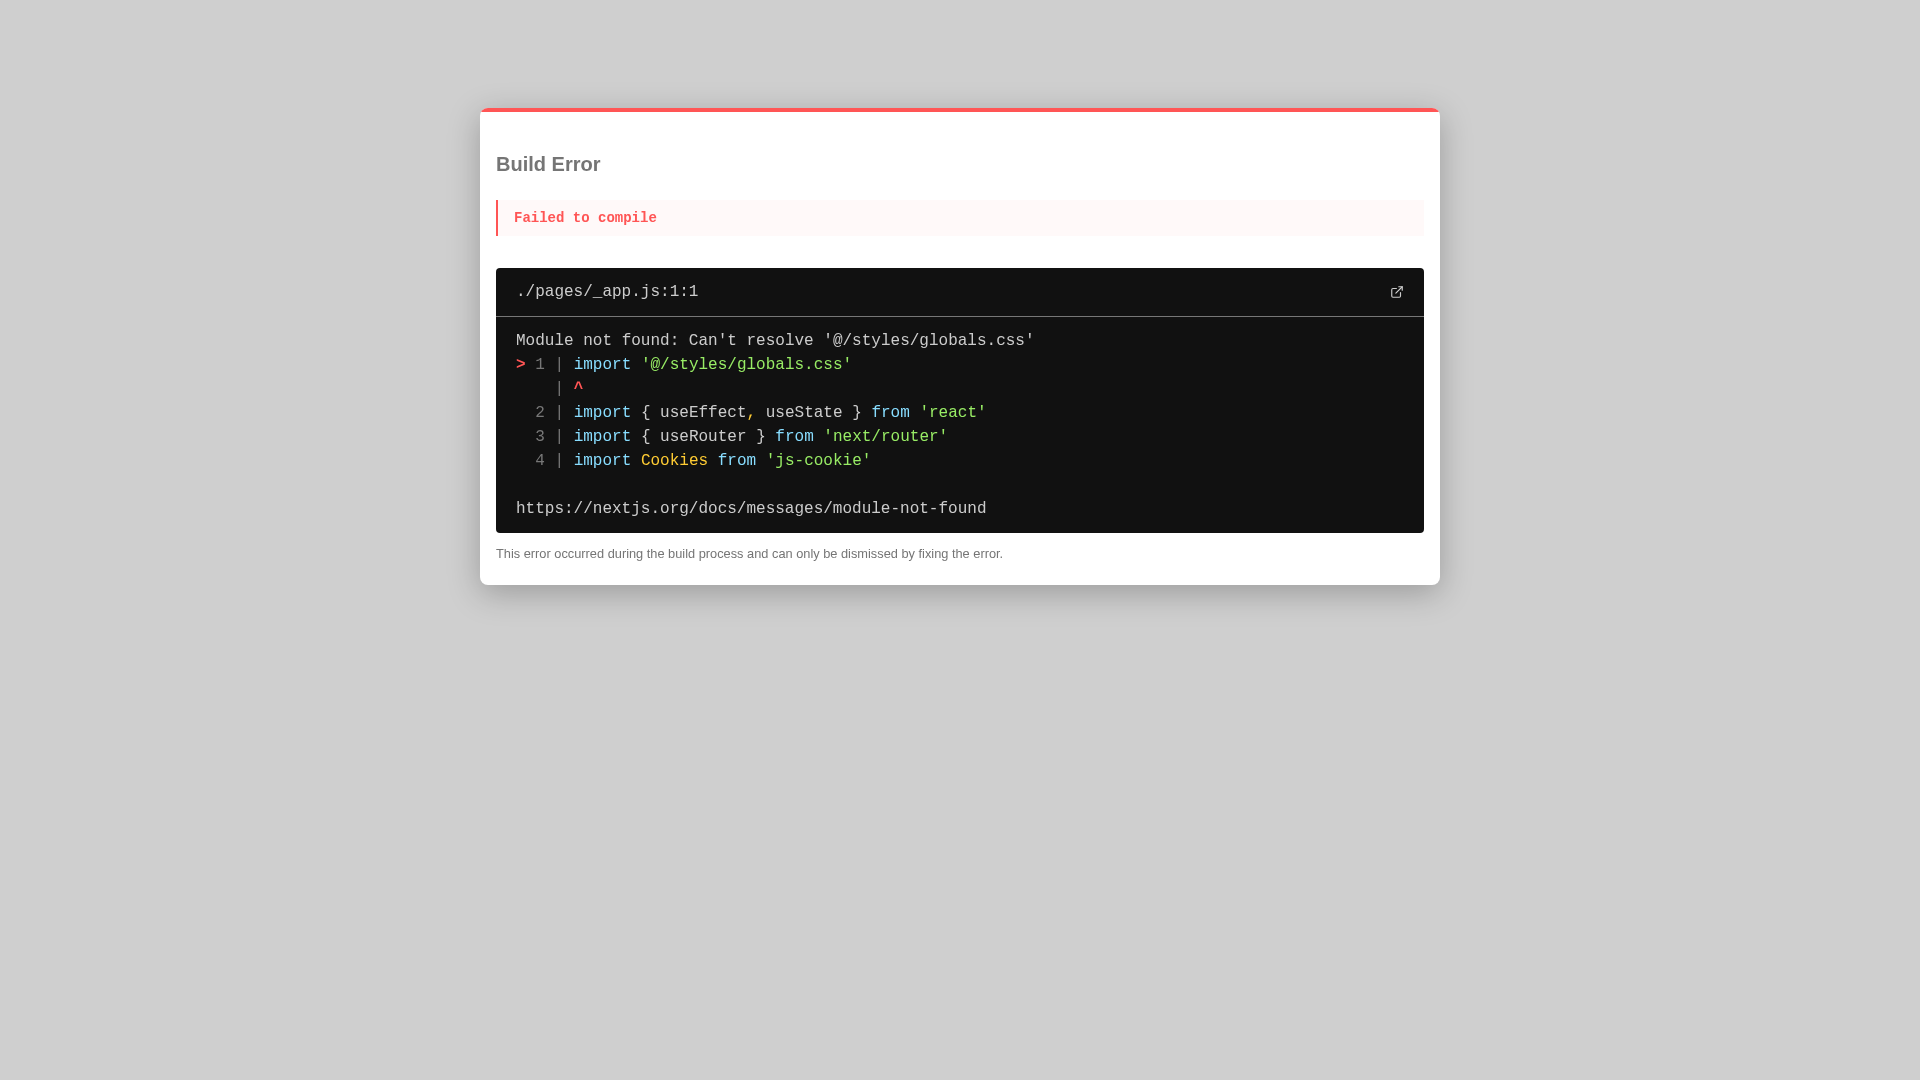
这些是定性展示,不能从截图单独判断数据库持久化或 API 是否正确;相应系统性结论来自作者的综合错误分析。
论文 v3 新增/展开了人类一致性与 backbone 敏感性验证。它们回答的是“评测结果有多可信”,不是“网页开发任务有多容易”。[1, §4.4]
从 64 个任务抽样约 100 条工作流,人工独立审核 250 个节点;其中 218 个与验证器判定一致,32 个不一致。
100 张随机原型上,VLM 与人工的平均 Spearman ρ 为 0.66,中位数 0.80;人工之间为 0.78。
GLM-4.6V 与 GPT-5-Mini 验证器的总体 FS 分别 31.36 与 31.67;所测系统排序一致。
| 证据 | 支持 | 不能推出 |
|---|---|---|
| 218/250 一致 | 抽样节点上,多数判定与人工一致 | 所有任务 87.2% 正确;FS 有固定 ±12.8% 误差;假阳性与假阴性相同 |
| Spearman 均值 0.66 | 排序与人类具有一定一致性 | 绝对分数校准无偏;66% 的页面被判对 |
| 四个视觉 Judge 排序相同 | 所测四个系统的相对名次较稳 | 任意新模型、任何接近分数都同样稳定 |
| 两种 GUI 验证器整体差 0.31 | 这一系统集合的平均结果较接近 | 每个节点判定一致,或所有误判都可忽略 |
| Tested Model | GLM-4.6V FS | GPT-5-Mini FS |
|---|---|---|
| Claude-Sonnet-4.6 | 48.6 | 46.6 |
| GPT-5.4 | 28.6 | 29.3 |
| Gemini-3.1-Pro-Preview | 17.0 | 19.1 |
| Overall | 31.36 | 31.67 |
三项模型的差异分别为 −2.0、+0.7、+2.1 分(GPT-5-Mini 相对 GLM-4.6V,本页复算)。总体均值接近可能掩盖子项差异。Table 6 使用 Sonnet-4.6、GPT-5.4、Gemini-3.1-Pro-Preview,不是 Table 3 的同一模型版本集合。
视觉敏感性分析复评 153 个项目的 567 张原型,用 Gemini-3.1-Pro-Preview、Doubao-Seed-2.0-Pro、GLM-4.6V 与 GPT-5.4 四个 Judge,得到一致排序:Sonnet-4.6 → GPT-5.4 → Kimi-K2.5 → Gemini-3.1-Pro-Preview。原文同时明确绝对分数标尺因 Judge 而变。
仍缺少节点级混淆矩阵、不同任务层级的误判率、重复运行方差与近邻排名的置信区间。250 个节点来自约 100 条工作流与 64 个任务,存在聚类相关,不能简单当作 250 次完全独立伯努利试验。作者认为误判会随 GUI 模型变强而减少,这是合理预期,不是已验证结果。
论文比较了模型、框架与验证器 backbone,但未提供充分的“无 workflow vs 有 workflow”“去掉 guided actions”“无历史”“去掉专家质检”“不同工作流拆分长度”的受控对照。因此评测器达到一定一致性的证据较明确,而结构化工作流究竟贡献了多少稳定性尚无法单独量化。
本文不是需要重新训练的模型。要复现主表,需要固定数据、生成 Agent、模型版本、容器、推理预算、启动协议、验证器与聚合脚本。只使用同名模型不足以重现实验。
| 设置 | 论文明确给出 | 复现边界 / 尚需核实 |
|---|---|---|
| 模型与框架 | 8 模型;Claude Code 与 OpenHands | API 精确快照、框架版本及供应端行为漂移 |
| 运行环境 | Ubuntu 22.04、Node.js 20.x、Python 3.12;数据库客户端与常见开发工具 | 客户端不等于已启动数据库服务;完整环境须按实际镜像确认 |
| SDK / 工具 | 附录列 claude_agent_sdk==0.1.18、openhands、Playwright/Chromium;基础终端与文件读写;无 MCP 额外编排层 | 部分依赖未精确锁定;不要用增强工具配置替代论文条件 |
| 部署 | /workspace/start.sh;localhost:3000;部署超 10 分钟或错误判失败;最多三轮迭代 | 需区分生成重试与部署修复;不能擅自解释成 best-of-3 oracle 选优 |
| GUI Verifier | GLM-4.6V;WebVoyager 协议;受控动作与验证 | 公开简化模板未给出全部底层细节 |
| 视觉 Judge | Gemini-3-Pro-Preview;组件五档评分 | 组件切分、采样随机性与模型端图像处理可能影响分数 |
| 推理采样 | 论文未统一充分列明 temperature、top-p、token 预算等 | 不要把当前仓库默认值回填成论文原始值 |
| 训练与成本 | 无本文专用训练;使用已有模型 | 正文/附录未完整量化每任务 token、总费用、时长分布与重复采样成本 |
原文 prompt 把截图称为“provided above, not from files”;任务定义又同时讨论工作目录中的输入材料。复现时应保留具体 adapter 的图像注入方式,而非仅把路径字符串交给一个不支持图像的模型。附录展示的是结构化简化模板,并非承诺所有原始请求参数已完整公开。
以下来自论文 Appendix A.2.2 / A.3.1,作者明确表示部分细节简化。CC BY 4.0;换行经整理。中文解读见上文;这不是本页替作者补写的 prompt。
Structure of GUI Agent Verifier Prompt
You are aGUI Testing Agent.
Your primary task is toexecute software test cases on a Web applicationby interacting with the graphical user
interface and determining whether the test casepasses or failsbased on defined validation criteria.
The current time is{time}.
Context:
{context}
Test Case
Objective
{objective}
Actions
{actions}
Validations
{validations}
Test Platform
Web
Action Space
The agent operates in a predefined GUI action space (Click, Type, Scroll, Wait, GoBack, Refresh, Key, Answer),
following standard web interaction semantics.
History
You havealready performed the following actions(format: Thought, Action):
{history}
Output Format
Your reply should strictly follow the format:
• Thought: Your brief thoughts
• Action: One Action format you choose
Current Observation
Full-page screenshot:{fullpage screenshot}
Current viewport screenshot:{viewport screenshot}
Structure of VLM Judge Prompt
You are asenior QA automation engineer. Your task is tocompare a prototype image with an actual page
screenshotand score the appearance of the page.
Important:Carefully observeall differencesbetween the prototype and the actual page. Do not overlook any
discrepancies, however small. Score strictly according to the rules below.
Input
1.Prototype Image:{prototype page}
2.Actual Page Image:{actual page}
Note:You need to automatically segment the page into meaningful UI components based on visual and functional
layout.
Component Segmentation Rules
• Divide the page intological functional blocks, not too granular or too coarse.
• For each block, treat it as asingle componentfor scoring purposes.
Scoring Rules
Each component or block receives an independent score:
Score Description
1.0 Perfect Match:Component position exactly matches the prototype. Layout, spacing, alignment,
and sizing are identical. Text, fonts, colors, icons, and images are fully accurate. No visually
discernible differences.
0.75 Minor Imperfections:Mostly accurate positioning with very slight misalignment (<2 px). Layout
and spacing largely consistent. Only minor typos or formatting differences. Multimedia shows
slight scaling or color variation.
0.5 Partial Match:Roughly correct position but noticeable misalignment or spacing issues. Layout
partially consistent. Multiple text discrepancies. Multimedia partially incorrect or inconsistent.
0.25 Poor Match:Component recognizable but significantly misaligned. Layout mostly inconsistent.
Text differs significantly. Multimedia missing or incorrect.
0.0 No Match:Component missing or completely misplaced. Layout unrelated to prototype. Text and
multimedia absent or entirely incorrect.
Output Requirements
Outputonlya JSON object in the following structure:
[
{
"name": "<component name>",
"score": <0 | 0.25 | 0.5 | 0.75 | 1>,
"reason": "<brief explanation of why this score was given>"
}
]Structure of Full-Stack Task Prompt You are asenior full-stack engineer with expertise in web development. Your task is toimplement and deploy a production-ready web applicationstrictly following the provided materials in/workspace. I. Input Materials 1. Product Requirement Document( /workspace/prd.md): Contains overview, business logic, and detailed requirements. 2.Prototype Images(provided above, not from files): Define UI layout, style, interactions, and visual fidelity. 3.Resource Files(/workspace/resources/ **/*): Assets including images, videos, audio, icons, etc. II. Mandatory Full-Stack Workflow 1.Planning & Design • Define database schema and seed data. • Specify front-end/back-end architecture and tech stack. • Design project directory structure. 2.Seed Data Generation • Generate complete realistic seed data reflecting prototypes. • Populate all UI elements and states (loading, empty, error). 3.Full-Stack Implementation •Back-End:APIs, validation, authentication, database initialization. •Front-End:Replicate visuals, implement all interactions, consume live APIs. •Integration:Ensure front-end and back-end work seamlessly. 4.Deployment & Verification • Build application and verify accessibility athttp://localhost:3000. • Generate/workspace/start.shfor fully reproducible deployment. • Verify startup script in a clean environment. 5.Documentation • Design document: architecture, data model, technology stack. • README: overview, stack, directory, deployment instructions. III. Required Deliverables • Complete source code • Design document • Seed data • Deployment script (start.sh) • README IV . Hard Constraints • Implement all PRD features without skipping or inventing functionality. • All visuals and interactions must match prototypes. • System must be fully reproducible viabash /workspace/start.sh. • Do not terminate the work process until all steps and startup verification are complete.
固定 dataset revision、全部任务清单、资源哈希与 workflow;记录被过滤/缺失任务,不悄悄从分母剔除。
给定规定的图像与文本输入,保存模型/框架版本、提示、预算、完整工具日志与最终源代码;禁止把评测用例作为额外 oracle。
清洁环境执行 start.sh,记录是否成功、时间、端口与错误;保留每次修复历史,明确三轮如何使用。
固定分辨率与会话策略;逐节点保存动作、观察、Pass/Fail/Blocked 与截图;记录哪些失败源于前置条件。
保存每张实际截图、原型、Judge prompt、组件 JSON;按原型和功能节点池化,并报告 DSR、VS、FS、层级 Avg。
抽样人工重评并保留节点混淆矩阵;重复运行测方差;改变 Judge 时重评同一输出,避免生成能力与评分变化混在一起。
上面是根据论文与实现整理的复现实务建议,不表示本页已经执行 193 个任务或独立复现了论文分数。
核查时间 2026-09-18;官方 commit SHA:577f9397b3db8fc6d828adde254a830caa65d515。本页只做代码阅读,没有运行完整 benchmark。以下区别均绑定此快照。
| 项目 | 论文 v3 的实验描述 | 当前官方实现 / 影响 |
|---|---|---|
| 功能验证 | GLM-4.6V + WebVoyager GUI 协议 | functional_tester.py 使用 Claude Code + playwright-cli;默认 functional_model 是 Sonnet-4.5 的日期化 ID。复现主表不能直接沿用当前默认配置。 |
| 观察与操作 | 截图、GUI 动作与 Thought/Action | 当前 prompt 使用浏览器 snapshot 与元素引用,允许读 DOM/属性/URL/localStorage,及 localhost 业务 API 的 curl。评测可见信息与动作机制不同。 |
| 测试约束 | guided actions 保持受控交互 | 当前 prompt 禁止读项目源码、注入自定义 JS、状态直接修改和测试自修复;单步等待不超过 3 秒,失败继续后续节点、同流不重置状态。这是 prompt 约束,不应假定全部是强制沙盒防护。 |
| 推理框架 | Claude Code、OpenHands 两种 | 仓库新增 Codex adapter;官方 2026-06-15 公告说明更新,不对应原主表的第三组框架。 |
| 预算默认值 | 主文强调三轮迭代与 10 分钟部署上限 | 当前 InferenceConfig 默认 timeout=7200 秒,max_retries=2。运行总尝试数最多 3,不据此推断论文原始全部任务预算。 |
| FS 分母 | 通过功能节点的比例 | 只计 workflow 中 validations 非空节点;多条断言仍对应一项;默认零,缺失结果不计通过。 |
| 失败部署 | 超时或错误视作失败 | analyzer 检查 evaluation_result.json 的 status 是否为 success;不能因文件存在就当成功。 |
| 线上榜单 | 固定实验结果 | 官网按 season 更新,维护者使用对应 Judge/GUI Agent 评测。不同季节的绝对分数不能直接当成模型进步幅度。 |
功能执行器 ↗ · 当前评测提示 ↗ · 默认配置 ↗ · 聚合逻辑 ↗
分析器用结果字符串是否包含 Pass 判定通过,而不是严格枚举值校验。规范输出 Pass/Fail/Blocked 时可正常工作;若出现非规范字符串则可能误读。这是静态代码观察到的潜在风险,没有证据说明论文已发表结果因此错误。复现实务中应先检查原始结果 schema,再聚合。
许可也存在表述差异:官方项目主页写 CC BY-SA 4.0,HF 数据卡写 CC-BY-NC-SA-4.0,arXiv 论文为 CC BY 4.0。论文插图在本页附来源;若复用完整数据集,应按对应 artifact 的实际许可核实,不能只看主页一句话。
视觉、行为、部署同时进入评测,能暴露只测静态图或函数正确率看不到的问题。三层设计给出易于理解的能力剖面;真实资源库使素材选择成为任务的一部分。
O/A/V 结构和明确目标状态比自由打分更容易审核。功能与视觉分开报告,能区分页面好看但功能失败、或功能正常但复刻粗糙。
人类复核、跨 Judge 和跨 GUI backbone 比较,比默认相信 LLM 裁判可靠更有说服力;论文也披露了作者与 GLM 验证器开发方的关系。
不同层级的数据、图片、文字、节点数量同时变化。要证明某个层级单独测某种能力,需要同任务受控版本和明确消融。
前端本地模拟可在部分流程呈现正确结果;除非检查跨会话/刷新/服务重启后的持久化等条件,无法保证真实后端质量。安全性、性能、并发、可访问性和维护性也不是两项分数的充分覆盖对象。
87.2% 一致并非无误,VLM 的块划分会影响等权平均;小样本子类、缺失成本数据与季度裁判漂移限制绝对分数的解释。
| Research Extension | 实验设计 | 检验什么 |
|---|---|---|
| 受控的层级任务对 | 同一网站固定素材与原型,依次增加交互、持久化与后端要求 | 新增复杂度的边际影响,减少不同数据分布混杂 |
| 工作流结构消融 | 同一生成输出,比较自由测试、仅目标、O/A/V、O/A/V+历史;多随机种子与人工真值 | 动作约束和历史究竟带来多少准确性、成本与方差变化 |
| 状态隔离与因果归因 | 每流固定数据库快照;另设完整端到端链;区分失败、前置阻塞、验证器失败 | 减少一个入口坏掉导致整站被错误归因 |
| 多会话持久化验证 | 新会话重访、账号切换、刷新或服务重启后核查数据,配少量后端契约检查 | 页面级假成功与真正系统实现的差异 |
| 固定视觉分区 + 多裁判校准 | 对参考图制定区域;同时比较等权/面积/业务重要度权重与人类排序 | 块切分自由度造成的分数波动 |
| 成本—正确率联合报告 | 等预算、固定时间/token;报告 VS/FS/DSR、费用及重复运行方差 | 改进来自更强推理还是更多执行机会 |
Research Extension · 未由本文验证可以借鉴其“外观 + 执行 + 状态”的分层思路:L1 测参考纹理的渲染复刻;L2 测可编辑节点图及参数变化的一致性;L3 测真实 SBS 编译、多通道输出、资源可携带性与独立重建。将“图能打开”“可编译”“渲染像参考”“参数编辑仍成立”分开评分,避免漂亮预览掩盖执行失败。
工作流可设计为:导入图 → 检查节点/依赖 → 实际 cook → 多通道渲染 → 修改参数 → 再渲染 → 验证预期变化。GUI/VLM 可帮助观察,但结构合法性、依赖完整性、像素指标与编译日志应尽可能使用确定性检查。此处是本页的研究设想,不是 Vision2Web 已开展的材质实验。
阅读基准:2026-09-18。论文身份、主结果、附录实例与官方实现分别核查;本页没有运行论文 benchmark,也没有独立复现作者的人工一致性实验。原图、样式、脚本与 MathJax 3 均嵌入单文件,正文与公式可离线阅读;外部来源链接需要联网。
\(I^{\ast}\) · \(z^{\ast}_{\mathrm{img}}\) · \(z^{\mathrm{img}}_{1:I}\) · \(z_{\lt t}\) · \(P_{\theta}(\mathbf{z}\mid\mathbf{x})\) · \(\beta_1=0.9,\ \beta_2=0.95\)
这些公式仅遵循本项目的排版测试规范,不是 Vision2Web 使用的模型或损失。