CLIP 图像语义与相机变化一起进入 cross-attention;输入图的 latent 另经通道拼接保留身份与细节。
01 · 从一张图“换视角”,再得到三维
Zero-1-to-3 的第一产物是一张新视角图像,而不是 mesh。它先把二维扩散模型改成“图像 + 相对相机”条件的生成器,再把该模型作为三维优化的指导信号。
Objaverse 多视角渲染用于有监督微调;zero-shot 指在未见测试对象/数据集上应用,不是无需训练或不使用三维数据。
作者在 RTX A6000 报告一次新视角约 2 秒、完整三维重建约 30 分钟。两条工作流不能混成“2 秒生成可用三维资产”。
Paper Verified:GSO 新视角 PSNR 18.378、LPIPS 0.088;三维 Chamfer Distance 0.0717、IoU 0.5052。复杂 RTMV 场景明显更难,IoU 仅 0.2196。对比结果体现的是所列协议和基线,并非任意真实场景的可靠重建。v1 Table 1–4
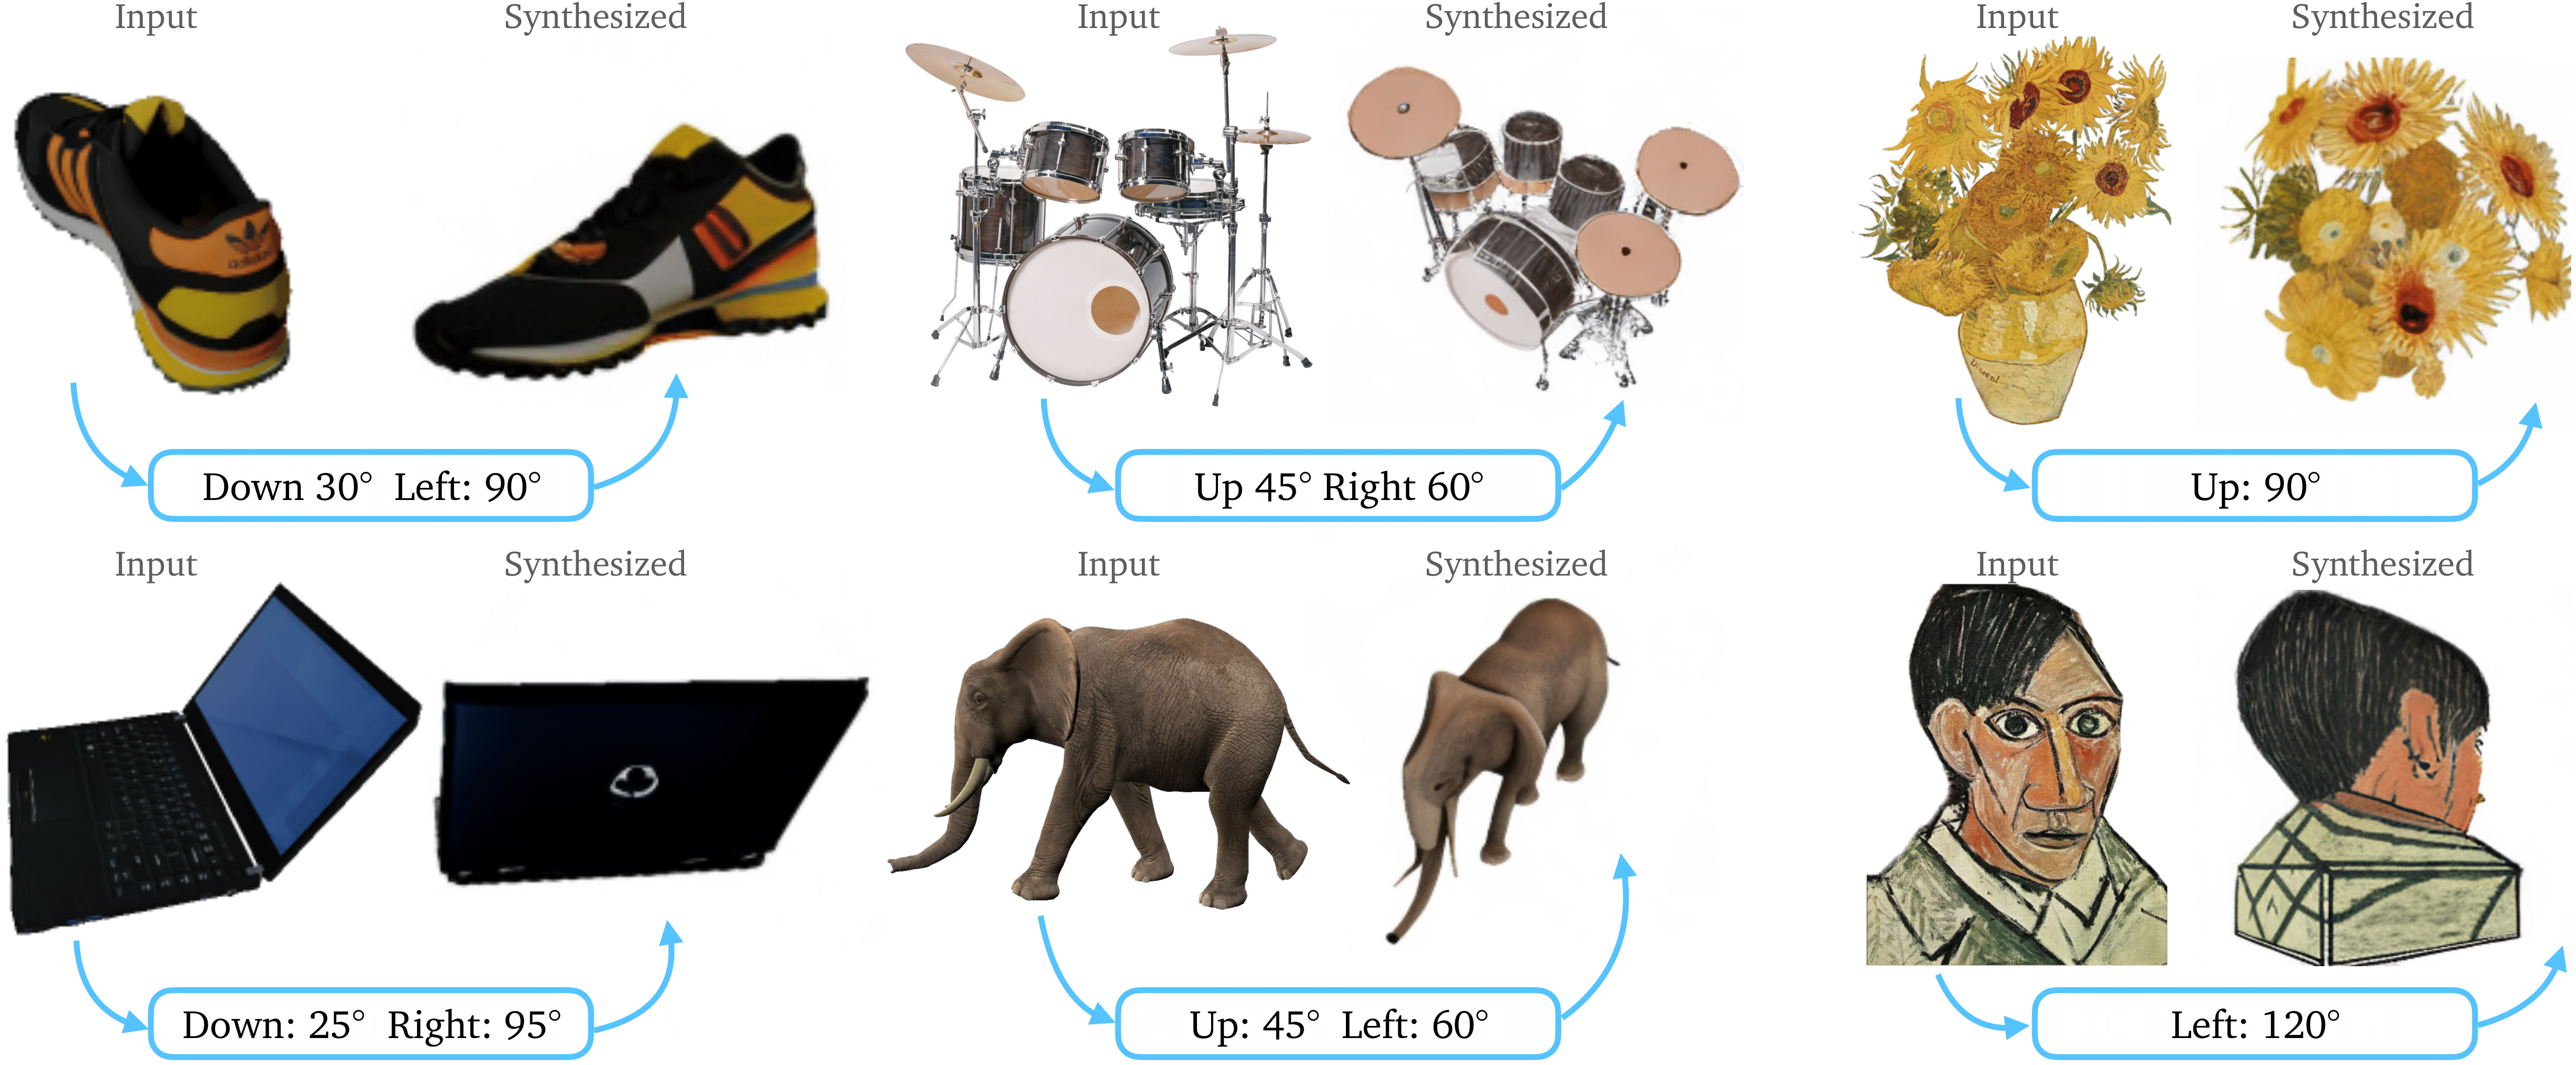
02 · 身份与版本:终稿多了一张关键消融表
论文标题 Zero-1-to-3: Zero-shot One Image to 3D Object,作者顺序 Ruoshi Liu、Rundi Wu、Basile Van Hoorick、Pavel Tokmakov、Sergey Zakharov、Carl Vondrick。前三位及末位来自 Columbia University,Pavel Tokmakov 与 Sergey Zakharov 来自 Toyota Research Institute。第一作者 Ruoshi Liu;所核对 PDF/项目记录未见明确通讯标记,Carl Vondrick 仅按末位作者规则列为 unverified 候选。
正式发表于 ICCV 2023,pp.9298–9309。固定 arXiv 2303.11328v1(2023-03-20)为 13 页:论文内容 1–9、参考文献跨 9–11、Appendix A–E 在 12–13。ICCV 正文 PDF 为 12 页,另有 2 页补充 PDF;不是将 13 页原版误记为补充。会议页面提供 ZIP,内部唯一正文 PDF 为 zero123_appendix.pdf,资源分叉文件不算第二份论文。
版本差异:v1 有四张定量表;ICCV 增加训练数据规模/从零训练对照为 Table 3,旧三维结果 Table 3/4 变成 Table 4/5,其数字保持一致。v1 Appendix Fig.11 在会议独立 supplement 中编号 Fig.1。本文完整读 v1、会议终稿及该补充,分别标注,避免只读旧版而错误声称没有消融。CVF 正式记录
官方仓库后来包含多个 checkpoint、Zero123-XL、社区 SDS/Instant-NGP 路径与优化 demo。后续发布不等于原文模型,不能把 XL 的数据规模、权重或社区效果当作 v1 实验。所有用户原 note、图片链接、引用与 block anchors 保持原字节前缀不变。
03 · 研究缺口:语义先验并不自动变成相机控制
单视图看不到背面,一个对象可以有无数与输入兼容的三维解释。仅凭几何正则或类别模板容易限制泛化;逐对象训练 NeRF 又通常依赖多张已知位姿图。大规模二维扩散模型拥有丰富外观与物体知识,但没有显式学习“同一物体从 A 看向 B”的对应关系,而且互联网图像偏向 canonical pose。

Fig.2 的椅子示例显示文本生成器倾向前向展示;它是现象展示,不是数据集视角偏置的完整统计。作者核心假设是:二维预训练已经包含足够广泛的形状/外观先验,只要用合成成对图教会一个可控的相机接口,就能把先验迁移到真实、艺术风格与未见对象。
Our Interpretation:这不是从一个冻结模型中读出确定的三维数据库,而是微调新的条件分布。目标是生成合理的新视角,不是证明不可见部分的唯一真实形状。训练数据的三维知识和二维预训练共同作用,会议新增 scratch 消融才为预训练价值提供更直接的证据。
04 · 问题形式化与相机坐标约定
\[\widehat x_{R,T}=f_{\theta}(x_{\mathrm{src}},R,T;\xi),\qquad \xi\sim\mathcal N(0,I).\]
论文 Eq.(1) 把输入图 \(x\)、相对旋转 \(R\in\mathbb R^{3\times3}\)、平移 \(T\in\mathbb R^3\) 映射为新视角 RGB;此处显式补出随机种子 \(\xi\) 以强调生成多解性。输出单图本身不保证与其他独立生成的新视角严格三维一致。
实现采用始终看向物体中心的球面相机,不是把任意 6DoF 矩阵直接输入网络。对象归一化进 \([-0.5,0.5]^3\),极角从 +Z 向下,方位角绕 Z,半径是相机距原点距离。相机遵循 pinhole model,水平视场角 49.1°,训练半径 r 在 [1.5,2.2]。
\[\Delta\vartheta=\vartheta_{\mathrm{tgt}}-\vartheta_{\mathrm{src}},\quad
\Delta\varphi=\varphi_{\mathrm{tgt}}-\varphi_{\mathrm{src}},\quad
\Delta r=r_{\mathrm{tgt}}-r_{\mathrm{src}},\qquad
v_{\mathrm{pose}}=[\Delta\vartheta,\sin\Delta\varphi,\cos\Delta\varphi,\Delta r].\]
正余弦消除方位角 0 与 2π 的不连续,网络接受 4 维变化向量。r 项是归一化空间里的相对径向位移,不是像素 zoom 值。把 elevation 从水平面起算与 polar angle 从顶端起算混用会颠倒方向;demo 的角度滑块先转弧度,训练代码则从外参恢复相机位置 \(C=-R^{\mathsf T}T\)。

Appendix A 称角度覆盖单位球面;数学上分别均匀采样极角与方位角不等于等面积均匀采样球面。正文范围不够确定实际密度,应检查渲染脚本,不擅自把文字描述升级为精确采样算法。目标始终看原点、固定内参和归一化尺度也意味着该接口不直接覆盖任意真实相机内参、roll 与复杂非中心场景。
05 · 两条条件支路与去噪训练

\[e_{\mathrm{img}}=\operatorname{CLIP}_{\mathrm{image}}(x_{\mathrm{src}})\in\mathbb R^{768},\qquad
c=W[e_{\mathrm{img}};v_{\mathrm{pose}}]+b\in\mathbb R^{768},\quad W\in\mathbb R^{768\times772}.\]
第一支路将 768 维图像 embedding 和 4 维 pose 拼为 772 维,再投影回 768,通过 U-Net cross-attention 提供高层语义与相机变化。它替换原文本条件,不需要每个物体附加文本 caption。投影层学习率为其他网络的 10 倍;不是给全部 Stable Diffusion 参数统一加速十倍。
\[z_0=\mathcal E(x_{\mathrm{tgt}}),\quad
z_t=\alpha_t z_0+\sigma_t\epsilon,\quad
z_{\mathrm{cond}}=\mathcal E(x_{\mathrm{src}}),\quad
\mathcal L_{\mathrm{denoise}}=
\mathbb E_{x_{\mathrm{src}},x_{\mathrm{tgt}},t,\epsilon}
\left\|\epsilon-\epsilon_{\theta}([z_t;z_{\mathrm{cond}}],t,c)\right\|_2^2.\]
第二支路把输入图 latent 与带噪目标视角 latent 做通道拼接。256² 图经 VAE 得 4×32×32,合并为 8×32×32,U-Net 输出 4 通道噪声。本文为了消除源/目标歧义改写 Eq.(2):原文写 z∼E(x) 并复用 x 表示输入,容易误以为训练重建 source;官方配置明确 first_stage_key=image_target、cond_stage_key=image_cond,证实监督的是 target。
t 来自 1000 个扩散训练时间步;这不等于生成一图必须运行 1000 次去噪。训练参数是扩散 U-Net 与新投影;VAE 和图像编码器承担编码,公开配置冻结 cond stage。预训练起点为 Lambda Labs 的 image-conditioned Stable Diffusion,而非从文本 SD 临时只替换一个向量,也不是 SDXL、ControlNet 或多视角 attention 架构。
为了使用 classifier-free guidance,训练随机丢条件。公开 get_input 中 uncond 默认 0.05,构造单独丢 image embedding、单独丢 concat latent、两者同时丢三种区间;pose 仍被拼入投影,不能仅按注释就断言所有分支的完整 posed embedding 永远清零。生成时按条件/无条件预测放大,普通图像生成与三维蒸馏所用 guidance 强度不同。
06 · 数据渲染、训练预算与发布配置
Paper Verified:Objaverse 800K+ 物体、100K+ 艺术家;每物体渲染 12 个相机视角,约 10M 图像。Blender Cycles、每 ray 128 samples、denoise、随机 area lighting、512² 渲染,透明背景填白。训练时从同一物体选两张得到源、目标及相对相机,不需要手工标注真实照片位姿。
| 项目 | 论文报告 | 实现补充与限制 |
|---|---|---|
| 优化器 / LR | AdamW,基础 \(10^{-4}\);投影层 10× | 论文未给 β、weight decay、完整 scheduler;不能拿库默认值当已报告设置 |
| 分辨率 / batch | 先试 512² / 192,后采用 256² / 1536,latent 32² | 同时变分辨率与 batch,稳定性解释不能纯归因于 batch |
| 算力 | 8×A100-80GB,7 天 | 算术上约 1,344 GPU 小时,不等于后来 300K checkpoint 的约 6,000 A100 小时 |
| 公开 YAML | base LR 1e-4,hybrid,U-Net 8→4 通道 | 每设备 batch 192×8 与有效 1536 对齐;grad accumulation=1,image size 256 |
| 代码采样 | 论文每资产 12 渲染图 | 当前示例 total_view=4,只从配置前四视图采 pair;不是“论文只渲染四图” |
| 数据划分 | 主文未给精确 train/val 清单 | 公开 loader 对 valid_paths 的前 99% 训练、后 1% 验证;顺序与版本影响实际划分 |
| 发布 warmup | 论文未明确 | YAML 实际 warm_up_steps=100,注释却写 10000;应按生效字段并注明版本 |
论文声称测试图像/数据集不在 Objaverse,依据作者向数据集作者核实;这支持合成微调集外测试,不是对 SD 互联网预训练数据做了完备去重证明。无类别标签的数据集也不自动意味着严格类别互斥测试。准确训练/评测样本清单、每个场景视角与 filtering 应额外发布以支持重复实验。
07 · 新视角生成:输入预处理与控制
- 将物体前景从真实图像中分离并置于白底,统一模型尺寸。背景删除是实际流程的一部分,输出质量不能完全归因于扩散网络。
- 指定相对 polar/azimuth/radius 变化,计算 posed CLIP embedding,编码 source latent。
- 从随机 latent 噪声开始,用带双条件的 U-Net 迭代去噪,再经 VAE 解码到目标视角 RGB。
- 需要多个可选背面时换 seed;需要多个视角时分别指定 pose。没有跨视角显式一致性硬约束或同一次联合多视角采样。
公开 demo main_run 默认 DDIM 50 步、eta=1.0、CFG scale=3.0、4 个样本。这些是当前发布 demo 默认,不应反推全部论文 quantitative runs 也完全如此。模型以相对视角为输入并不免除三维重建所需的输入相机方位估计;README 明确建议提供输入 elevation,当前从 transforms_train.json 的外参硬编码读取。


Fig.7 为作者声称未经挑选的五个随机视角;Fig.8 固定目标相机而换噪声种子,显示不可见几何与外观的多样性。合理的多解不应全部按像素 GT 判为同一种错误,但多样性也不保证每个样本物理可行。它们是定性证据,未给跨种子概率校准、失败率或 identity consistency 的独立定量表。
08 · SJC 是什么:把二维分数传回三维参数
回应原笔记中的 SJC 问题:Score Jacobian Chaining 的核心不是先生成一圈图再做传统多视图重建,而是“当前三维场渲染 → 扩散模型给图像方向 → 经渲染 Jacobian 更新三维参数”。Zero-1-to-3 将指导分布从文本换成 source 图像与相对相机条件,缓解无视角控制先验的 canonical-pose 偏差。

\[x_{\pi}=\mathcal R(\omega,\pi),\qquad
g_{\omega}\propto
\left(\frac{\partial x_{\pi}}{\partial\omega}\right)^{\mathsf T}
s_{\mathrm{PAAS}}(x_{\pi}\mid x_{\mathrm{src}},\Delta\pi).\]
上式为解释性的链式传播结构:\(\omega\) 是 VoxelRF 参数、\(\pi\) 为采样相机、R 是可微体渲染。PAAS 是 SJC 的 perturb-and-average scoring;对渲染图添加噪声、用条件 denoiser 估计方向,处理渲染分布与扩散训练噪声分布的差异。论文 Eq.(3) 给出 PAAS score 的简记,并把推导交给 SJC;这里不把它伪装成已完整写出的标准 SDS loss,也不直接反传整个去噪采样链。
\[\mathcal L_{\mathrm{anchor}}=\|\mathcal R(\omega,\pi_{\mathrm{src}})-x_{\mathrm{src}}\|_2^2,\qquad
\mathcal L_{\mathrm{total}}\ \text{包含分数指导、输入视图监督、深度平滑、近邻视图一致性}.\]
anchor 确保已知源视角,深度平滑利用几何通常比纹理低频的先验,near-view consistency 控制相近视角变化。Appendix D 去掉原 SJC 的 emptiness 与 center losses。深度平滑可能消除孔洞,也可能抹掉真实薄结构;近邻约束能减闪烁,但相邻视角本来就有视差和遮挡,过强约束也可能压制真实变化。
公开脚本 near_loss 同时包含 RGB 与 depth 的 L1 差;readme 示例 10,000 steps、学习率 0.05、CFG 100、depth_smooth/near_view 权重 10,000,而脚本默认两者是 100,000。运行参数覆盖默认值,故不能只摘一处值当唯一实验配方。paper 报告约 30 分钟/A6000,但未将所有超参与其性能表逐一绑定。
09 · 从体场到 mesh:影响指标的后处理
Appendix D 对密度场在 \(200^3\) 网格采样,7³ 均值滤波、5³ erosion,再 marching cubes。阈值按数据集不同:GSO 用平均密度的 8 倍,RTMV 用 4 倍。这个阈值会直接改变表面厚度、空洞与体积 IoU;不能把输出 mesh 的质量全部归因于神经生成器。
\[\tau_{\mathrm{GSO}}=8\bar d,\qquad \tau_{\mathrm{RTMV}}=4\bar d,\qquad
\operatorname{IoU}(V_{\mathrm{pred}},V_{\mathrm{gt}})
=\frac{|V_{\mathrm{pred}}\cap V_{\mathrm{gt}}|}{|V_{\mathrm{pred}}\cup V_{\mathrm{gt}}|}.\]
预测与 GT 都先归一化进 unit cube。Chamfer Distance 采 2,000 点:Point-E/MCC 从预测点云取点,ours/SJC-I 从提取 mesh 取点;IoU 在 64³ 网格计算,MCC 则对 dense point cloud 直接占据化。文中没有明确 CD 是平方距离还是非平方、方向聚合的全部实现细节,因此不能仅凭“CD”恢复严格单位与公式。
Implementation Verified:export_mesh 默认 threshold_mult=8、kernel_size=7、erosion_kernel_size=5,分辨率为当前场插值 reso_mult=2,未硬编码所有情况为 200³;阈值在平滑后、erosion 前计算均值,再 erosion。这比只写“marching cubes”更接近实际操作;RTMV 需要显式覆写 4,否则默认不匹配论文。
输出是密度/辐射场与提取表面,不是分离 albedo/roughness/metallic 的可重光照材质,也不是可编辑程序图。镜面或照明可能被烘入 appearance;本文没有 BRDF ground truth、材质分解或 UV 无缝导出评测。
10 · Baseline 与公平性边界
| 基线 | 实际适配 | 比较需要记住 |
|---|---|---|
| DietNeRF | 官方低视图 NeRF 从零优化,MSE+CLIP 一致性 | 公开实现不含论文另一条 PixelNeRF finetune 功能;沿用 NeRF synthetic 设置 |
| Image Variations | image-conditioned SD | 有图像语义但没有同等相机条件控制,既是方法基线也帮助说明任务差异 |
| SJC-I | 将 SJC 文本先验换为图像条件先验 | 用于三维与 novel-view 比较;与 ours 的相机训练差别应明确 |
| Point-E | 官方图像到彩色点云;4,096 点,官方 grid 128 mesh 导出 | 点稀疏/网格孔洞会影响 IoU,好的 CD 不代表表面完整 |
| MCC | 先去背景与 MiDaS 深度,再给 RGB-D/点云模型 | 加入单目深度误差;相对 disparity 的 scale/shift 以全测试集看起来合理的常数设定 |
作者只纳入单 RGB、zero-shot、能在合理时间改造公开实现的模型。这是有边界的选择,并非穷尽所有同期 3D 方法。GSO 为单个扫描日常物体;RTMV 每场景 20 个随机物体,复杂度与训练单物体白底有明显 domain gap。
图像表只列 DietNeRF/IV/SJC-I/Ours,Fig.5/6 的视觉对比另外展示 Point-E/MCC;不能凭图片给未报告方法编造 PSNR。论文未完整报告测试对象数、评测相机采样数量、背景裁剪、FID 特征/样本数与置信区间,不应从表数字倒推出这些设置。
11 · 全部 v1 定量结果与数值解释
arXiv v1 · 原 Table 1
| DietNeRF [23] |
|
SJC-I [53] | Ours | |||
|---|---|---|---|---|---|---|
| PSNR | 8.933 | 5.914 | 6.573 | 18.378 | ||
| SSIM | 0.645 | 0.540 | 0.552 | 0.877 | ||
| LPIPS | 0.412 | 0.545 | 0.484 | 0.088 | ||
| FID | 12.919 | 22.533 | 19.783 | 0.027 |
arXiv v1 · 原 Table 2
| DietNeRF [23] |
|
SJC-I [53] | Ours | |||
|---|---|---|---|---|---|---|
| PSNR | 7.130 | 6.561 | 7.953 | 10.405 | ||
| SSIM | 0.406 | 0.442 | 0.456 | 0.606 | ||
| LPIPS | 0.507 | 0.564 | 0.545 | 0.323 | ||
| FID | 5.143 | 10.218 | 10.202 | 0.319 |
GSO 相对 DietNeRF:PSNR +9.445 dB,SSIM +0.232,LPIPS 下降 0.324;RTMV 相对最佳该项 baseline SJC-I:PSNR +2.452 dB、SSIM +0.150,而 LPIPS 的最好 baseline 为 DietNeRF 0.507,ours 0.323。比较每项时必须选该项的基线,不能把一个方法称为所有列的“第二名”。
FID 需要特别谨慎:GSO 0.027、RTMV 0.319 在 v1 和 ICCV 表里完全一致。它们远低于读者常见大数据 FID 量级,但论文没有完整披露该项计算协议;本页如实重建、标记信息缺口,不改成 27/31.9,也不自行归因于归一化、抄写错误或泄漏。没有评估代码执行证据时不能指控原因。


arXiv v1 · 原 Table 3
| MCC [59] | SJC-I [53] | Point-E [34] | Ours | |
|---|---|---|---|---|
| CD | 0.1230 | 0.2245 | 0.0804 | 0.0717 |
| IoU | 0.2343 | 0.1332 | 0.2944 | 0.5052 |
arXiv v1 · 原 Table 4
| MCC [59] | SJC-I [53] | Point-E [34] | Ours | |
|---|---|---|---|---|
| CD | 0.1578 | 0.1554 | 0.1565 | 0.1352 |
| IoU | 0.1550 | 0.1380 | 0.0784 | 0.2196 |
v1 Table 3 的 GSO:ours CD 0.0717 比 Point-E 0.0804 低约 10.8%,IoU 0.5052 比 Point-E 0.2944 高 0.2108。RTMV ours CD 0.1352,比 SJC-I 0.1554 低约 13.0%;IoU 0.2196,比 MCC 0.1550 高 0.0646。相对百分比仅是算术解释,不能变成实际感知质量增幅。

单视图背面存在不可识别性:一个不同但合理的补全也可能得低 CD/IoU。另一方面,渲染好看并不证明闭合、可打印、可动画或几何精确。Fig.9 把新视角 render 与 mesh 并列正是为区分表面和外观,但其定性样例不能代替标准化失败率。
12 · ICCV 新增消融:数据规模与预训练
ICCV 终稿 · 新增 Table 3
| 指标 | 800 | 8K | 80K | 800K(ours) | 800K(scratch) | DietNeRF | Image Variation | SJC-I |
|---|---|---|---|---|---|---|---|---|
| PSNR ↑ | 7.130 | 9.685 | 12.200 | 18.378 | 15.593 | 8.933 | 5.914 | 6.573 |
| FID ↓ | 8.418 | 1.767 | 0.236 | 0.027 | 0.059 | 12.919 | 22.533 | 19.783 |
终稿 p.9305(PDF 8);所有 8 个配置与 2 个指标保留
这是终稿独有的 Table 3,在用户固定 v1 的四表之外单独加入。训练集从 800、8K、80K 到 800K,PSNR 为 7.130、9.685、12.200、18.378;FID 为 8.418、1.767、0.236、0.027。从零训练 800K 为 PSNR 15.593、FID 0.059,相同规模使用预训练提高 2.785 dB,并降低 FID。
该表支持扩大数据量和预训练有价值;但预训练是包含 image-conditioned 起点的整体初始化,不能由此分解“纯二维几何知识”与优化稳定性、样本效率的独立作用。作者称 8K 已优于 baselines,但看 FID:8K 1.767 确实低于三条 baseline;PSNR 9.685 也高于基线最大 8.933。800 档还不如 DietNeRF,不能说所有小规模都领先。
未报告各规模的训练预算、重复 seed 与标准差,也没有单独去除 CLIP 支路、去除 concat 支路、不同 pose 编码或多视图一致性的系统消融。现有实验支持整体系统,不足以给每个模块排出独立贡献。没有基础/大模型两档架构对照;后来 XL 不属于本表。
13 · 官方实现审计:别把默认代码当原论文全部设置
读取 官方仓库 README、训练 YAML、Objaverse loader、diffusion model、Gradio demo、3D reconstruction 主循环与 mesh 导出。未 clone、未安装运行、未下载任何模型权重。GitHub tree API 本次被 rate limit 拒绝,故只审计上述直接可读文件,不声称覆盖完整仓库;每个文件保存来源与 hash。
- 预训练版本:README 使用 Lambda Labs sd-image-conditioned-v2.ckpt;其 v2 是该发布文件名,不能据此直接写成 Stable Diffusion 2.x 架构。768 维 context、代码配置和来源应一起判断。
- 投影初始化:772→768 层的前 768×768 初始化为 identity,bias 为零;最后四个 pose 输入列保留层初始化。能保留图像语义尺度,但不意味着整个扩散网络不变。
- 有效训练路径:目标 latent 明确来自 image_target;source latent 使用 VAE mode、detach;CLIP embedding 也 detach。AdamW parameter groups 明确为 U-Net 与 projection,projection 10×。
- 数据异常回退:loader 读取失败时改用一个固定有效资产路径取得 pose,再把 target/cond 图置零。此硬编码行为可能向训练引入零图样本,需日志统计;本次未运行,不能量化发生频率或认定影响了论文表格。
- 背景处理:load_im 的注释写 random color,但实际 __getitem__ 传入白色。应以执行分支为准,不能根据函数注释写“训练随机背景”。
- 发布权重:README 提供 105K/165K/230K/300K iterations,默认 105K,并明确说“训练更久可能过拟合”的说法未经经验验证;这是猜想而非已完成 checkpoint 消融。
- 3D 相机额外条件:输入 elevation 的估计写在 transform 文件中;这与单图新视角 API 的相对 pose 不同,资产重建流程不是完全免相机假设。
- 重建正则与导出:README 与默认脚本的正则系数不同;mesh density threshold 是数据集特定选择。记录命令、文件版本和后处理后才能宣称复现。
公开代码存在真正方法实现和训练配置,和“只有项目网页”不同;但是可读代码不等于已经测试依赖可安装、模型可跑、输出可复现。传统 SJC 路径、社区 SDS 路径和 Zero123-XL 要分别写清楚,不应混成同一个实验系统。
14 · 局限与扩展展示

Fig.10 用 DALL·E 2 先生成输入图,再通过 Zero-1-to-3 产生新视角:vaporwave 电脑与气球狗只是组合流程展示。没有证明从文本到三维全流程免提示工程、可保持真实照明或精确拓扑;DALL·E 2 是上游图像来源,不是本文训练/推理必须调用的服务。
- 不可见表面是推断。有一张准确正面并不能恢复真实背面的 logo、孔洞或内部结构;multi-sample 表达不确定性,仍可能 hallucinate。
- 复杂背景/多物体。RTMV 虽优于基线但绝对质量低,白底单物体训练与物体分割预处理限制真实场景泛化。
- 跨视图一致性。明确 pose 缓解 Janus,未给严格保证;独立新视角采样可能改变结构、材质和身份。共享体场及正则只是额外约束。
- 几何后处理。平滑、侵蚀和阈值可改善孔洞,也可能删除薄件、小纹理凸起或改变拓扑;不适合不加验证地用于尺寸敏感工程。
- 照明未分离。生成/体场记住渲染外观,不保证同一物体在新光照下物理正确;透明、镜面和细毛等未有专门成功率。
- 训练/评估数据边界。Objaverse 外测试不能排除互联网预训练接触同类图像;没有完整数据去重清单,不把 zero-shot 写成零先验。
15 · Reviewer:什么已经成立,什么值得进一步检验
Strengths:相机条件接口简单、可组合;把图像语义与像素身份分开传入;一套训练好的 view model 同时支持直接 NVS 与 score-guided 3D;真实/风格图与复杂场景测试展示一定分布外能力;终稿数据规模和 scratch 对照补强核心论点。作者公开附录、训练与重建入口,对复现有实质价值。
Weaknesses:评测协议与统计信息不足,FID 的特殊量级缺解释;主基线任务能力和训练数据不同;三维结果受 mesh 阈值、侵蚀及 MCC 深度适配影响;“预训练有丰富 3D knowledge”的表述比所做实验能严格分解的机制更强。论文并未证明一个二维模型内部存有真实一致的显式三维世界模型。
复现的优先顺序
- 固定 v1/ICCV 与 checkpoint 版本,先验证相机符号、弧度、归一化、白底和图像预处理;用一个已知 mesh 的可控渲染样例做 identity pose 与相反角度测试。
- 先复现单图 NVS,再启用三维优化;分别记录生成步骤、CFG、seed、输入 elevation 与候选数。
- 固定测试对象/相机清单,明确图像掩膜与 FID 算法;报告像素/感知指标之外的 pose accuracy 与跨视图对应。
- 对 3D 导出保存原密度场、阈值 sweep、侵蚀前后 mesh,比较 surface CD 与 volume IoU;不可只挑最高 IoU 的阈值。
- 记录失败样本、重复 seed 和时间/显存,并对 RGB+MiDaS 的 MCC 适配单独报告深度误差。
16 · 面向材质与程序生成的研究设想
Research Extension:均非论文已实现功能。
从“换视角”拓展到“换光照”
用同几何、固定材质、变化 HDR 的配对渲染,学习将光照参数和相机参数分离控制;用已知 BRDF 的 synthetic truth 检查是否烘光。需要多视角×多光照的组合外测试,不能把单个漂亮 relighting 样例当物理解耦证据。
把多视角分布用作程序材质监督
固定目标 mesh,用 Zero-1-to-3 提议不同视角 appearance,再优化可执行材质图的参数或结构。应将生成图作为带不确定性的软约束,避免相互矛盾幻觉驱动材质图产生错误节点;通过真实渲染、多光照、节点数量和可编辑性联合评价。
联合多视角一致性与自适应补拍
引入共享三维/多视角 latent、循环视角一致性、遮挡感知 correspondence,并测试长角度环路后 identity 漂移。若不同 seeds 在背面分歧大,可建议用户补拍对应视角,而不是默默给出“已重建真实背面”。比较固定照片数量下的随机补拍与不确定性采样。
让场优化与 mesh 后处理分离评估
对相同 density field 使用多个固定阈值/滤波配置,绘制 CD–IoU–薄结构保留率曲线;用显式 mesh/可微表面替代体素后,再比较是否只靠侵蚀提升体积指标。这可避免把后处理 heuristic 包装为学习表示的贡献。
17 · 原始资料与交付边界
- 固定 arXiv v1 PDF(13 页) · 官方 HTML
- ICCV 2023 正式记录 · 会议终稿 · 会议 supplement ZIP(内含 2 页 PDF)
- 官方项目 · 方法代码、权重入口和版本说明
阅读覆盖全部 v1 正文/附录、会议新增消融与 2 页补充,图表均有版本标记。所有四张 v1 表及终稿新增表完整重建;11 个原图保留,Fig.1 使用作者官方 teaser。浏览器、MathJax runtime 与实际图像加载/排版验收按本批指示延后;HTTP 200 与静态源码检查不等价于浏览器通过。
单文件 HTML、追加 Markdown、合并候选与来源/QA/归档计划为本次产物。未部署、未写用户 vault、未改共享 People/索引、未下载权重或执行作者方法。原始 PDF 与 note 全部保留。