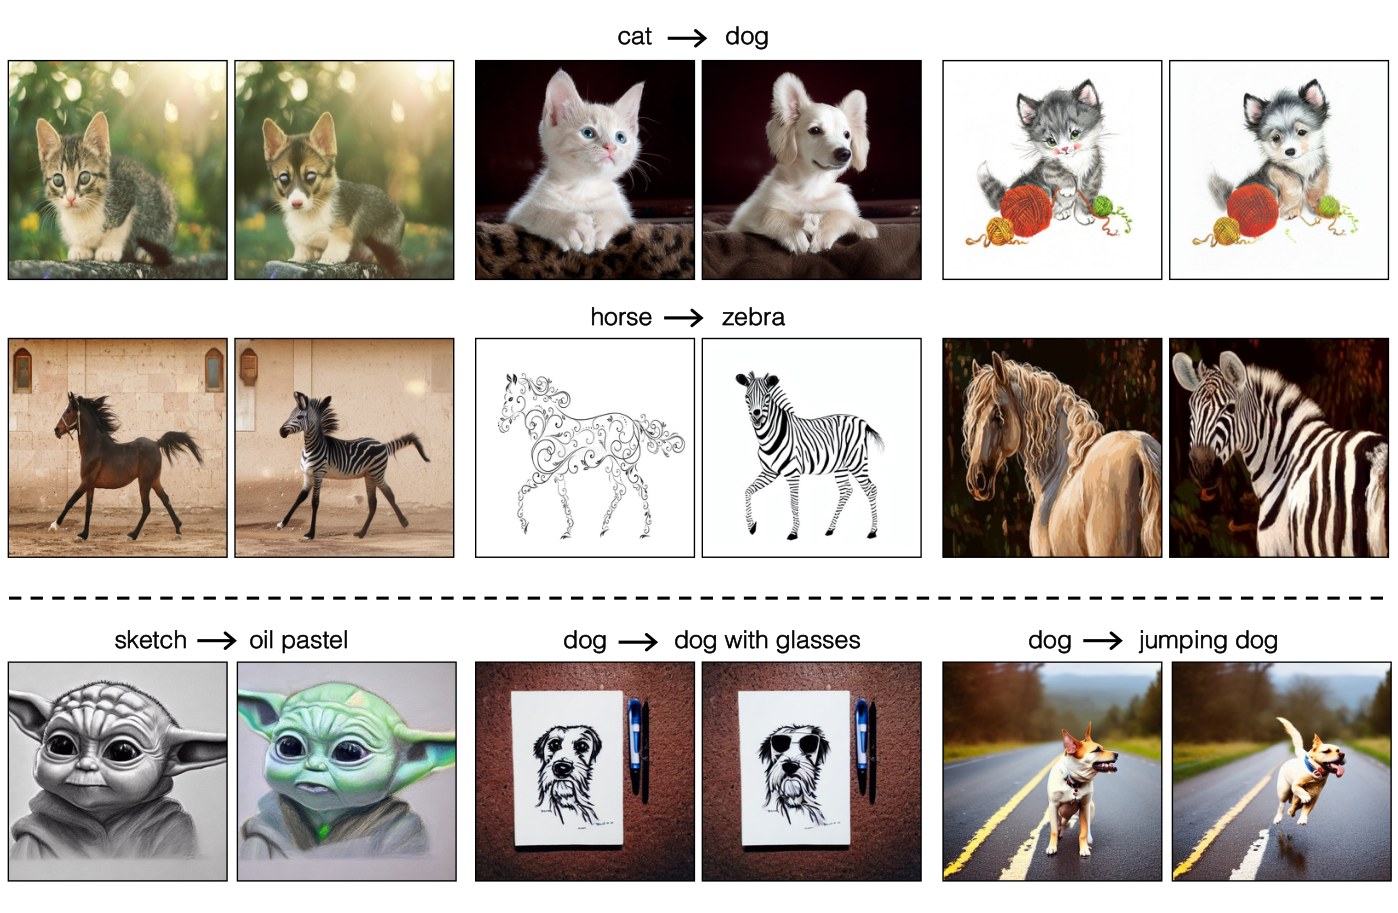
一张真实图像或已知生成噪声的合成图,加源域与目标域的文字概念,如 cat → dog。用户不必为每张真实图手写完整描述。
01 · 用软约束在“改得动”和“保得住”之间取舍
pix2pix-zero 不为每张图重新训练扩散网络,而是在文本条件中加入一个可复用的语义方向,并在去噪过程中用原图的 cross-attention 布局约束当前 latent。
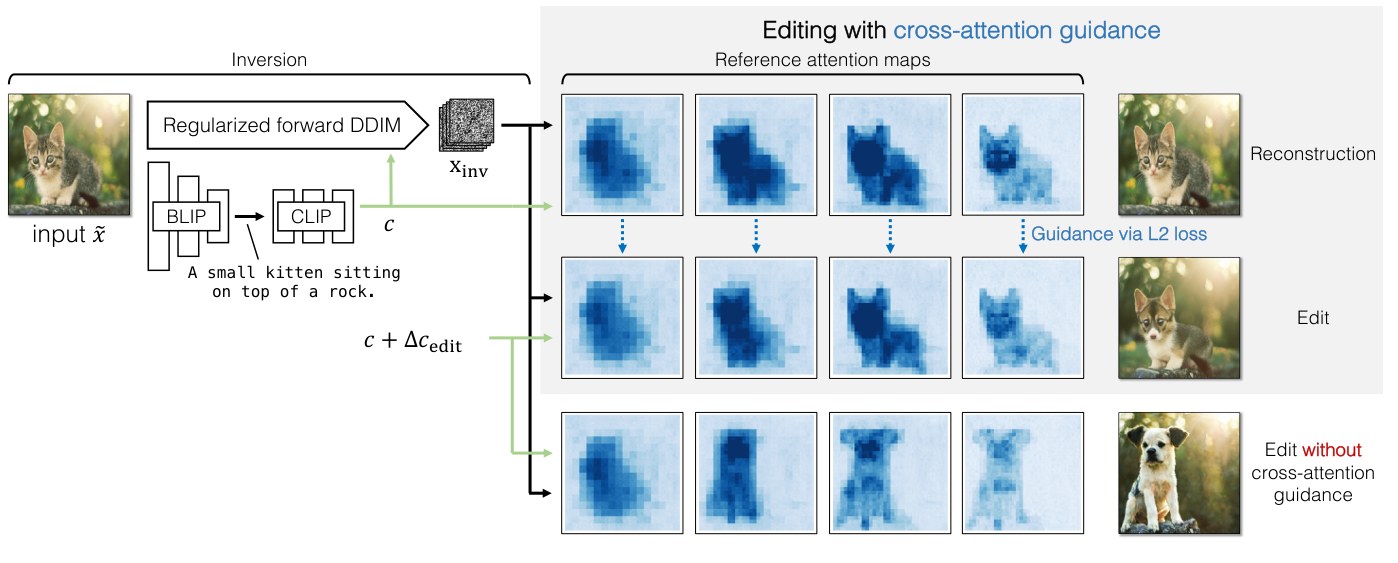
BLIP 自动 caption → CLIP 文本编码 → 正则化 DDIM inversion → 原条件重建并缓存 attention → 编辑方向加法与逐步 attention 梯度引导。
结构与背景保留改善,但更强语义编辑有时受到约束。horse → zebra 的完整方法 CLIP-Acc 并非最优。“Training-free”仅指扩散编辑主线,快速 GAN 变体必须训练。
Paper Verified 本页精读用户指定的 arXiv 2302.03027v1,2023-02-06,合订 PDF 共 21 页:正文 p.1–10、参考文献 p.11–13、附录 p.14–21。覆盖全部 16 图、2 表与 Algorithm 1;不是将 21 页都算成补充材料。正式项目与作者仓库标注 SIGGRAPH 2023。固定版本 PDF · 官方项目
02 · 身份、旧笔记纠正与工作范围
完整作者顺序:Gaurav Parmar、Krishna Kumar Singh、Richard Zhang、Yijun Li、Jingwan Lu、Jun-Yan Zhu。第一与末位作者属于 Carnegie Mellon University,其余四位属于 Adobe Research;第一作者在 Adobe 实习期间完成了部分工作。未在本次检查的论文与官方项目入口看到明确通讯作者标记,因此 Jun-Yan Zhu* 仍只是按末位作者规则选取的候选,状态为 unverified。
ACM 提交的 Crossref 记录核实正式 DOI 为 10.1145/3588432.3591513,出版日期 2023-07-23,正式会议文献页码 1–11。它与本次保留的 21 页预印本合订版页数口径不同;本页所有原图页码都指向固定 v1,而非借用出版版页码。
原笔记中“CLIP 对 input image 进行描述,再把 c 的词替换”并非本文完整方法。 图像描述由 BLIP 生成,CLIP text encoder 把描述转换为条件。词替换是重要 baseline;本文主方法是多个句子的平均 embedding 差,并非先把原 caption 改写成目标句再编码。此处追加纠正,不覆盖原笔记、批注或 PDF++ anchors。
“zero-shot / training-free / prompting-free”有明确适用范围:不训练新的逐任务扩散模型、不需要逐图手写精细 caption;仍依赖大规模预训练 SD、BLIP、CLIP,仍须指定编辑意图,仍须计算或提供方向句库,仍有每图测试时梯度优化。可选 GAN 蒸馏另需成对数据和训练。它不是无条件、无文本、无计算的编辑器。
本文是二维图像编辑,不输出 mesh、BRDF 参数、shader graph、SBS/SBSAR 或可执行材质程序。后文面向材质生成的启发会明确标为 Research Extension,不把图像编辑结果等同于物理材质编辑。
03 · 为什么需要新的编辑接口
传统成对或非成对 image translation 为固定任务训练模型,难以临时增加新任务。预训练 text-to-image 模型覆盖更宽的视觉概念,却不天然提供“只改变这一点”的控制:一句 caption 不足以描述原图所有纹理、照明和背景;改几个词可能连姿势、布局也一起改变。
作者把问题分成两条相对独立的轴:语义变化由文本空间的方向表示;内容保留由源图去噪轨迹中的 attention 布局表示。DDIM inversion 负责将真实图像带入可复用的生成轨迹;噪声正则旨在让这个入口保留可编辑性。这个分解使方向可跨图复用,又给每张图保留自己的结构参照。
与 SDEdit 相比,本文不只依靠“加多少噪声”折中编辑强度与保真度;与 prompt-to-prompt 的硬 attention 替换相比,本文允许 attention 为目标语义而变化,只惩罚偏离;与 Imagic 的逐图全模型 finetuning 相比,主方法不更新网络权重。上述是论文所设比较背景,不能泛化成所有后续版本的技术差异。§1–2
04 · 张量、变量与被冻结的模型
\[\widetilde x\in\mathbb R^{512\times512\times3},\qquad x_0=\mathcal E(\widetilde x)\in\mathbb R^{64\times64\times4},\qquad \widetilde x_{\mathrm{edit}}=\mathcal D(x^{\mathrm{edit}}_0).\]
论文在 channel-last 形式介绍图像与 latent;公开 PyTorch 实现采用 batch/channel-first,不能把两种记法视为模型不同。VAE 编码器/解码器为 \(\mathcal E,\mathcal D\),中间变量 \(x_t\) 为扩散 latent;\(x_{\mathrm{inv}}=x_T\) 是反演获得的起点。U-Net \(\epsilon_\theta(x_t,t,c)\) 预测噪声,\(\theta\) 是预训练参数,不是本任务要优化的材质参数。
| 符号 / 模块 | 含义 | 是否被优化 |
|---|---|---|
| \(c\) | BLIP caption 经 CLIP text encoder 的序列特征 | 只编码,不对 caption 或 encoder 做逐图训练 |
| \(\Delta c_{\mathrm{edit}}\) | 目标句库与源句库的平均特征差 | 一次计算,可用于多个输入;不是梯度学习网络 |
| \(M_t^{\mathrm{ref}},M_t^{\mathrm{edit}}\) | 原条件与编辑条件下的跨注意力概率 | 前者缓存;后者随 latent 改变 |
| \(\epsilon_t\) | 反演中预测的噪声张量 | 正则阶段直接更新其数值 |
| \(x_t\) | 编辑中的当前 latent | attention loss 的测试时梯度更新目标 |
| Stable Diffusion v1.4 | VAE、CLIP 条件、U-Net;论文唯一主实验模型 | 不微调其权重;没有 SDXL 或“大模型档”实验 |
公开方向脚本保留 tokenizer 的 token 位置维度:padding 到最大长度,对每句调用 text encoder 后,仅对“句子样本”维求均值。因此方向不是一个脱离 token 轴的单独全局 CLIP image embedding。不要把代码注释中写的某个固定宽度当作经验证张量规格,实际维度由所载模型决定。固定代码:方向构造
05 · 真实图像如何进入生成轨迹
图像先编码到 \(x_0\),BLIP 生成描述并编码为 \(c\)。作者使用确定性 DDIM 对应的反演递推,逐步增加噪声,而不是 DDPM 的随机前向过程。原 Eq.(1–2) 的语义可写为:
\[\widehat x_0(x_t,t,c)=\frac{x_t-\sqrt{1-\bar\alpha_t}\,\epsilon_\theta(x_t,t,c)}{\sqrt{\bar\alpha_t}},\tag{2}\]
\[x_{t+1}=\sqrt{\bar\alpha_{t+1}}\,\widehat x_0(x_t,t,c)+\sqrt{1-\bar\alpha_{t+1}}\,\epsilon_\theta(x_t,t,c).\tag{1}\]
\(\bar\alpha_t\) 是累计噪声调度系数。先由当前 noisy latent 与预测噪声估计干净 latent,再按下一时间步噪声比例组合。最终得到 \(x_T\),后续重建和编辑必须从同一个 \(x_T\) 重新开始。它是模型条件下的近似逆过程,离散步长、预测误差、VAE 损失都会使 reconstruction 不等于原像素,不应宣称 DDIM 保证无损可逆。
合成图像若已知生成噪声与原始条件,可以从生成起点直接执行两条去噪轨迹,不必把它当作未知真实图再次反演。对于真实图,caption 不完整或错误时,反演与编辑都可能受到影响;论文没有报告 caption 错误率或人工替换 caption 的对照。§3.1
06 · 噪声正则:修正的是噪声,不是网络权重
作者观察到 DDIM inversion 的预测噪声未必保持未相关高斯白噪声的统计特性,从而降低后续编辑能力。设计目标包含两点:空间偏移位置之间少相关,均值与方差接近 0 与 1。它不能仅靠逐点强制归一化实现,作者报告这种硬归一化会使去噪发散,所以采用软 penalty。
以预测噪声 \(\eta^0\in\mathbb R^{64\times64\times4}\) 构造 64、32、16、8 四层金字塔。正文明确说 2×2 average pooling 后乘 2,以保持期望方差。 偏移使用 circular indexing,且在迭代中随机采样,以便更快覆盖长距离关系。下式是对正文“相关系数平方和”的显式教学展开,不机械照抄 PDF 中易混淆的 Eq.(3) 排版:
\[C_{p,c}^{h}(\delta)=\frac{1}{S_p^2}\sum_{i,j}\eta_{i,j,c}^{p}\eta_{i-\delta,j,c}^{p},\qquad C_{p,c}^{v}(\delta)=\frac{1}{S_p^2}\sum_{i,j}\eta_{i,j,c}^{p}\eta_{i,j-\delta,c}^{p},\]
\[\mathcal L_{\mathrm{pair}}\propto\sum_{p,c,\delta}\left[\left(C_{p,c}^{h}(\delta)\right)^2+\left(C_{p,c}^{v}(\delta)\right)^2\right],\qquad \mathcal L_{\mathrm{auto}}=\mathcal L_{\mathrm{pair}}+\lambda\mathcal L_{\mathrm{KL}}.\]
Our Interpretation 上式突出先空间平均、再平方的含义;取样次数、归一化和尺度因子会改变有效优化强度,因此不能把比例表达式作为原实现逐字复刻。高斯矩匹配常见写法为 \(\frac12(\mu^2+\sigma^2-1-\log\sigma^2)\);论文没有写出完整 KL 实现,公开 reimplementation 使用全张量均值/方差、无 \(\frac12\) 系数,并加数值稳定项。
每个 inversion timestep 的 noise prediction 上做 5 次正则迭代,附录给出权重 20。公开代码又细分成 \(\lambda_{\mathrm{ac}}=20\)、\(\lambda_{\mathrm{kl}}=20\),每轮采样 5 个 roll;这些是代码事实,不能强行解释为正文相对权重 \(\lambda=20\) 的完全相同参数化。代码 pooling 后没有正文描述的乘 2,这一可核实差异会改变粗尺度相关项相对权重。
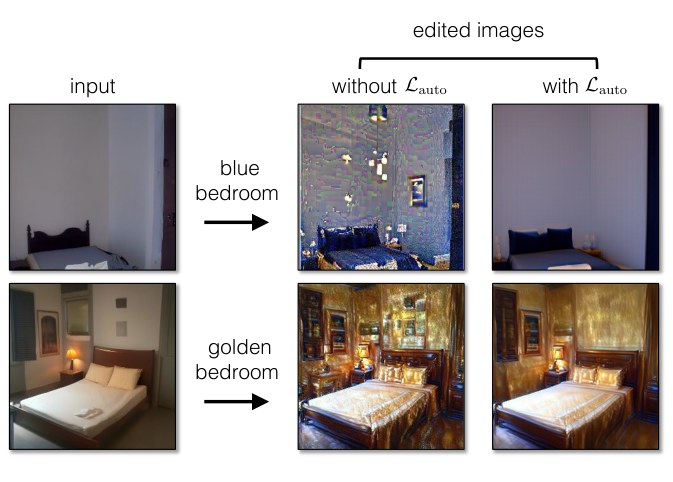
本文假说是“更符合噪声先验有利于编辑”,并未证明经验均值/方差加若干自相关约束就使噪声严格独立高斯。表 2 中 C 相比 B 的增益有限,结构距离还略变差;附录在较小 LSUN Bedrooms diffusion model 上看到更强效果,但该模型经过 DiffusionCLIP 微调,不代表主流程也要微调。Eq.(3) 与正文 · 附录 C
07 · 编辑方向为什么由句库差而来
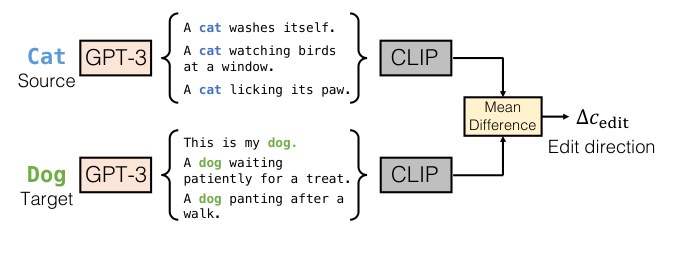
\[\bar c_s=\frac{1}{N_s}\sum_{i=1}^{N_s}E_{\mathrm{text}}(q_i^s),\quad \bar c_t=\frac{1}{N_t}\sum_{j=1}^{N_t}E_{\mathrm{text}}(q_j^t),\quad \Delta c_{\mathrm{edit}}=\bar c_t-\bar c_s,\quad c_{\mathrm{edit}}=c+\Delta c_{\mathrm{edit}}.\]
源概念与目标概念各自生成多种自然语言句子,再取平均差。这里的 \(E_{\mathrm{text}}\) 是 CLIP 文本编码器,\(q\) 是句子;不是对图像 embedding 做方向,也不是对模型参数作插值。多句平均旨在降低单个措辞或上下文的偶然影响。作者允许 GPT-3 句子生成器或预定义模板;论文未发布完整 system/user prompt、GPT-3 具体版本、采样温度与所有句库。
方向约需 5 秒并只需预计算一次,是论文对方向计算的报告;不是整张图编辑耗时,也不应自动包含外部 GPT-3 请求耗时。官方 README 建议约 1000 句,离线脚本接收两个句子文件,不会自行调用 GPT-3。因而“无需手动 prompting”与“无需准备方向资源”是不同问题。
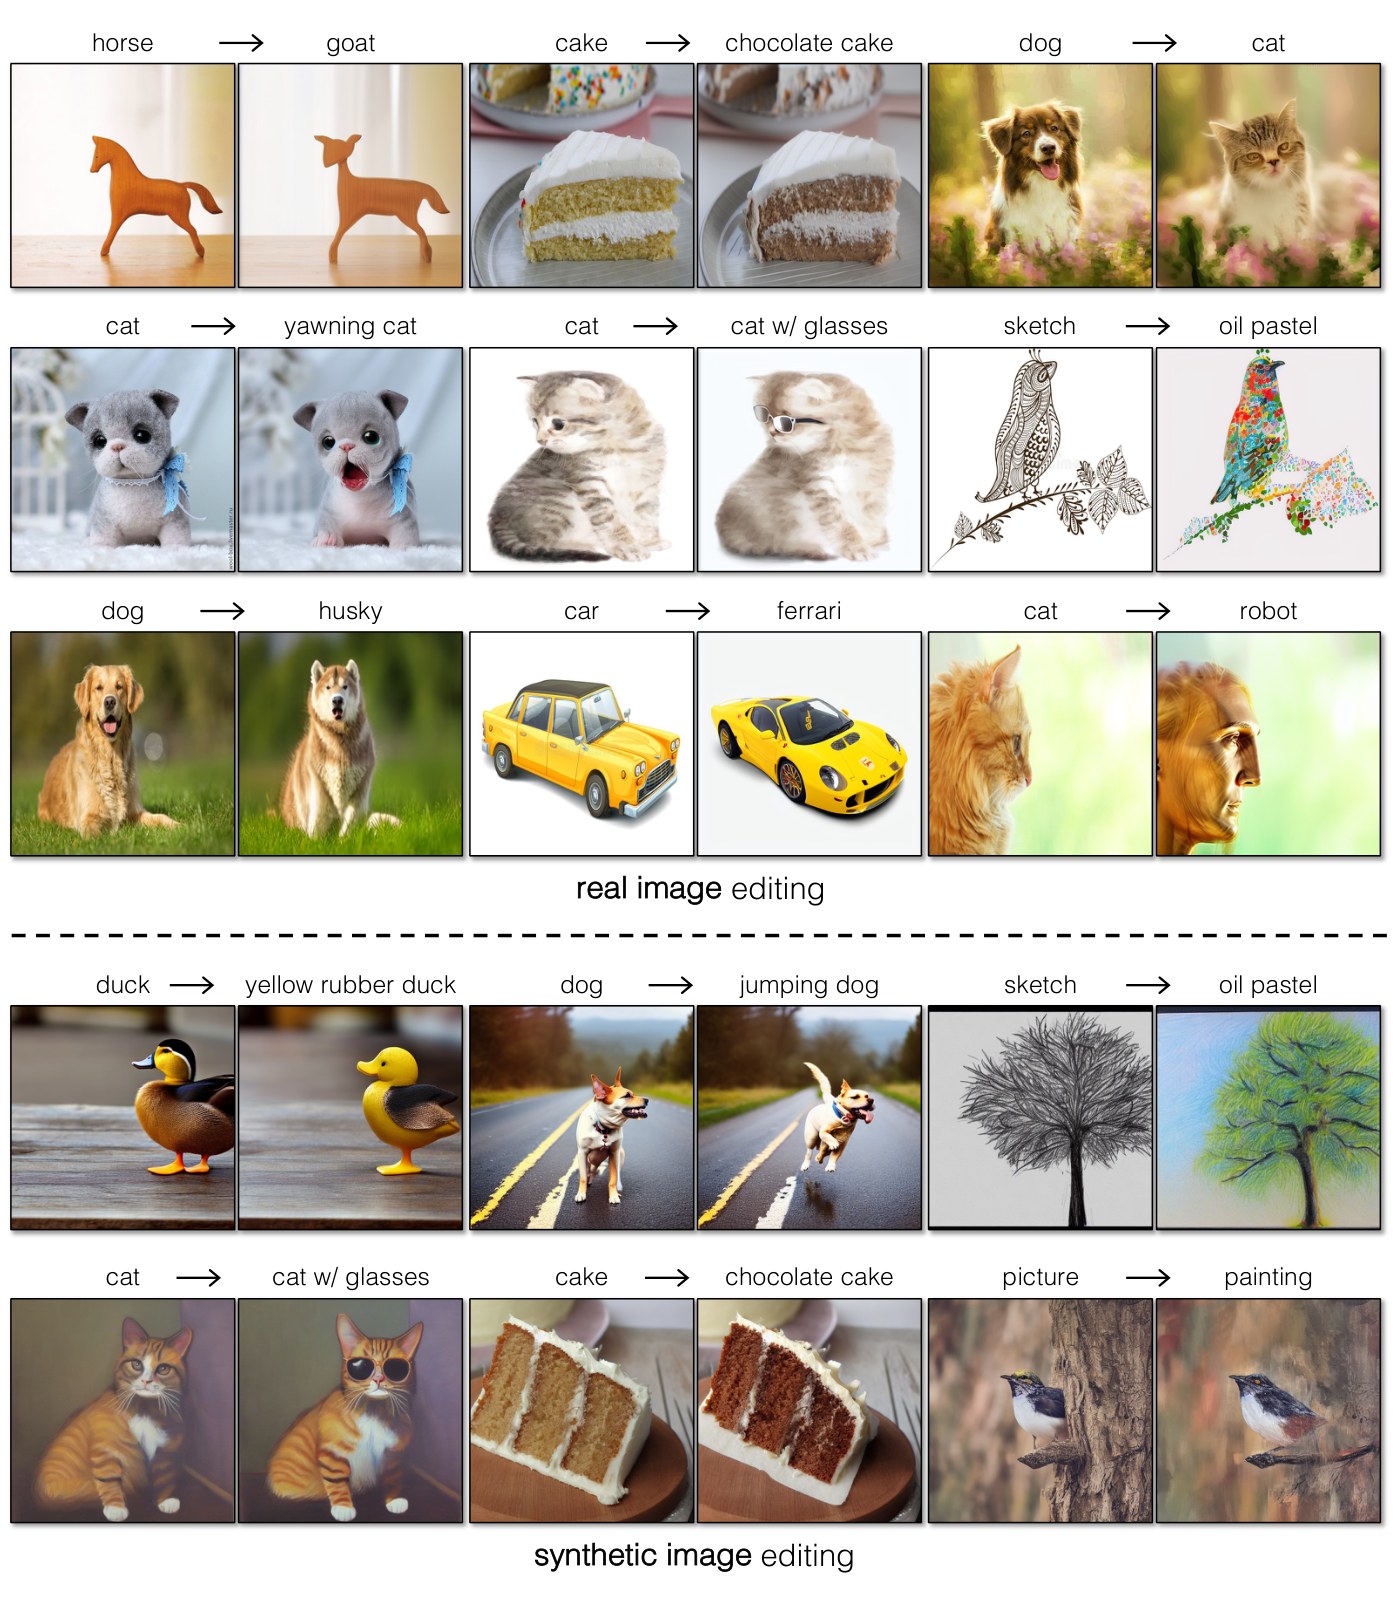
句库可以覆盖物体类别、属性、风格与动作,例如 dog→husky、cat→cat with glasses、sketch→oil pastel。方向并不保证与姿势、背景或其他语义正交;如果目标句库系统性带有某种环境,它的差向量也可能携带环境变化。不同类别包含不同 token 数,按 token 位置平均并非语义一一对齐;这是有效经验做法,不是可逆线性语义坐标系的证明。
表 2 D 的猫狗与风格编辑 CLIP-Acc 上升,却使加眼镜降到 20.8%;因此多句方向不是对所有任务都单调更好。最终 attention guidance 与方向的交互才是系统行为,不能只截取某一行证明方向普适。§3.2
08 · Cross-attention guidance 的计算与两阶段去噪
\[Q=W_Q\phi(x_t),\quad K=W_Kc,\quad V=W_Vc,\qquad M_t=\operatorname{Softmax}\left(\frac{QK^\top}{\sqrt d}\right),\quad \operatorname{Attention}(Q,K,V)=M_tV.\tag{4}\]
查询 \(Q\) 来自 U-Net 空间特征,键和值来自文本 token,\(d\) 为投影宽度;\(M_{i,j}\) 描述第 \(i\) 个空间位置对第 \(j\) 个文本 token 的注意力。正文把它与图像结构联系起来,但 attention 不是像素分割真值,也不等同于深度、表面法线或显式几何。
先在原条件 \(c\) 下从 \(x_T\) 去噪重建,缓存每个 timestep 的 \(M_t^{\mathrm{ref}}\)。然后重置回同一个 \(x_T\),条件换为 \(c+\Delta c_{\mathrm{edit}}\)。每一步先预测 \(M_t^{\mathrm{edit}}\),对 latent 做一次梯度更新,再重新预测噪声并进行 DDIM 去噪。
\[\mathcal L_{\mathrm{xa},t}=\left\|M_t^{\mathrm{edit}}-M_t^{\mathrm{ref}}\right\|_2,\qquad x_t^{\prime}=x_t-\lambda_{\mathrm{xa}}\nabla_{x_t}\mathcal L_{\mathrm{xa},t}.\tag{5}\]
上式保留论文 Eq.(5) 的范数记法;公开代码实际累计的是各 attention 层的平方差,在 token/空间维求和,再对头/批维平均。范数与平方范数的梯度尺度不同,复现时应明确选择。缓存的原 attention 是约束参照,不在每步被重新训练;模型权重不通过 optimizer 更新。
\[\widehat\epsilon_t=\epsilon_\theta(x_t^{\prime},t,c_{\mathrm{edit}}),\qquad x_{t-1}=\sqrt{\bar\alpha_{t-1}}\frac{x_t^{\prime}-\sqrt{1-\bar\alpha_t}\widehat\epsilon_t}{\sqrt{\bar\alpha_t}}+\sqrt{1-\bar\alpha_{t-1}}\widehat\epsilon_t.\]
Paper vs. Implementation 最后一式使用更新后的 latent,是公开 reimplementation 的概念化流程。Algorithm 1 的 UPDATE 调用仍写 \(x_t\),同时用 \(x_t-\lambda_{\mathrm{xa}}\Delta x_t\) 计算噪声;伪代码没有把这个状态赋值写清。不要将这一处符号简略当成已经运行验证的等价实现。附加 classifier-free guidance 用于实际采样,和 attention guidance 是两个不同控制旋钮。
- 准备 caption、预计算方向、反演噪声;确保模型/tokenizer/噪声 schedule 匹配。
- 在原条件下运行完整重建,保存 timestep 和层名索引的 attention。
- 重置 latent,切换编辑条件;每步前向求 attention loss。
- 仅对当前 latent 做梯度步,再前向预测噪声,再由 scheduler 推进一步。
- 解码编辑 latent,并与原图、VAE 重建与无编辑重建分别比较,避免混淆 VAE 误差和编辑误差。
增强 \(\lambda_{\mathrm{xa}}\) 可减少结构变化,也可能压制需要结构变化的目标;过弱时对象形状与背景易漂移。该方法比硬替换更灵活,但不是“任意语义编辑且原结构完全不变”的保证。§3.3 与 Algorithm 1
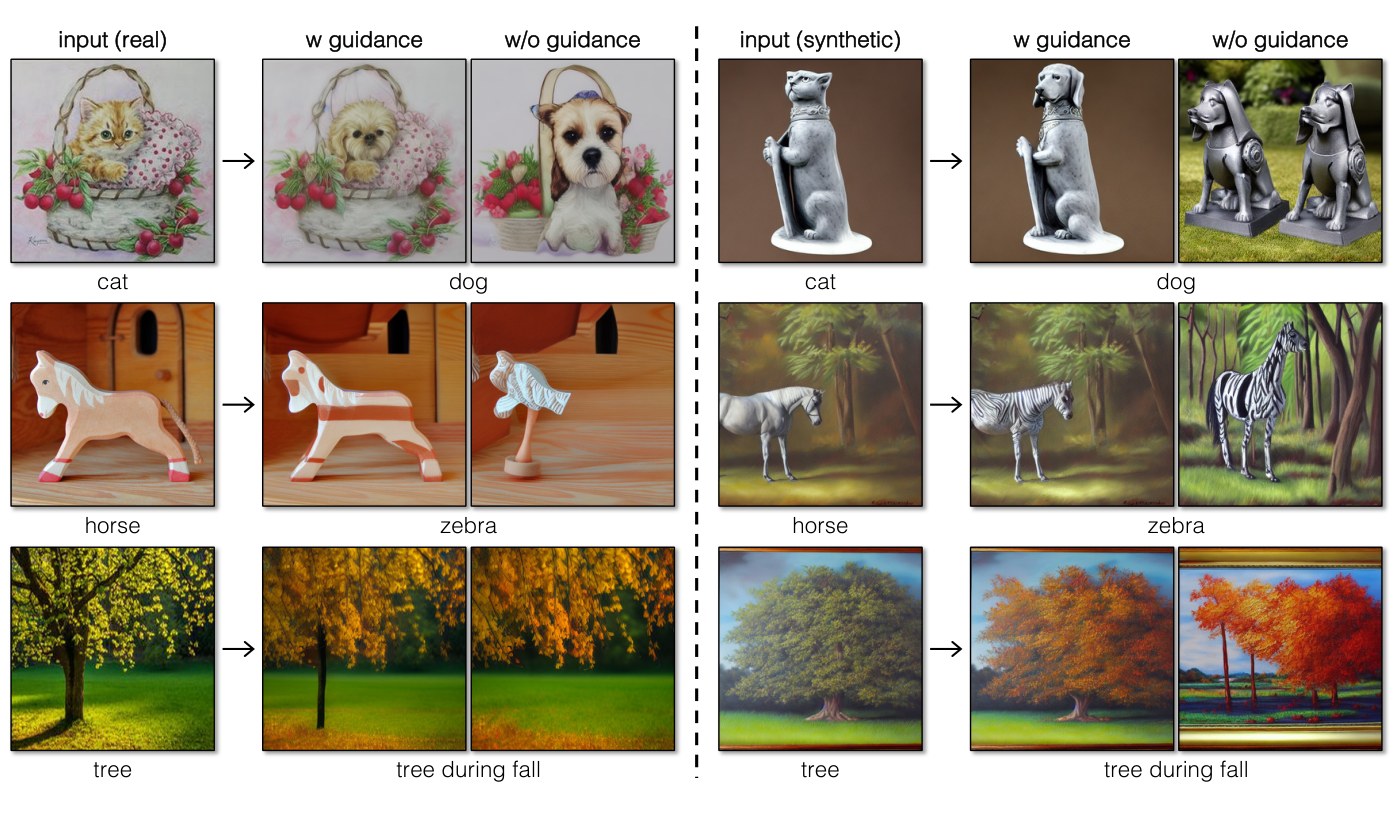
09 · 实验协议、设置与可复现缺口
四项任务:cat→dog、horse→zebra、cat→cat with glasses、sketch→oil pastel。真实输入从 LAION 5B 用源概念 CLIP 检索,每任务取 250 张,使用 aesthetics filter 9。此筛选偏向高美学且概念显著的图像,不等于随机互联网图片分布。主方法没有训练/验证集的传统划分,但测试集合选择依旧会影响泛化结论。
| 项目 | 固定 v1 可核实设置 | 缺失或注意事项 |
|---|---|---|
| 模型 / 尺寸 | Stable Diffusion v1.4;512² RGB;64²×4 latent | 未报告总参数数;不增造基础/大模型双档 |
| 步数 | inversion 100、reconstruction 100、editing 100 | 不是总共 100;编辑还需额外 attention 前向与反向 |
| 噪声正则 | 每 inversion timestep 5 次,权重 20 | 完整旧 CompVis 配置未随正文列出 |
| CFG | 所有编辑用 CFG;基线同 guidance 与 sampling steps | 附录未给论文实验的确切 CFG 数值;不能用公开脚本默认回填 |
| Attention guidance | 逐步对齐;保留参考图的结构 | 论文未给全面超参 sweep 与逐任务最优值表 |
| 句库 | GPT-3 或模板;多句平均方向 | 论文未给完整生成 prompt、温度、句子列表 |
| 训练超参 | 扩散主线无逐任务网络训练 | epoch、学习率、batch 不适用于它;GAN 支线另列 |
| 算力 / 时间 | GAN 单图 0.018 秒,A100+PyTorch;约 3800×加速 | 不是 CPU 时延;未给完整端到端资源、方差和显存表 |
基线 SDEdit+word swap、DDIM+word swap、prompt-to-prompt 均用 Stable Diffusion、相同采样步数和 CFG,作者称采用官方实现与推荐超参。等去噪步数不等于等总 FLOPs,本文额外缓存、梯度和重复前向仍有开销。没有在主表报告 Imagic、InstructPix2Pix、GAN 蒸馏的同协议数字,不能补成“优于所有编辑方法”。比较协议 · 附录 D 实现细节
10 · 三个指标测量的不是同一件事
\[\mathrm{CLIPAcc}=\frac{100}{N}\sum_{i=1}^{N}\mathbf1\left[\operatorname{sim}(I_i^{\mathrm{edit}},q_t)\gt\operatorname{sim}(I_i^{\mathrm{edit}},q_s)\right].\]
Our Interpretation 上式按正文定义展开:编辑后图与目标文字的 CLIP 相似度是否超过源文字。它是概念分类代理,不直接判断目标修改是否精确、自然,也不惩罚多改背景。Structure Dist 沿用引用文献的结构距离,越低越接近输入结构;正文没有完整展开其特征层和具体代码。BG LPIPS 用 Detic 确定背景后测感知差异,越低越好。
主表只给猫狗与马斑马两项的 BG LPIPS;加眼镜与全局风格编辑没有该列。后者对全图风格确实不适用,但“加眼镜不需要评价背景”是论文协议选择,并非它不能误改背景。Detic 误分割会污染背景评价。三个指标必须联合阅读,不能把一个更高的 CLIP-Acc 自动称为更好的可控编辑。
本页完整重建 Table 1 的 4 方法×10 数值,Table 2 的 5 配置×10 数值;所有 90 个原始数据值保留。按任务拆分是为可读性,不删除输掉的项。未报告用户研究、置信区间、多个随机种子方差或显著性检验,不编造这些证据。
11 · 全部主表:优势与反例同时保留
原 Table 1 · cat → dog
| 方法 / 配置 | CLIP-Acc ↑ | BG LPIPS ↓ | Structure Dist ↓ |
|---|---|---|---|
| SDEdit + word swap | 71.2% | 0.327 | 0.081 |
| DDIM + word swap | 72.0%次优 | 0.279 | 0.087 |
| prompt-to-prompt | 66.0% | 0.269次优 | 0.080次优 |
| pix2pix-zero | 92.4%最优 | 0.182最优 | 0.044最优 |
原 Table 1 · horse → zebra
| 方法 / 配置 | CLIP-Acc ↑ | BG LPIPS ↓ | Structure Dist ↓ |
|---|---|---|---|
| SDEdit + word swap | 92.2%次优 | 0.314 | 0.105 |
| DDIM + word swap | 94.0%最优 | 0.283 | 0.123 |
| prompt-to-prompt | 18.4% | 0.261次优 | 0.095次优 |
| pix2pix-zero | 75.2% | 0.194最优 | 0.066最优 |
原 Table 1 · cat → cat w/ glasses
| 方法 / 配置 | CLIP-Acc ↑ | Structure Dist ↓ |
|---|---|---|
| SDEdit + word swap | 34.0% | 0.082 |
| DDIM + word swap | 37.6% | 0.085 |
| prompt-to-prompt | 69.6%次优 | 0.081次优 |
| pix2pix-zero | 71.2%最优 | 0.028最优 |
原 Table 1 · sketch → oil pastel
| 方法 / 配置 | CLIP-Acc ↑ | Structure Dist ↓ |
|---|---|---|
| SDEdit + word swap | 21.2% | 0.085 |
| DDIM + word swap | 32.4%次优 | 0.082 |
| prompt-to-prompt | 10.8% | 0.079次优 |
| pix2pix-zero | 75.2%最优 | 0.052最优 |
猫→狗:Ours CLIP-Acc 92.4%,相比最强基线 DDIM 的 72.0% 高 20.4 个百分点;BG LPIPS 0.182 与 Structure Dist 0.044 也更低。猫加眼镜的准确率为 71.2%,仅比 prompt-to-prompt 的 69.6% 高 1.6 个百分点;结构距离由 0.081 降到 0.028,更明显的优势在结构保留,不能把准确率小差距夸大成统计显著。
马→斑马是必须指出的 trade-off:Ours 75.2% 明显低于 DDIM 94.0% 与 SDEdit 92.2%,但是 BG LPIPS 0.194、Structure Dist 0.066 更好。原 Table 1 图注概括“最高 CLIP 分类准确率”不能覆盖这列的事实。该系统更偏保留原图,可能牺牲条纹/类别转换强度。
草图→油画棒:Ours 75.2% 对比最高基线 32.4%,提高 42.8 个百分点;结构距离 0.052 也最低。总体可说其在该四任务协议下提供了更好的结构保留与语义变化折中,而不是每个指标都全面胜出。绝对百分点与相对百分比必须区分。
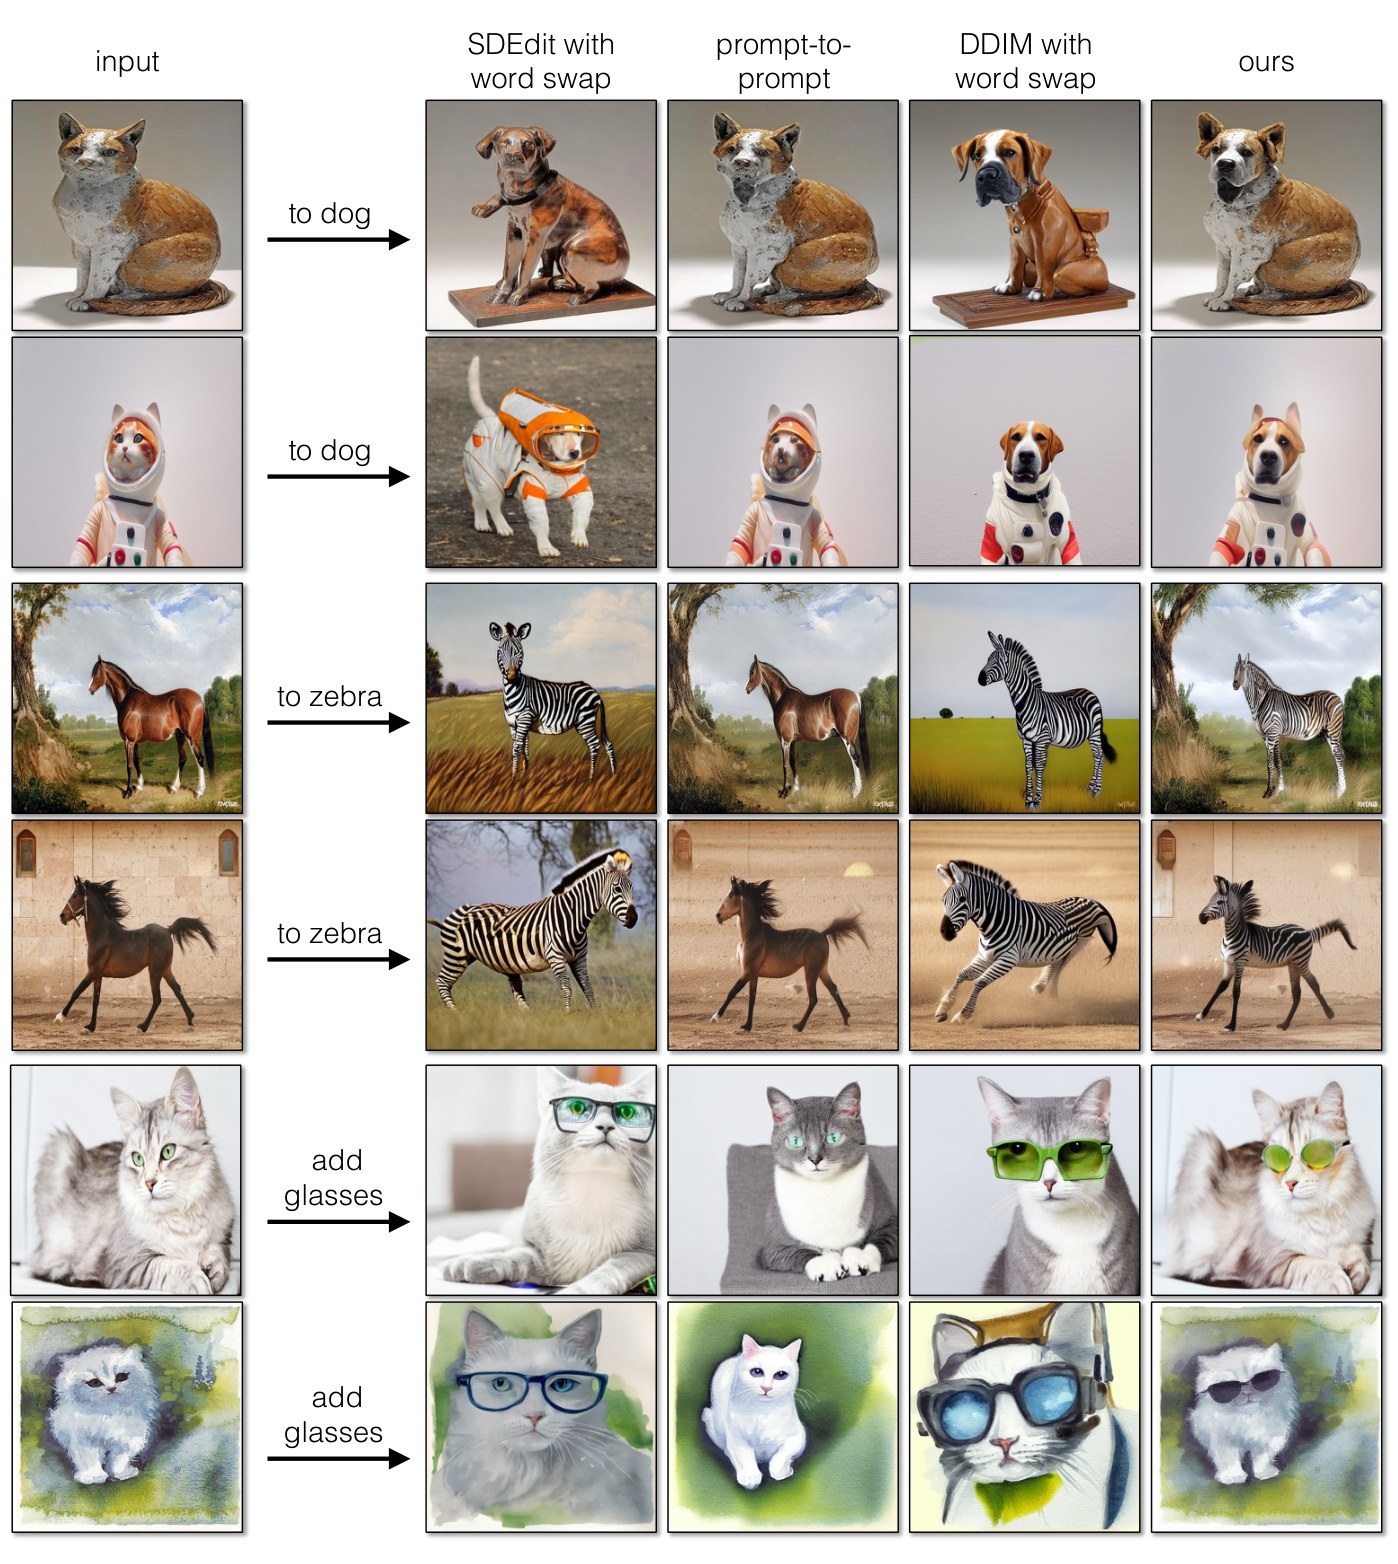
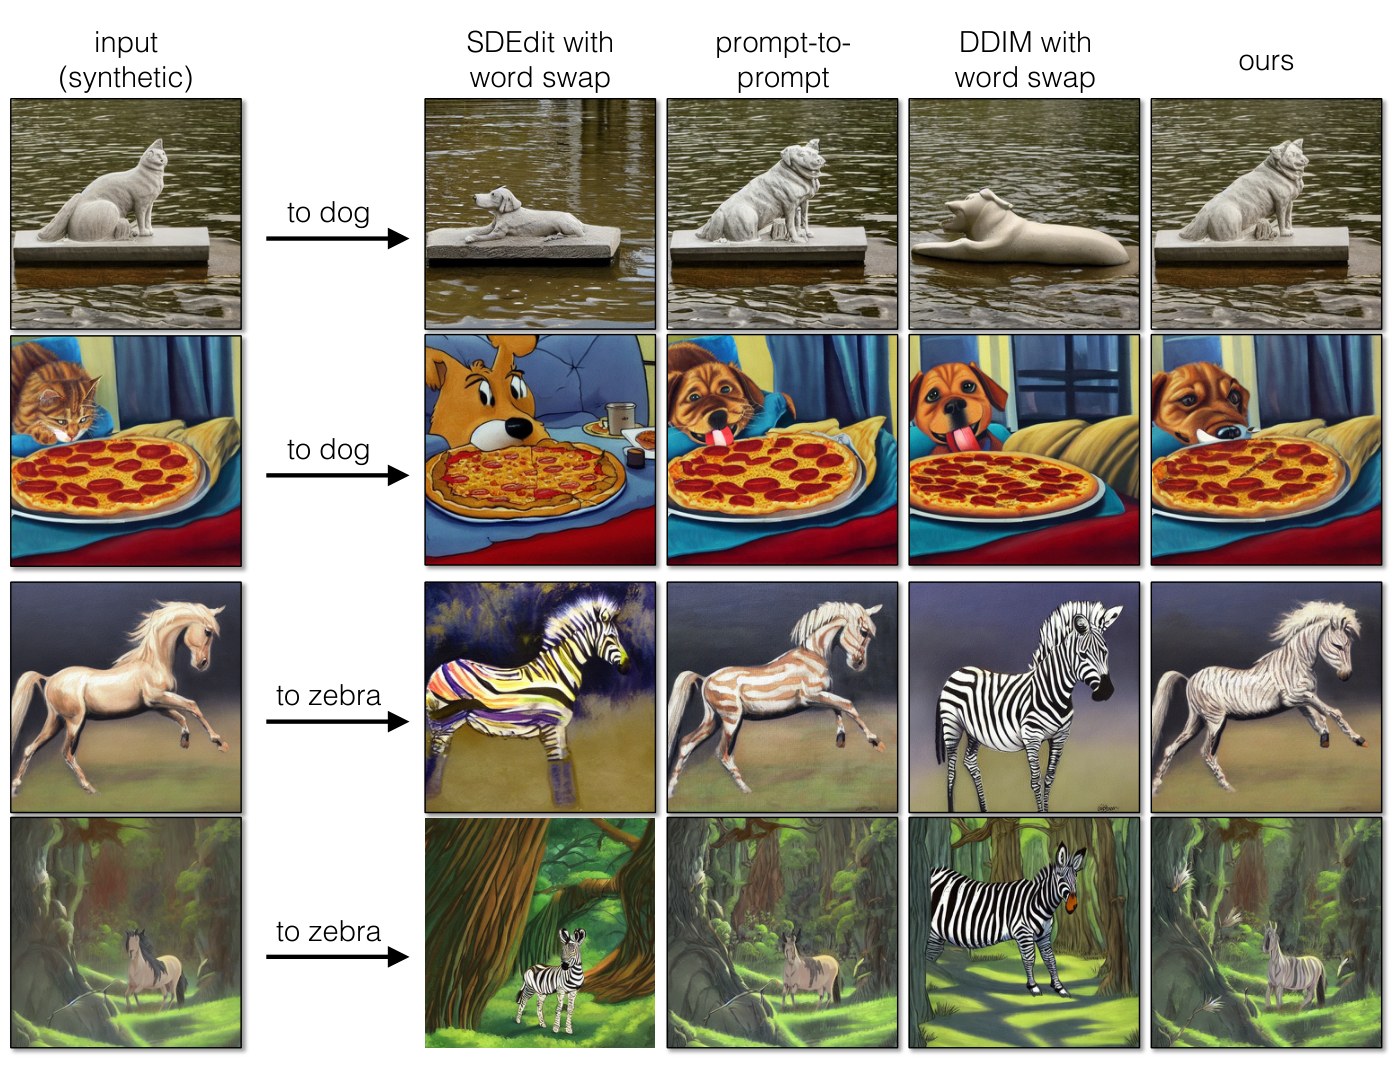
Fig.5 为真实图像基线比较,Fig.12 是附录合成图像对照。正文解释 SDEdit/DDIM 容易改姿势和背景,prompt-to-prompt 的硬约束有时改不动;这些是作者选定样例,并不替代全测试集统计。合成图像的原始生成路径已知,不能把其效果无条件外推到真实照片。Table 1
12 · 全部消融:模块收益并不单调
原 Table 2 · cat → dog
| 方法 / 配置 | CLIP-Acc ↑ | BG LPIPS ↓ | Structure Dist ↓ |
|---|---|---|---|
| A · DDPM / word swap | 71.6% | 0.392 | 0.126 |
| B · DDIM / word swap | 72.0% | 0.279 | 0.087次优 |
| C · DDIM+Lauto / word swap | 72.4% | 0.283 | 0.089 |
| D · DDIM+Lauto / sentence directions | 100.0%最优 | 0.274次优 | 0.095 |
| E · D+Lxa / ours | 92.4%次优 | 0.182最优 | 0.044最优 |
原 Table 2 · horse → zebra
| 方法 / 配置 | CLIP-Acc ↑ | BG LPIPS ↓ | Structure Dist ↓ |
|---|---|---|---|
| A · DDPM / word swap | 93.2% | 0.389 | 0.167 |
| B · DDIM / word swap | 94.0%次优 | 0.283 | 0.123 |
| C · DDIM+Lauto / word swap | 94.0%次优 | 0.281次优 | 0.122次优 |
| D · DDIM+Lauto / sentence directions | 97.6%最优 | 0.290 | 0.130 |
| E · D+Lxa / ours | 75.2% | 0.194最优 | 0.066最优 |
原 Table 2 · cat → cat w/ glasses
| 方法 / 配置 | CLIP-Acc ↑ | Structure Dist ↓ |
|---|---|---|
| A · DDPM / word swap | 35.2% | 0.122 |
| B · DDIM / word swap | 37.6% | 0.085次优 |
| C · DDIM+Lauto / word swap | 38.0%次优 | 0.087 |
| D · DDIM+Lauto / sentence directions | 20.8% | 0.103 |
| E · D+Lxa / ours | 71.2%最优 | 0.028最优 |
原 Table 2 · sketch → oil pastel
| 方法 / 配置 | CLIP-Acc ↑ | Structure Dist ↓ |
|---|---|---|
| A · DDPM / word swap | 55.2% | 0.114 |
| B · DDIM / word swap | 32.4% | 0.082次优 |
| C · DDIM+Lauto / word swap | 35.2% | 0.082次优 |
| D · DDIM+Lauto / sentence directions | 88.4%最优 | 0.087 |
| E · D+Lxa / ours | 75.2%次优 | 0.052最优 |
A 为随机 DDPM inversion+词替换;B 换确定性 DDIM;C 在 B 上增加噪声正则;D 使用句子方向;E 加 attention guidance。A 与主表 SDEdit 不是同一设置:前者消融用 DDPM inversion,不能把 71.6% 与主表 71.2% 当抄写误差。B 与主表 DDIM 行一致。
A→B:所有任务的结构距离与有报告的背景误差下降,但 sketch→oil pastel 的编辑准确率从 55.2% 降为 32.4%。确定性保留结构同时可能削弱改变,不能说所有评价都改善。
B→C:猫狗准确率 72.0→72.4、眼镜 37.6→38.0、草图 32.4→35.2;马斑马仍 94.0。猫狗背景误差 0.279→0.283、结构 0.087→0.089 略变差;正则的作用在此规模下较小,缺少方差无法判断微小差异显著性。
C→D:猫狗 72.4→100.0,马斑马 94.0→97.6,草图 35.2→88.4,但眼镜 38.0→20.8;各结构指标变差。平均语义方向扩大了编辑能力,也可能连带改变太多或者未对齐局部属性。
D→E:猫狗准确率 100.0→92.4,马斑马 97.6→75.2,草图 88.4→75.2;结构距离分别 0.095→0.044、0.130→0.066、0.087→0.052。眼镜同时从 20.8→71.2,结构 0.103→0.028。由此可见 attention 既能约束全局变化,也可能帮助局部属性落到正确位置,效果与任务交互。
增量式消融没有枚举所有组件组合,不能单独识别“句库效果”和“attention 效果”在任意配置下的因果作用;也没有正则权重、attention 权重、多随机种子的全面扫描。更严谨的机制验证应画出成功率–结构保留的 Pareto 曲线,而不是只选完整方法的一个 operating point。Table 2
13 · 快速 GAN:需要单独训练的支线
慢扩散编辑器作为 teacher,先产生 15,000 对输入/编辑图像,再筛掉目标变化不足或结构不匹配的 pairs。cat→dog 使用 segmentation overlap 阈值 0.70 与 CLIP similarity increase 阈值 0.10;tree→winter/fall 仅用 CLIP 增量阈值 0.1,因为通用分割器不可靠地分割树。附录没有给出过滤后剩余对数、每任务 exact split 与所有样本标识。
使用 CoModGAN 做条件图像转换,learning rate 0.001、batch size 64,增强含 brightness、contrast、hue、saturation、加噪与 random crop。重建项结合 L1 和 VGG-based LPIPS。虽然模型基于 GAN,附录未完整列出 adversarial loss 权重、优化器细节、训练步数/时间、EMA 和学习率调度;不能自行用上游默认当论文明确设置。
\[\mathcal L_{\mathrm{recon}}(G)=\lambda_1\|G(I)-I_{\mathrm{teacher}}\|_1+\lambda_{\mathrm{perc}}\mathrm{LPIPS}_{\mathrm{VGG}}\!\left(G(I),I_{\mathrm{teacher}}\right).\]
Our Interpretation 上式展开已公开的两类重建项,并保留未给出的权重符号,不是论文完整 GAN 训练目标。学生在特定任务上学直接映射,新增任意任务仍需生成新 pairs 并训练,不能把它的 0.018 秒性能套在任意在线新方向上。
作者在 NVIDIA A100、PyTorch 上报告每图 0.018 秒、约 3800×加速。按这两个数反算慢路线约 68.4 秒,只是近似算术,原文没有给完整测时拆解;不能直接称为另一个独立精确 benchmark。数据生成、过滤与训练成本不含在单图推理时间内。Fig.7、10、11 展示 tree→winter/fall 的定性接近,主表未给 student/teacher 的完整同协议量化。
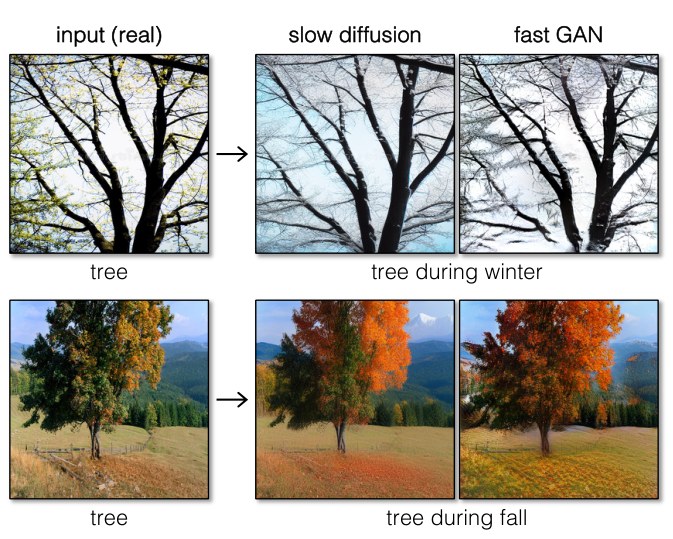
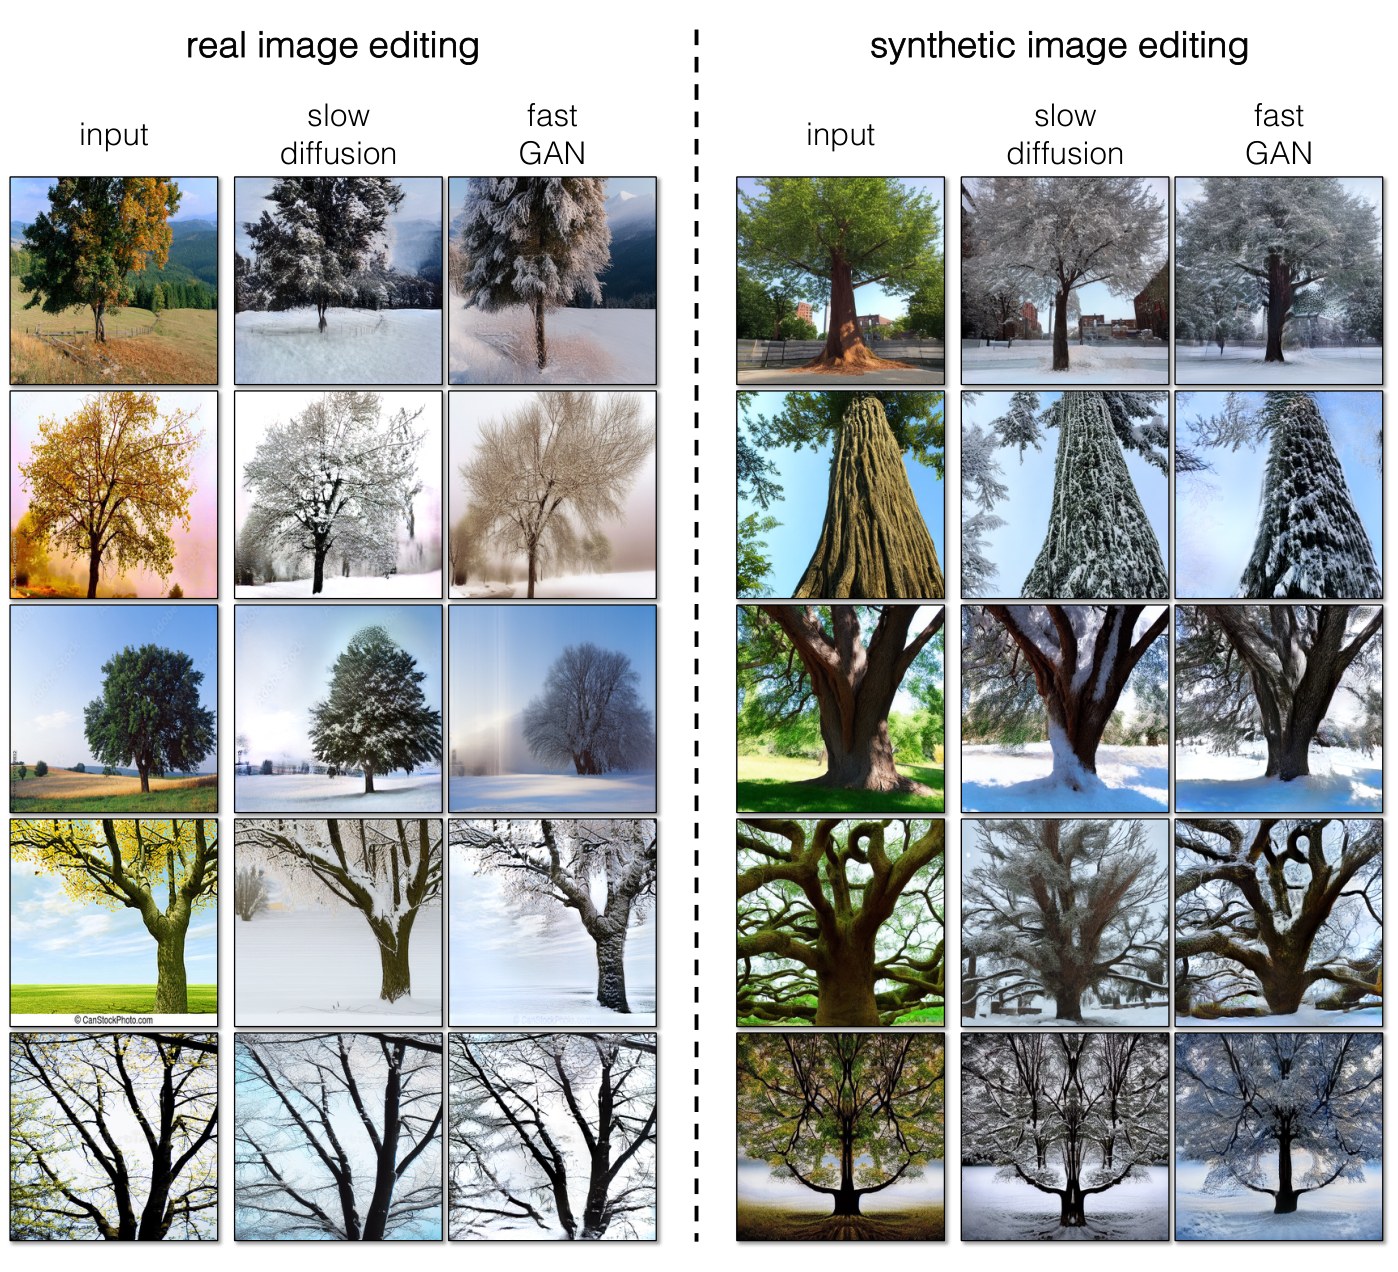
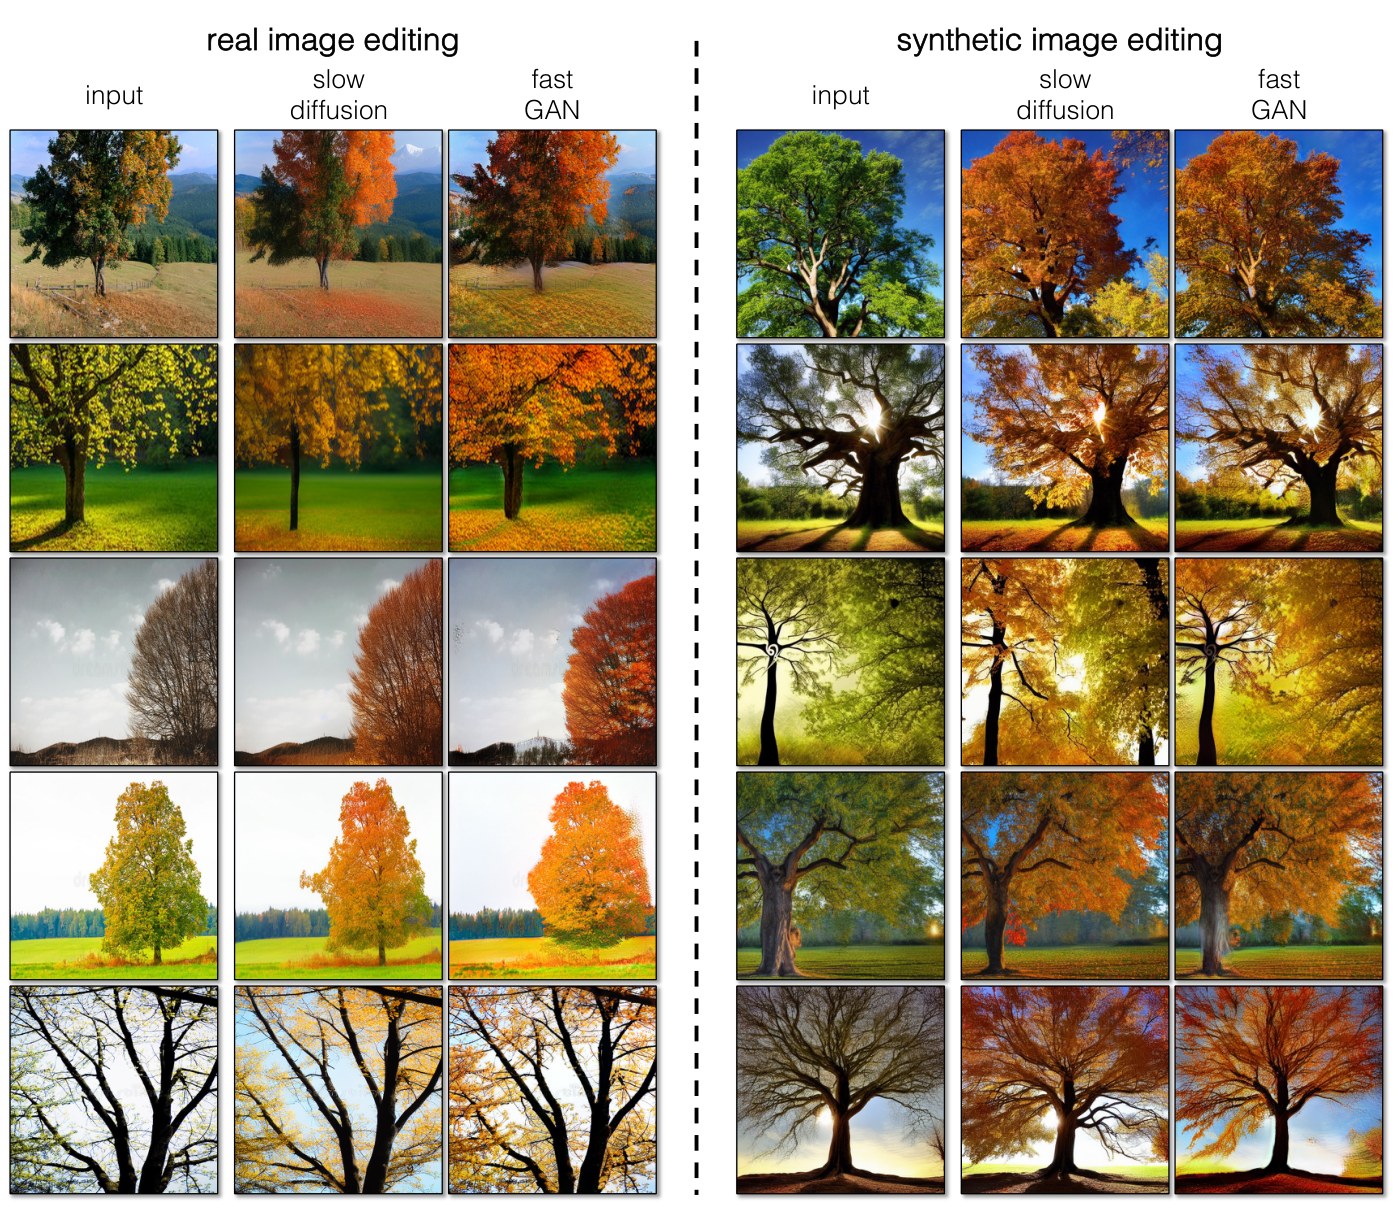
Teacher 的失败可通过合成数据传递给 student,过滤会偏向易编辑样本;树任务不用 segmentation filter 又改变了数据质量选择机制。因此需要区分速度收益、质量折损、任务专用性和离线成本。附录 A
14 · 官方代码审计:论文结果不等于当前默认
核查官方仓库固定提交 16e5c1dd4b51731d3d66b2b85c8d6c842639e4cf。README 明确说明这是基于 diffusers 的作者 reimplementation,论文结果来自 CompVis 版本,不能声称当前脚本即逐字复现原论文。仓库含真实/合成编辑、反演与方向脚本、测试图和四个概念 embedding 文件;本次只读源码,不安装依赖、不下载权重、不执行模型。
| 项目 | 论文 / 附录 | 固定官方代码 |
|---|---|---|
| 步数 | 反演、重建、编辑各 100 | CLI 默认各 50;复现实验需显式改配置 |
| CFG | 使用 CFG,未明确数值 | 反演入口传 1;编辑 CLI 默认 5.0;pipeline 签名默认 7.5 被 CLI 覆盖 |
| Attention 强度 | 以 \(\lambda_{\mathrm{xa}}\) 表示 | 真实图默认 0.1;合成图 0.15;每步 SGD 更新 latent |
| Noise regularization | 5 次迭代;金字塔 pooling 后×2 | 5 外层×5 roll;ac/kl 各 20;pooling 后没有×2 |
| Attention loss | Eq.(5) 为 L2 范数 | 跨 attn2 层累计平方差,空间/token 求和、头/批平均 |
| Caption | BLIP | LAVIS blip_caption / base_coco;不是 CLIP image captioning |
| 方向 | GPT-3 或模板,均值差 | 脚本读取句子文件;README 建议约 1000 句;缓存到本地 embedding 路径 |
| 依赖 | 论文 CompVis 实验 | environment.yml 固定 CUDA 11.6,但 diffusers、transformers、torch 等缺少完整版本锁 |
README 还记录过random roll 有时未应用的 inversion 实现问题并链接修复后的文件。当前代码每层从非零范围抽 roll;复现应锁定 commit,并明确使用修复前还是修复后算法。不能在没有运行比较时声称这一修复造成某个具体分数变化。
代码细节也提示适用边界:auto-correlation 断言 batch=1;方向 parser 用字面字符“2”拆任务名并从固定 SD1.4 路径载入;编辑方向只加到 prompt embedding 的第二条,latent 之后按两份 CFG 分支拆分。这个路径面向单张、CFG 双分支用法,不能假定任意 batch 或 CFG≤1 同样可用。U-Net 部分 attn2 参数打开 requires_grad 是为了图中求导,optimizer 只包含 latent,因此不是权重微调。
VAE 在反演代码中从 posterior sample,并用 0.18215 缩放;还有随机 roll。因此“DDIM 确定性”不意味着整个含 VAE sample/正则的实现跨运行无需 seed 即完全确定。方向脚本用字符串 strip 处理文件后缀而非严格去 suffix,复现时应检查保存文件名。以上是静态审计发现,未宣称实测触发错误或安全问题。反演 · 编辑 · 官方说明
15 · 全部定性证据、附录与失败模式
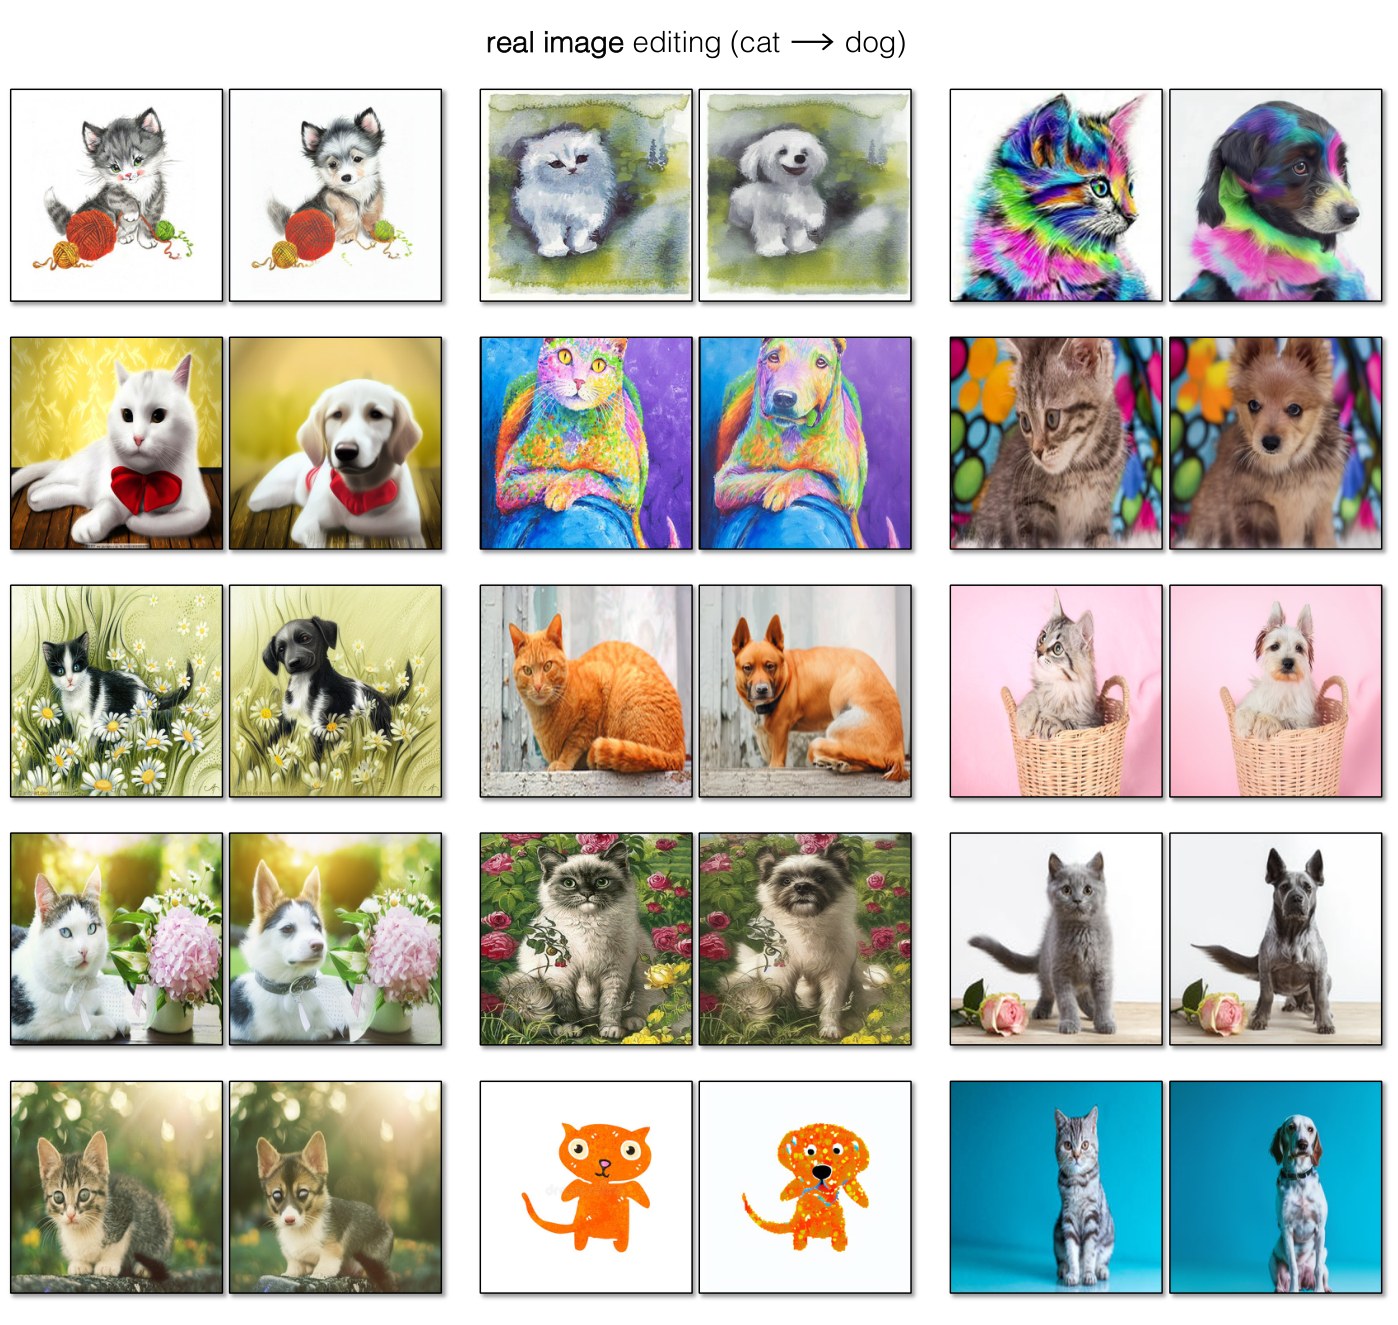
Fig.4 展示真实与合成输入的物体、动作、局部属性和全局风格变化,说明接口覆盖面;Fig.13–16 分别给真实 cat→dog、dog→cat、horse→zebra、zebra→horse 的更多结果。所有原图保留,不能只选成功缩略图;它们没有额外定量表,不应把展示数量当独立成功率。
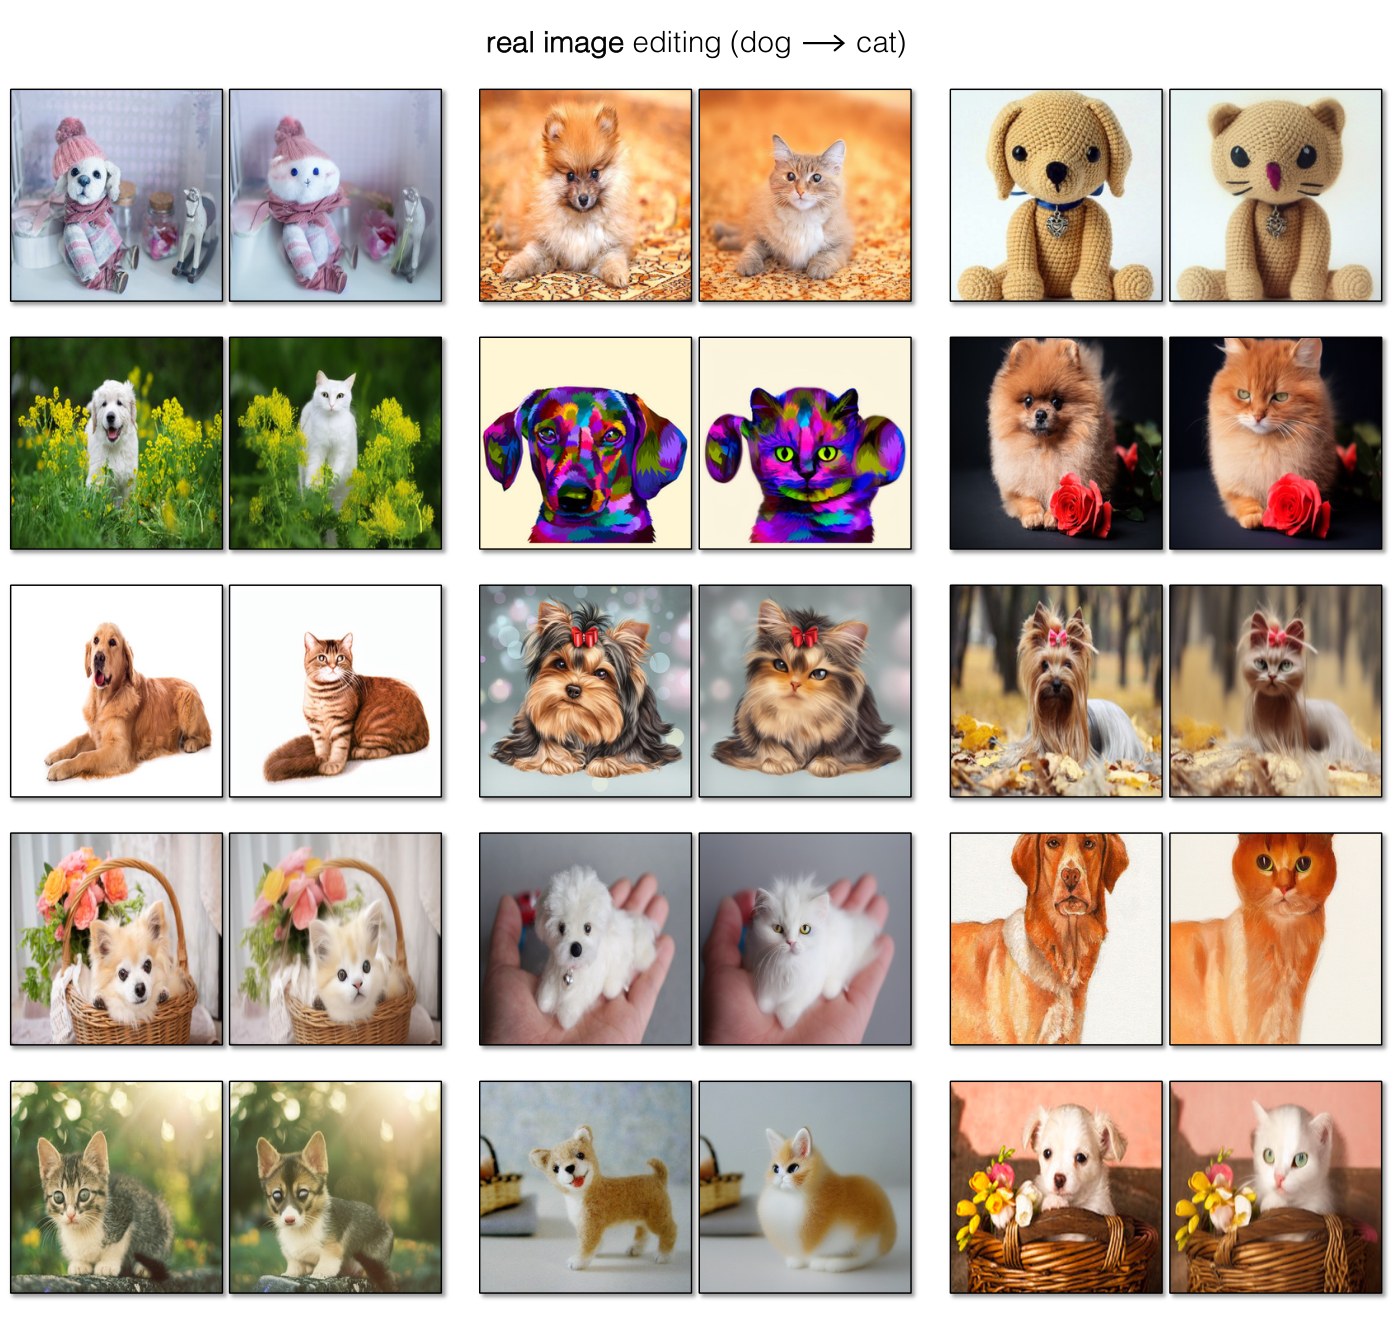
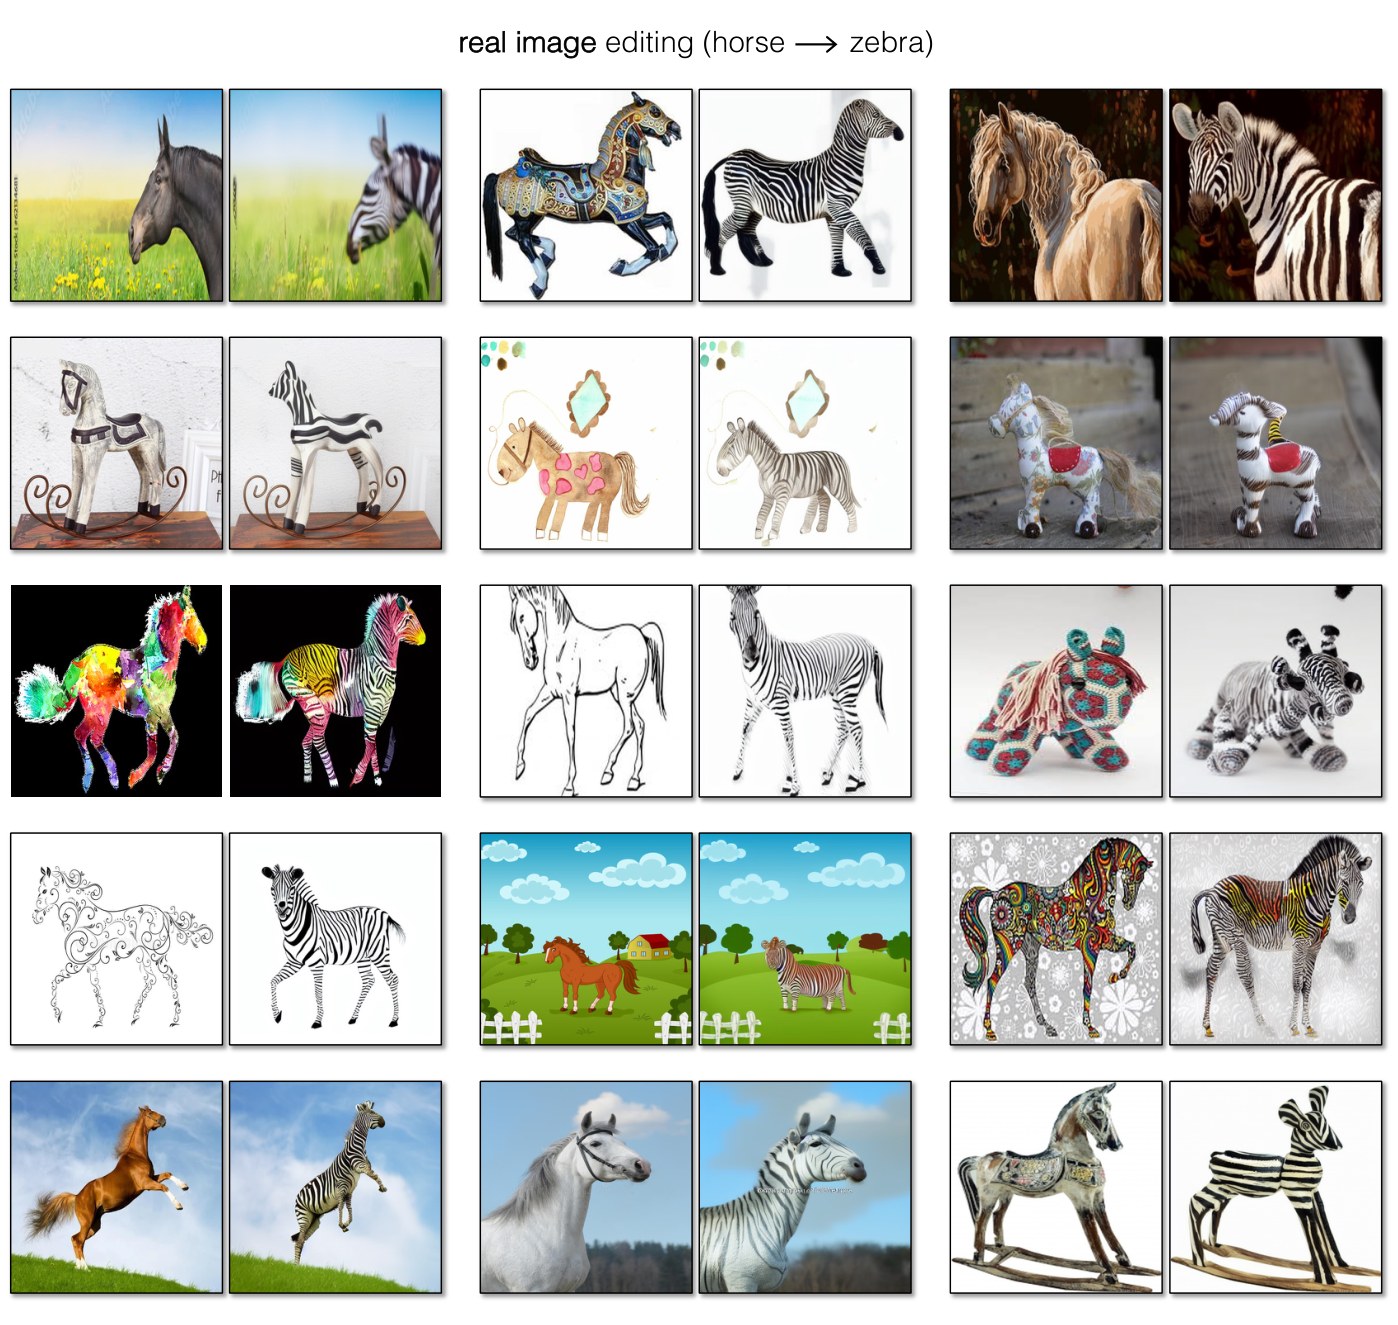
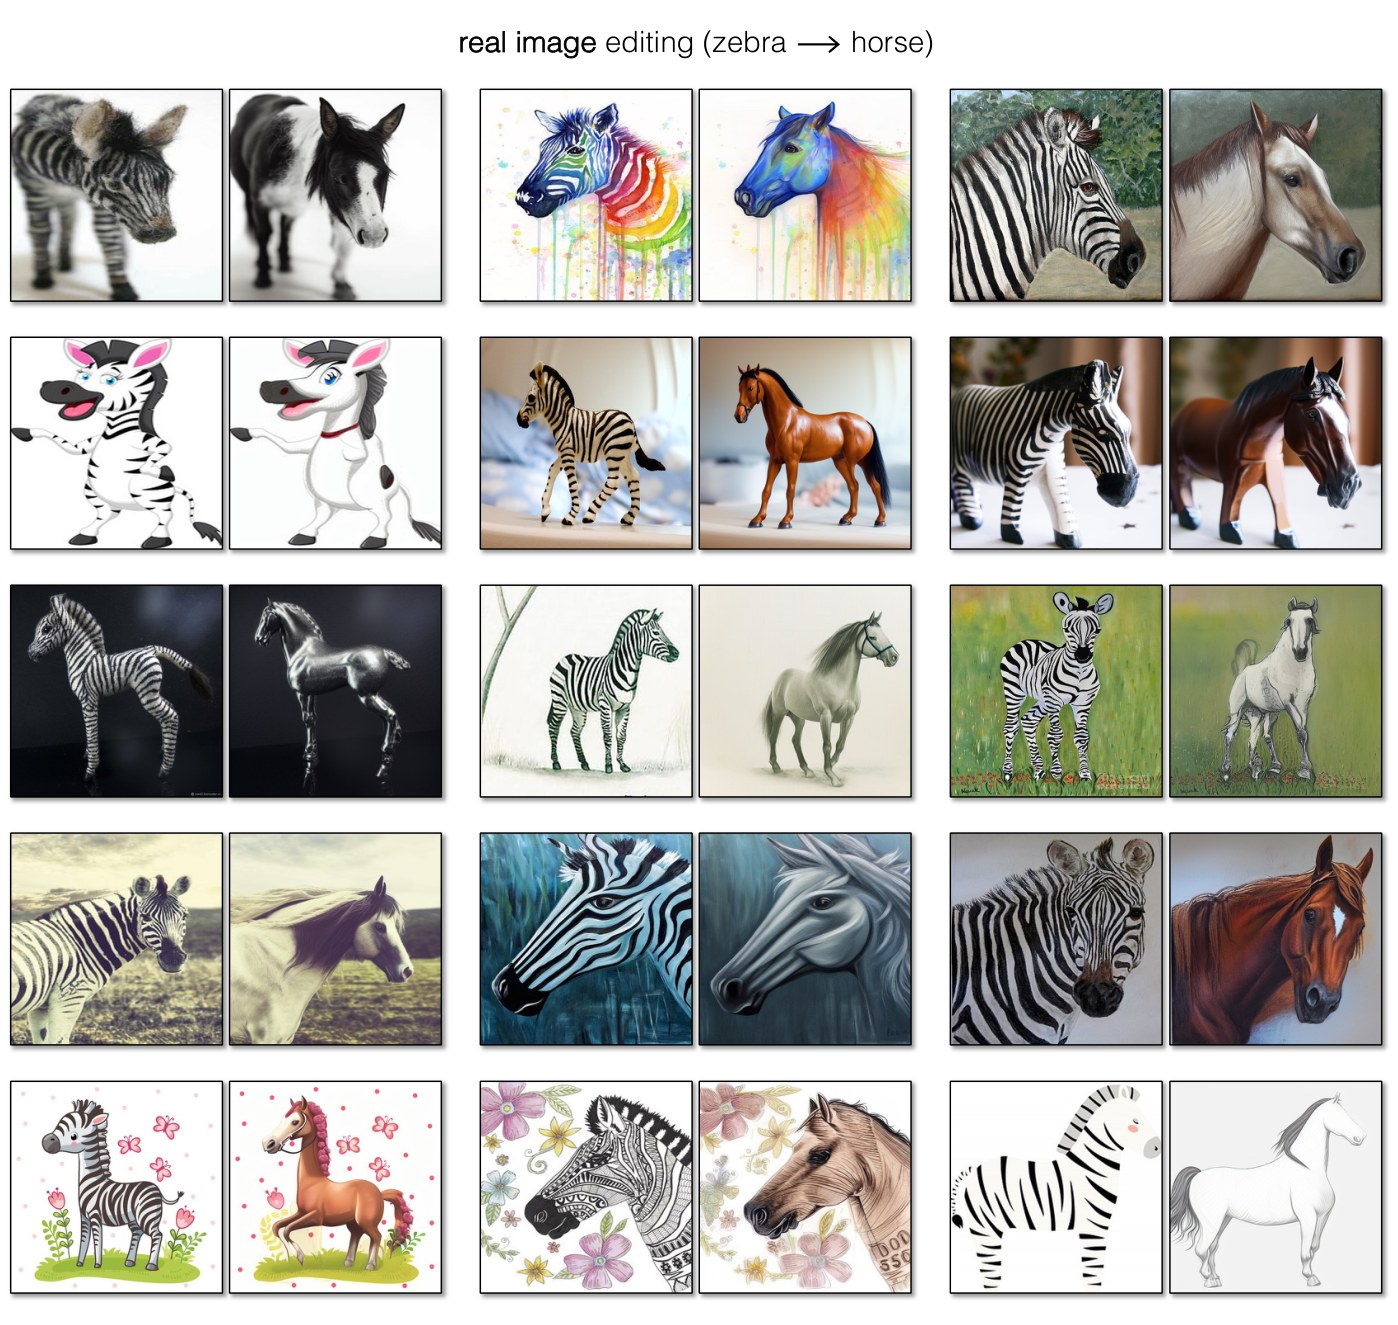
失败图是方法边界,不是装饰
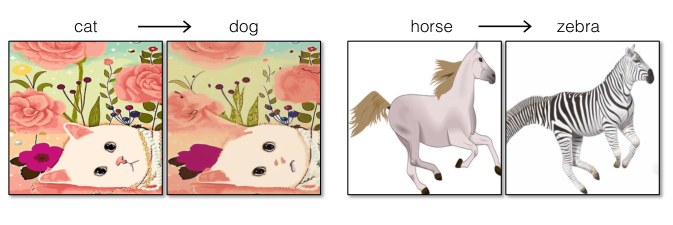
Fig.8 给出 atypical pose 的猫与未保留好腿、尾巴细节的斑马。论文把限制联系到低分辨率 cross-attention,提到 SD 的 64×64 空间尺度;实际 U-Net 有多分辨率层,不能据此说每层都是 64²。更高分辨率可能有益是作者推测,本文没有用高分辨率 backbone 作受控验证。
附录 B 给出合成图基线比较;C 讨论 noise regularization 在小规模 LSUN bedroom 模型上更明显;D 披露检索数据与 100 步、5 次正则等设置;E 讨论生成编辑被用于造假、以及已有检测工作。检测技术存在不意味着所有本文编辑一定可检测,更不保证未来检测稳健。面向研究应保留来源、编辑记录与合成标识,尤其避免把生成图当未修改的事实证据。
16 · Reviewer:贡献、证据缺口与复现优先级
真正成立的贡献
- 将可复用语义方向与逐图结构参照分开,减少逐图精细 prompt 编写;不必为每个新方向重训 SD。
- attention 软损失代替直接锁死 reference attention,在保持结构与目标变化间提供一个可调整的方式。
- 把真实图反演可编辑性作为独立问题,用多尺度噪声正则处理,附录交代了训练小模型的额外观察。
- 原表允许看到语义准确率和结构保留的冲突;蒸馏支线展示慢编辑器作为成对数据生成器的潜力。
主要不足
- 测试只有四任务、各 250 个筛选样本,欠缺多物体组合、精细身份保持、强遮挡与稀有姿态的系统压力测试。
- CLIP 参与检索、方向编码与评价,可能偏向同一语义表示;缺少独立人工盲评和更严格局部编辑评价。
- 论文主张有时概括过强:马斑马准确率不是最高;多句方向与正则不是每项指标单调有益。
- 未报告 seeds/方差与完全配置;公开 reimplementation 的 50步、pooling、loss 标度与论文不同。
- attention 不提供显式几何、遮挡或物理约束;小尺度细节、异常姿态和所需结构变化仍困难。
- GAN 速度与通用性不可同时无条件继承;训练成本与过滤后的数据规模缺少完整报告。
最小复现实验
- 锁定 SD1.4、tokenizer、VAE 与代码提交、依赖版本;明确选择论文 100步还是代码 50步。
- 保存输入、BLIP caption、方向句库、全部种子;分别输出 VAE 重建、DDIM 重建与编辑。
- 先复现 B/C/D/E 四配置并记录全部任务,特别保留 horse→zebra 的准确率下降。
- 对 attention 强度作等预算 sweep,画结构距离/背景误差/语义准确率曲线;同时计时和报告显存。
- 隔离 pooling×2、norm 对 squared-norm、反演 endpoints 等实现差异,避免一起改后无法归因。
- GAN 支线单列过滤前/后样本数、训练时间、student–teacher指标差异与未见任务适用性。
17 · 材质与程序生成:可借鉴什么,不能直接迁移什么
Research Extension · 以下均为研究设想,并非本文已验证。 将“保留结构、改变外观”迁移到材质编辑时,不能只拿最终 RGB attention 当几何真值。材质有 albedo/roughness/metallic/normal 多通道,光照改变可模拟材质改变,普通单视图图像编辑还可能把高光烘进颜色。
一:多视图一致的结构参照
对固定 mesh 多视图渲染,缓存与部件/几何相匹配的条件;编辑过程同时约束法线/深度对齐和跨视图表面点一致性。对比原 attention-only、geometry-only、联合约束,报告局部纹理忠实度、接缝、跨视图误差与人类偏好。需要等渲染调用预算,防止额外计算掩盖方法收益。
二:让语义方向作用在可执行图而非最终图片
程序材质输入为图 \(G\) 与连续参数 \(\eta\)。方向可作为目标外观描述,而离散图结构应通过合法性约束搜索;连续参数用可微 renderer 优化。必须记录节点类型、连边、编译错误、执行结果和输出通道,不能把 RGB 看起来变化就称为可编辑 shader 已完成。
\[\min_{G,\eta}\mathcal L_{\mathrm{edit}}(R(G,\eta),q_t)+\lambda_{\mathrm{keep}}\mathcal L_{\mathrm{structure}}+\lambda_{\mathrm{phys}}\mathcal L_{\mathrm{multi\text{-}light}}+\lambda_{\mathrm{size}}|G|,\qquad G\in\mathcal G_{\mathrm{valid}}.\]
这是新任务提案,不是 pix2pix-zero 的原目标。关键实验应区分“改变颜色”与“改变粗糙度”,并用不同 HDR 重新渲染验证,而非仅在一个光照下比较 CLIP。图复杂度约束防止用一个巨大 bitmap 节点伪装程序化生成。
三:方向与结构约束的可解释选择
把表 2 的反例作为开发测试:目标若要求动作/轮廓变化,原结构不该被一律固定;目标若只加眼镜,则背景与身份应强约束。可设计区域/层/时间步自适应 guidance,但须用固定 baseline sweep 对照,避免把任务特定手工调参当成自动泛化。
四:可靠的教师数据生产
在蒸馏前用多种独立信号筛选:编辑成功、身份/结构保留、物理通道一致性、图合法性。公布过滤造成的分布偏差与困难样本留存率。图像分类 CLIP 增量不应是唯一质量关,正如本文马斑马高准确率不等于更好受控编辑。
18 · 来源、交付与未解决项
静态验收检查文件体积、全部表值、图像解码、数学分隔符与导航;浏览器、MathJax 运行时、响应式视觉验收按本批次要求延后。本次没有运行作者模型、安装代码或下载权重,没有修改原始 vault、共享索引或部署网站。正式 DOI 已由 ACM 的 Crossref 记录核实;原 frontmatter 逐字保留,在归档建议中补充;通讯作者候选仍 unverified。归档仅交付候选 Markdown 与计划。