利用现成 CLIP / LiT 的图文对齐能力,在随机相机下约束同一个场
01 · 核心判断与来源边界
Dream Fields 把冻结图文模型的语义梯度转成三维密度与颜色,但真正让它形成物体的是几何先验与随机背景的联合作用。它没有训练通用 text-to-3D 网络;每个新提示词都从头优化一个小型 NeRF。输出是连续体积场,而不是直接预测干净拓扑、UV 与 PBR 材质的 mesh。
153 条 Object Centric COCO 测试描述,每条两个种子,主表 10K 步
累计加入场景边界时的 CLIP B/32 检索精度;跟踪中心后为 59.8%,不能把前者冒充最终全部组件
依据固定 CVPR 2022 PDF,印刷页 867–876,共 10 页;作者 Ajay Jain、Ben Mildenhall、Jonathan T. Barron、Pieter Abbeel、Ben Poole。首页明确通讯 Ajay Jain。另读 CVF 官方 supplemental 合订本 13 页,其中前 10 页是主文,只有后 3 页为附录 A–F。公开 arXiv 文件与用户固定 PDF 字节不符,未替换。正文页码和原笔记 PDF++ 锚点均以用户版本为准。
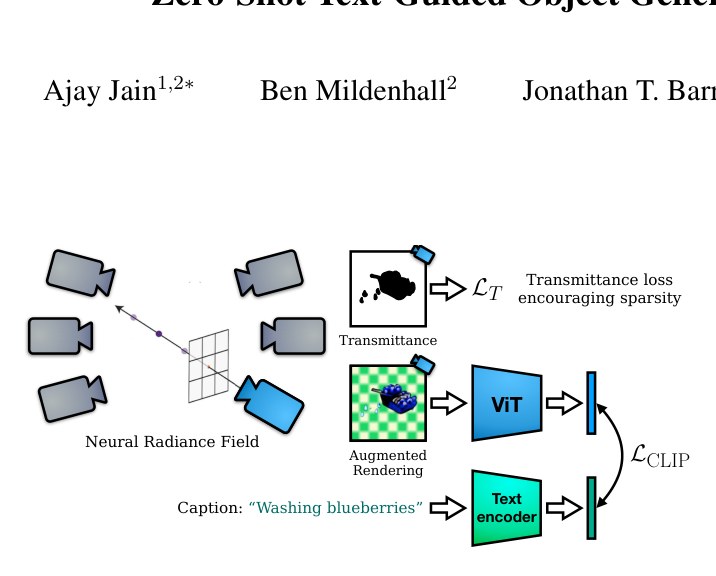
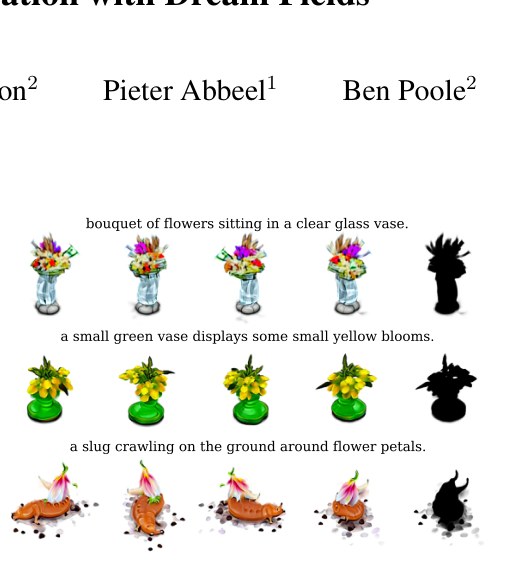
Figure 1 的梯度链是「MLP → 体渲染 → 冻结 image encoder → 图文相似度」,而 text encoder 提供目标向量。Figure 2 的多视角与透射率展示的是同一场的一致投影,并不能单凭四张图证明物理正确或无多面重复纹理。
02 · 为什么文本与 NeRF 之间还缺一层约束
ShapeNet 式生成方法通常依赖有限类别的三维训练集,无法直接覆盖“牛油果形状的扶手椅”之类组合。NeRF 不预先规定拓扑,便于优化,但标准训练依赖同一场景真实多视角照片。只有文本时,这种灵活性会变成漏洞:网络可以制造前景遮挡、半透明悬浮云或铺满视口的纹理来提高 CLIP 分数。
作者的假设是:同一物体的不同视角应与同一描述匹配;从完整方位角采样,可把二维语义变成三维约束。然而这只是软约束,不保证正确解。CLIP 对类别、颜色和纹理敏感,对空间关系、计数、物理几何与前后身份的约束较弱,所以还需要将密度限制在有界、稀疏、连贯的物体区域。
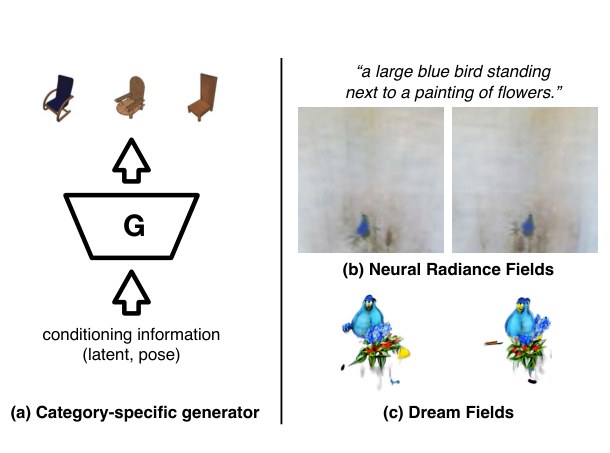
研究定位:与 Text2Shape、CLIP-Forge 的类别受限三维监督不同;与仅修改现有 SMPL / SDF / mesh 的方法不同;与早期 CLIP-guided 二维图像优化不同。该论文是 CLIP 引导场优化,不是 diffusion 或 SDS 方法。原笔记中的 diffusion topics 与论文方法不一致,应在归档时审查,而非静默篡改旧记录。
03 · 输入、表示与全部核心公式
输入是文本 \(y\)。每次随机采样相机 \(p\),可训练变量只有场参数 \(\theta\);图像编码器 \(g\)、文字编码器 \(h\) 冻结。三维点 \(\mathbf{x}\) 输入 MLP,输出密度 \(\sigma_{\theta}(\mathbf{x})\) 与颜色 \(\mathbf{c}_{\theta}(\mathbf{x})\)。该实现不输入观察方向,因此同一点的颜色与视角无关,不等同于可重新打光的 BRDF。
体渲染:原式 (1)–(4)
\[ C(\mathbf{r},\theta)=\int_{t_n}^{t_f}T(\mathbf{r},\theta,t)\sigma_{\theta}(\mathbf{r}(t))\mathbf{c}_{\theta}(\mathbf{r}(t))\,dt \tag{1}\]
\[ T(\mathbf{r},\theta,t)=\exp\!\left[-\int_{t_n}^{t}\sigma_{\theta}(\mathbf{r}(s))\,ds\right] \tag{2}\]
\(\mathbf{r}(t)\) 为像素射线,\(t_n,t_f\) 为近远平面;\(T\) 是光线抵达当前位置而未被吸收的概率。密度大则遮挡强。将颜色按“能到达此处 × 在此处吸收”权重积分即可得到像素。
\[ C(\mathbf{r},\theta)\approx\sum_i T_i\bigl(1-\exp[-\sigma_{\theta}(\mathbf{r}(t_i))\delta_i]\bigr)\mathbf{c}_{\theta}(\mathbf{r}(t_i)) \tag{3}\]
\[ T_i=\exp\!\left[-\sum_{j\lt i}\sigma_{\theta}(\mathbf{r}(t_j))\delta_j\right],\qquad\delta_i=t_i-t_{i-1} \tag{4}\]
按原文分段记号转写;实际复现须统一采样点和区间索引,避免近远边界的 off-by-one。训练每条射线 192 个近均匀、带抖动样本;测试 512 个。由所有像素得到图像 \(I(\theta,p)\) 与剩余透射率图 \(T(\theta,p)\)。
坐标编码:原式 (5)–(6)
\[ \gamma(\mathbf{x})=[\cos(2^l\mathbf{x}),\sin(2^l\mathbf{x})]_{l=0}^{L-1} \tag{5}\]
\[ \boldsymbol{\omega}=2^u\mathbf{d},\quad u\sim\mathcal{U}[0,L],\quad\mathbf{d}\sim\mathcal{U}(\mathbb{S}^{2}) \tag{6}\]
式 (5) 是标准坐标编码背景;实际将 mip-NeRF 的 integrated positional encoding 与式 (6) 的随机方向 Fourier 基结合。随机方向减少轴向条纹偏置,IPE 缓和 aliasing;附录默认 \(L=8\),低频消融 \(L=6\),照片拟合常用 \(L=10\)。频率提高不必然提高语义检索精度。
语义目标与稀疏性:原式 (7)–(9)
\[ \mathcal{L}_{\mathrm{CLIP}}(\theta,p,y)=-g(I(\theta,p))^{\mathsf T}h(y) \tag{7}\]
归一化向量的点积是余弦相似度;负号使最小化等于提高匹配。梯度通过图像编码器回传,但编码器权重不更新。我们可将完整流程概括为随机相机与增强上的期望最小化;这只是整理表达,不是原文新增概率生成模型。
\[ \mathcal{L}_{T}=-\min\{\tau,\operatorname{mean}[T(\theta,p)]\} \tag{8}\]
\[ \mathcal{L}_{\mathrm{total}}=\mathcal{L}_{\mathrm{CLIP}}+\lambda\mathcal{L}_{T} \tag{9}\]
\(\tau\) 为目标平均透明度,\(\lambda\) 为权重。未达到目标时,提高透射率可减小损失;超过阈值后该项梯度为零,避免无止境推向空场。默认 \(\tau=0.88\),前 500 步由 0.40 退火。直接从高透明度开始容易学成全透明。原文还给出保持投影面积的缩放关系 \(1-\tau\propto f^2/d^2\),其中 \(f\) 是焦距,\(d\) 是相机距离。
正则比较:原式 (10)–(11)
\[ \mathcal{L}_{\mathrm{total}}^{\mathrm{beta}}=\mathcal{L}_{\mathrm{CLIP}}+\lambda\,\operatorname{mean}\{\log T+\log(1-T)\} \tag{10}\]
\[ \mathcal{L}_{\mathrm{total}}=\min\{\tau,\operatorname{mean}(T)\}\mathcal{L}_{\mathrm{CLIP}} \tag{11}\]
Beta prior 同时偏好完全透明和完全不透明,可能把整个场景填满。乘法 gated loss 将稀疏梯度与 CLIP 当前值绑定,优化较敏感;加法形式将两目标解耦。附录 Figure 11 所说“convex”只针对固定 CLIP 值时对平均透射率的标量函数,绝不是整个神经场优化凸。
04 · 从提示词到物体:每一步为何必要
- 文本目标:对输入描述求冻结文字向量;各视角使用相同描述。没有 LLM 提示模板、token 解码或 beam search。
- 初始化:每条描述和每个种子新建 MLP;无预训练三维生成器。Flax 默认 LeCun normal 权重、线性层零偏置,LayerNorm 单位缩放与零偏置。
- 相机:方位角在 360° 均匀采样,训练仰角固定 30°,距离 4,立方体边长 2。正文说明焦距乘 1.2 以放大物体。
- 渲染与增强:192 样本/射线,输出 RGB 和透射率,将随机背景透过空区域合成,再裁剪、上采样并送 CLIP。
- 反向传播:计算式 (7) 和 (8),以 Adam 更新 MLP。冻结编码器保留可微计算图。
- 重定位与边界:以渲染密度质心的 EMA 跟踪原点,移动射线;立方体外密度直接掩掉,限制模型把语义密度藏在远处。
- 输出:优化后的场可从任意相机渲染。测试使用白背景,更密集采样。mesh 提取、重拓扑、UV 与材质分解并非本文完整交付链。
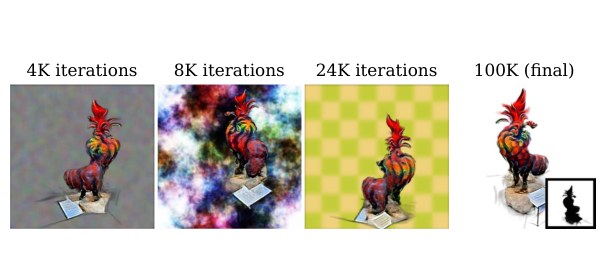
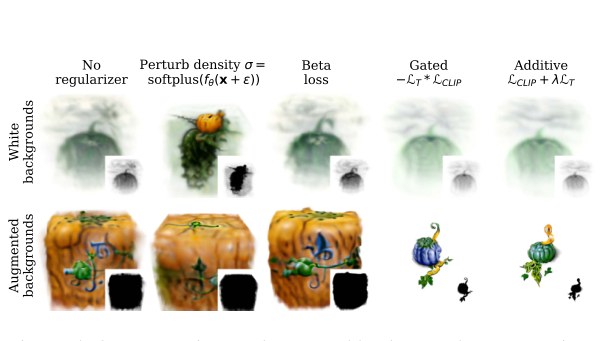
随机背景有三个家族:Gaussian noise、checkerboard、随机 Fourier texture,均可用随机标准差的高斯模糊。单用透明正则会留下低密度纹理;单用随机背景会促使 CLIP 用不透明内容遮住杂乱背景。两者竞争,才倾向有限的实心前景。Figure 5 是最直观的机制证据。
MLP 的具体归纳偏置
标准 NeRF 为 8 层恒宽密度 MLP 加两层颜色分支。本文改成每两层一组 residual block,在块入口使用 LayerNorm,采用瓶颈式特征维度变化,Swish 替代 ReLU,密度用 softplus。正文报告 280K 参数/场,而 NeRF 为 494K。该组合改造有消融,但没有分别隔离 residual、normalization、activation 的单独贡献。
可复现缺口:主文与已获取附录未给出完整每层宽度、所有正则权重、Adam 的全部配置或每个可视化结果的完整种子。本文不伪造这些值,也未执行作者仓库来补全。
05 · 数据、训练与推理设置
| 项目 | 原文设置 | 边界 / 复現注意 |
|---|---|---|
| 数据 | Object Centric COCO:153 测试描述、74 开发描述;通常在开发集中 20 条上调参 | 原 COCO 图像有单个 bbox,过滤 extreme close up 等;5 条 caption 只取 1 条 |
| 主表规模 | 153 × 2 seeds = 306 个对象,10K steps | 正则专门消融 Table 2 只跑每 caption 1 seed,即 153 个 |
| 优化器 | Adam,epsilon \(10^{-5}\);学习率由 \(10^{-5}\) 指数 warmup 到 \(10^{-4}\),1500 步后固定 | 这是单场优化,无跨对象训练 epoch;不要写成 dataset training |
| 几何 | 边长 2 的立方体、半径 4、仰角 30°,近远平面 \(4\pm\sqrt{3}\),原点 EMA decay 0.999 | 测试仰角 45°,与训练不同 |
| 分辨率 | 指标实验 168² → crop 154² → CLIP 224²;高质量图 252² → crop 224² | LiT 输入 288²;测试指标按编码器尺寸渲染,展示 400² |
| 射线采样 | 训练 192、测试 512 | 近均匀样本加随机抖动 |
| 基础编码器 | CLIP ViT B/16 优化;B/32 与 LiTuu B/32 检索 | CLIP 400M 图文、224²;评测不能只用训练同一个编码器 |
| 扩展配置 | LiTuu ViT B/32:3.6B 图文、288²;20K、252² 扩展行 | uu 表示图像与文本编码器从头联合对比训练;不要误写成锁定视觉编码器 |
| 代价 | 8 preemptible TPU cores,10K 约 1 小时 12 分钟 | 作者当年估计单场 3–4 美元;不是当前云价。瓶颈是场 MLP 渲染与回传 |
主文 §§5.1–5.2;官方附录 B–C。附录明确 74 开发 caption 与测试独立;主文 wording 较简略,以附录澄清,不能推断在 153 测试集上调参。
06 · 三张原表完整重建
原 Table 1:累计加入组件,R-Precision 越高越好
| 阶段 / 方法 | CLIP B/32 | LiTuu B/32 |
|---|---|---|
| COCO GT images | 77.1 ± 3.4 | 75.2 ± 3.5 |
| Simplified NeRF | 31.4 ± 2.7 | 10.8 ± 1.8 |
| + mip-NeRF IPE | 29.7 ± 2.6 | 12.4 ± 1.9 |
| + Higher freq. Fourier features | 24.2 ± 2.5 | 10.5 ± 1.8 |
| + random crops | 25.8 ± 2.5 | 10.5 ± 1.8 |
| + transmittance loss | 23.7 ± 2.4 | 7.6 ± 1.5 |
| + background aug. | 44.1 ± 2.8 | 26.1 ± 2.5 |
| + MLP architecture | 52.0 ± 2.9 | 27.8 ± 2.6 |
| + scene bounds | 65.4 ± 2.7 | 38.9 ± 2.8 |
| + track origin | 59.8 ± 2.8 | 34.6 ± 2.7 |
| + LiTuu ViT B/32 | 59.5 ± 2.8 | — |
| + 20K iterations, 252² renders | 68.3 ± 2.7 | — |
计算解读:背景增强相对紧邻前行是 +20.4 / +18.5 个百分点;若对比“random crops”行则 +18.3 / +15.6,接近正文的 +18% / +15.6%。必须写清比较基线。场边界相对 MLP 为 +13.4 / +11.1;跟踪中心反而 −5.6 / −4.3。这不是“每一个先验都提高指标”的证据。
表是累计消融,组件交互与加入顺序混杂;不能把每行差值解释成该组件独立因果效果。扩展行同时改变编码器、迭代次数、渲染尺寸,不能单独归因于预训练数据扩大。
原 Table 2:稀疏正则,153 个对象
| 方法 | Loss / parameterization | R-Precision |
|---|---|---|
| No regularizer | \(\mathcal{L}_{\mathrm{CLIP}}\) | 35.3 |
| Perturb density | \(\sigma=\operatorname{softplus}(f_{\theta}(\mathbf{x})+\epsilon)\) | 47.7 |
| Beta prior | 式 (10) | 50.3 |
| Gated T | \(-\operatorname{mean}(T)\mathcal{L}_{\mathrm{CLIP}}\)(原表记法) | 34.6 |
| Clipped gated T | \(-\mathcal{L}_{T}\mathcal{L}_{\mathrm{CLIP}}\),式 (11) | 62.1 |
| Clipped additive T | \(\mathcal{L}_{\mathrm{CLIP}}+\lambda\mathcal{L}_{T}\) | 62.1 |
全部使用 LiTuu B/32 引导、168²、10K 步、随机背景,CLIP B/32 检索。clipped 两种方法都比无正则高 26.8 点,加法的优势是优化稳定性而不是本表更高分。原表 uncapped gated 的负号与 clipped gated 写法需谨慎复核代码;此处忠实保留,不擅自改成推测实现。
原 Table 3:换评估器,暴露目标过拟合
| 优化模型 | CLIP B/32 检索 | CLIP B/16 检索 | LiTuu B/32 检索 |
|---|---|---|---|
| COCO GT | 77.1 ± 3.4 | 79.1 ± 3.3 | 75.2 ± 3.5 |
| CLIP B/32 | (86.6 ± 2.0) | 74.2 ± 2.5 | 42.8 ± 2.8 |
| CLIP B/16 | 59.8 ± 2.8 | (93.5 ± 1.4) | 35.6 ± 2.7 |
| LiTuu B/32 | 59.5 ± 2.8 | 66.7 ± 2.7 | (88.9 ± 1.8) |
括号为同一编码器优化和检索,即使相机仰角留出仍容易过拟合。Table 1 的 B/16→LiT 行为 34.6,Table 3 为 35.6,原文存在 1.0 点差异,保留原值并标记,不合并成“统一正确值”。所有误差范围按原表转录,不自行改名为置信区间。没有 ground-truth 3D,R-Precision 不是几何质量、可重光照性或人类偏好的直接度量。
07 · 组合泛化与完整图证据
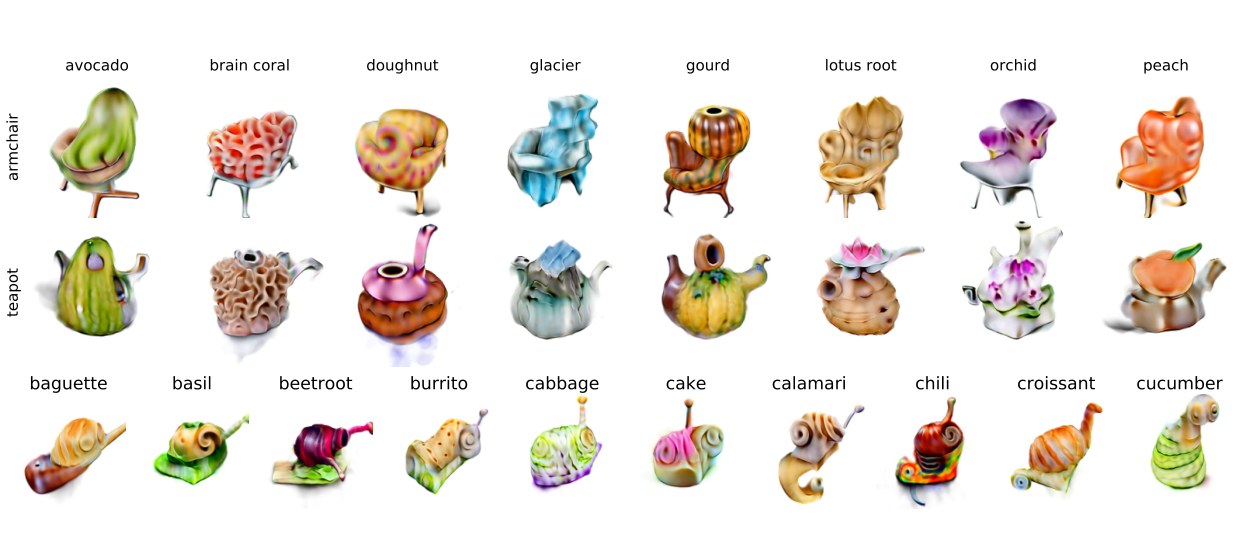
Figure 6 以 “armchair in the shape of an avocado. armchair imitating avocado.” 等模板交叉改变对象与外形;蜗牛以 “a snail made of baguette. a snail with the texture of baguette” 改变材质。作者声明这些展示未挑选,但没有全面组合成功率。眼柄长在壳上与模糊花瓶提醒我们:词汇组合成功不等于正确对象解剖。
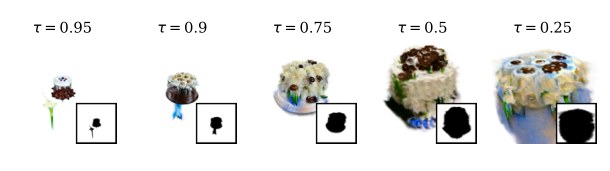
Figure 7 从 0.95、0.9、0.75、0.5 到 0.25 改变透明度。它主要控制投影占据率和大小,不是语义形状参数;相机距离和焦距变化时需要一起调整。
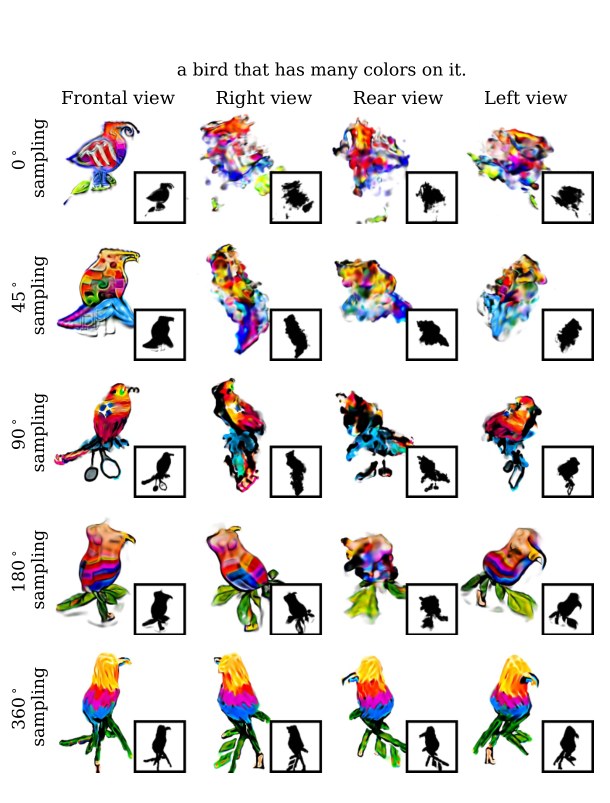
Figure 8 的单视角方案从正面看可接受,从侧后方崩坏;360° 采样有助多视角一致。证据支持增加观察覆盖,而非保证未采样的所有仰角几何正确。
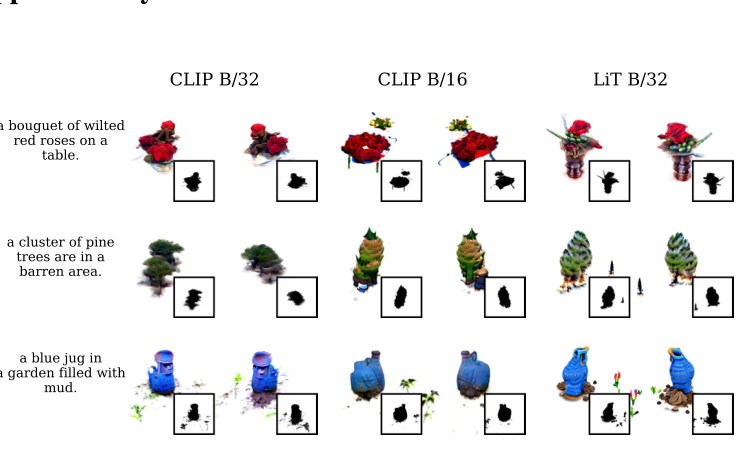
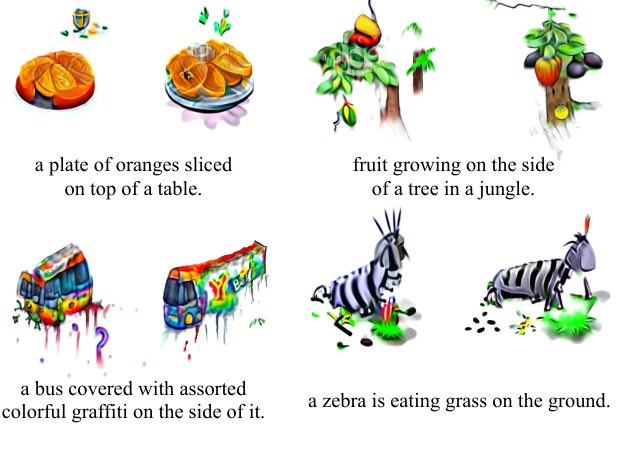
附录 Figure 9:LiT 引导通常更锐利,尽管检索表未必占优。Figure 10:改随机种子会同时改变初始化、相机与背景、crop,得到不同形状布局;因此不能把变化仅归因于初始 latent,也没有单独的 diversity metric。
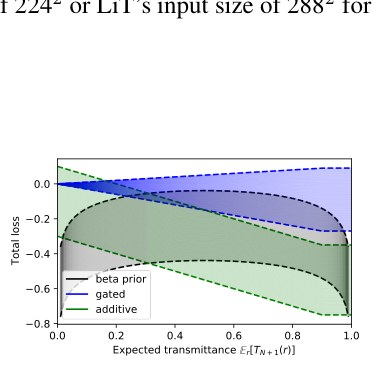
Figure 11:固定 CLIP 标量时比较稀疏 loss 形状。加法对透射率的单调趋势更稳定;图中范围按原图保留,不能据此宣称高维训练有全局收敛保证。
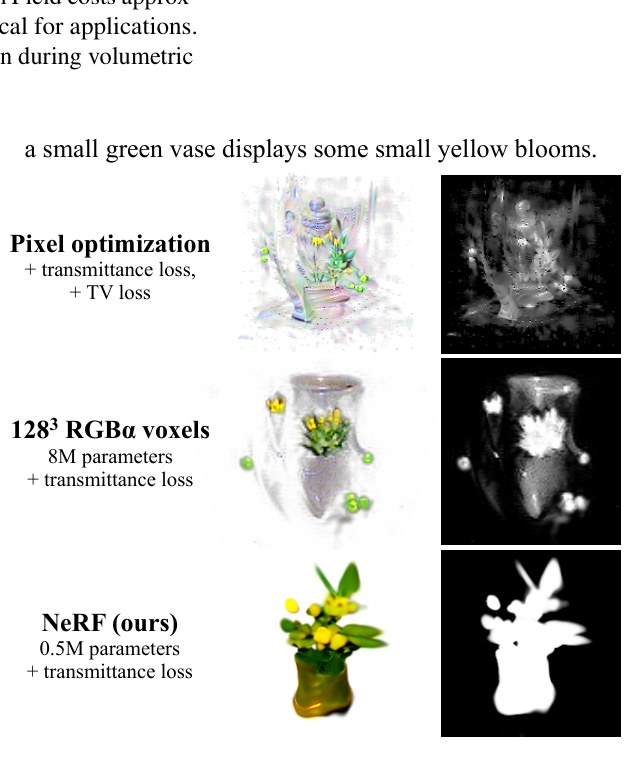
附录 D 比较直接 RGBα 像素、128³ RGBα voxel 与 NeRF。像素不能多视角渲染;体素即便用了透明度、增强和边界仍有云状伪影。体素 37.0 ± 3.9,对照 NeRF 59.8 ± 2.8,提升 22.8 点。图标注 voxel 8M、NeRF 0.5M、16 倍差异;这与正文改造 MLP 280K 是不同表述 / 对照配置,不把 16 倍强行套到 280K。
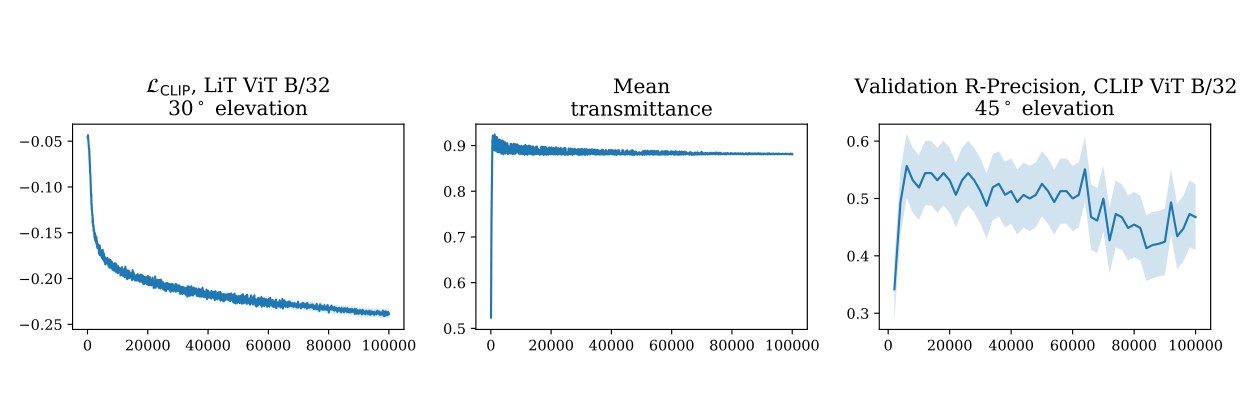
附录 F 的 79 个手写提示词长跑至 100K:训练相似度继续改善,独立 CLIP 检索约 5–10K 后下降,透明度保持在目标附近。更久优化会添细节,也会出现与 typographic attack 类似的漂浮文字。因此“更多步更好看”和“跨评估器更泛化”不是同一目标。
附录 E:SDF 替代表示
\[ \sigma(\mathbf{x})=\alpha\Phi_{\beta}(-d_{\Omega}(\mathbf{x})) \]
\(d_{\Omega}\) 是 SDF,\(\Phi_{\beta}\) 是 Laplace CDF,\(\alpha\) 控制密度尺度。这是作者早期 VolSDF 实验,可自动微分求法线,可能改善表面提取;Eikonal loss 新增权重需调参。只有定性正向描述,没有与主方法等预算的系统表格,不能声称已证明表面质量提升。
08 · Reviewer:证据层级与后续研究
Paper Verified:无需新的三维监督就能优化出许多可辨认对象;随机背景与截断透明度组合显著改善检索;场边界、网络架构和视角覆盖有用;目标编码器过拟合可通过异构检索器与长训练曲线观察。
Author Claim:大规模图文预训练的进步可能迁移到三维生成;简单先验足以获得“realistic”几何。前者得到有限 LiT 对照支持,后者缺少广泛三维真值与用户研究,且已展示失败例。
Our Interpretation:最有价值的是“可微表示+外部语义打分+防作弊结构约束”范式,而不只是 CLIP 接 NeRF。物体性来自可控的假设集合。R-Precision 与人眼质量分歧显示,优化目标和评估器即使不同,也可能共享预训练数据偏差。
- 优势:输入接口开放,避免昂贵三维配对数据;密度场共享多视角;机制有累计消融、专门正则消融、跨模型对照与长期过拟合分析。
- 不足:每个物体单独优化成本高;固定仰角和同描述各视角会出现重复正脸 / 图案;空间关系与多对象场景弱;颜色和照明未解耦;没有可编辑材质图或完整资产导出。
- 公平性:缺乏具有相同开放类别能力的强生成基线,主要证明自身组件而非相对所有 text-to-3D 系统领先。不同编码器的训练数据、分辨率、patch size 与计算量耦合。
- 安全与偏差:作者承认继承图文预训练偏见;语义优化也可能偏向社会刻板印象,本文没有实测偏差消除方案。
Research Extension:向程序化材质迁移时必须改什么
可把场参数替换成已知材质图的连续参数,通过可微执行器和多光照、多视角渲染获得语义梯度;但 Dream Fields 本身没有节点类型预测、拓扑生成、图有效性检查或 Substance 执行。若要生成图拓扑,需要另加离散搜索与编译验证,不能假称 NeRF 方法已经解决。
建议可验证实验:固定材质图和预算,比较单视角 CLIP、跨视角平均、跨光照平均与最差视角目标;同时用异构编码器、人类偏好和渲染一致性评估。进一步将视角相关描述与统一身份约束结合,检验重复面纹理是否下降;以早停和编码器集成检验是否减少漂浮文字。以上均为研究设想,未由本文实验完成。
09 · 来源、复现边界与归档说明
- CVPR 2022 正文 PDF:全部主文 1–8 节、原 Figure 1–8、Table 1–3、公式 (1)–(11)
- 官方 supplemental 合订本:仅第 11–13 页是新增附录,覆盖 A–F、Figure 9–13
- 作者项目与代码入口;arXiv 记录只用于交叉识别,不替换固定来源
已阅读全文与附录、逐表重建、内嵌原图、静态检查公式和文件体积。未运行训练或模型,未声称复现作者结果。图由固定 PDF / 官方附录裁切,未确认同版本的稳定独立图片 URL,故内嵌优化 JPEG。浏览器 MathJax、导航、实际图片加载和 1440/760/390px 布局检查按本批次要求延后。
归档仅生成保留原字节前缀的候选:旧笔记“text to textured mesh 的最早的文章”保留,但这次补充明确输出为 radiance field,且“最早”不能由单篇论文证明。通讯作者 Ajay Jain 已由首页核实;第一作者与通讯同一人应展示一次带星号。People、分类与索引的拟议修改另列计划,未直接写入仓库。